❌

Vue normale

Wikidata : le Wikipédia de la donnée structurée apprécié des LLM
Wikidata : le Wikipédia de la donnée structurée apprécié des LLM

Tout le monde connaît Wikipédia. Mais connaissez-vous Wikidata ?

Wikidata fait partie de la longue liste de projets gérés par la Fondation Wikimedia, au même titre que Wikipédia, Wikimedia Commons ou Wiktionnaire. Là où Wikipédia stocke de la connaissance sous forme de texte, donc de donnée non structurée, Wikidata fait exactement l'inverse : il stocke et expose des entités liées entre elles. Cela revient à construire un immense graphe de connaissance, dans lequel chaque personne, organisation, lieu ou concept est relié aux autres par des attributs lisibles par une machine.

Wikidata, qu'est-ce que c'est exactement ?

Wikidata est une base de connaissance libre, collaborative et multilingue. Chaque entité y porte un identifiant unique : un Q pour les éléments (Q42 pour Douglas Adams, par exemple) et un P pour les propriétés (P50 pour l'auteur, P19 pour le lieu de naissance). En assemblant ces briques, on obtient des affirmations du type sujet, prédicat, objet : ce que le monde de la donnée appelle un triplet RDF.

Wikidata : le Wikipédia de la donnée structurée apprécié des LLM

Le volume donne le vertige. Wikidata dépassait déjà 1,5 milliard de triplets sémantiques à la mi-2024 [1]. Et toute cette donnée n'est pas seulement consultable à la main : elle est interrogeable par requête, via un point d'accès SPARQL public [2]. On peut ainsi demander « tous les écrivains français nés à Nantes » et obtenir une réponse exploitable, là où une recherche classique ne renverrait qu'une liste de pages à lire.

#!/usr/bin/env bash
# Liste les écrivains nés à Nantes via le point d'accès SPARQL de Wikidata.
# Dépendances : curl et jq.

ENDPOINT="https://query.wikidata.org/sparql"

# Q5 = être humain, P106 = occupation, Q36180 = écrivain,
# P19 = lieu de naissance, Q12191 = Nantes.
QUERY='SELECT ?ecrivain ?ecrivainLabel WHERE {
  ?ecrivain wdt:P31 wd:Q5 ;
            wdt:P106 wd:Q36180 ;
            wdt:P19 wd:Q12191 .
  SERVICE wikibase:label { bd:serviceParam wikibase:language "fr,en". }
}
ORDER BY ?ecrivainLabel'

# Wikimedia impose un User-Agent descriptif, sous peine de blocage (HTTP 429).
curl -s -G "$ENDPOINT" \
  --data-urlencode "query=$QUERY" \
  -H "Accept: application/sparql-results+json" \
  -H "User-Agent: Geeek-demo/1.0 (https://www.geeek.org)" \
  | jq -r '.results.bindings[].ecrivainLabel.value'

Comment fonctionne Wikidata ?

Sur le fond, Wikidata est une base de données orientée graphe, alimentée par des contributeurs et des imports automatisés. Sa logique n'est pas isolée : elle appartient à la même famille que les données structurées que l'on retrouve aujourd'hui sur une majorité de pages Web, ces blocs JSON-LD qui décrivent un article, une FAQ ou une organisation au format Schema.org.

C'est le même esprit, celui du Linked Open Data : décrire le monde de façon explicite pour que les machines le comprennent sans deviner. Quand vous injectez un JSON-LD sur l'une de vos pages, comme je l'ai détaillé dans mon article sur les microdonnées FAQ en JSON-LD, vous appliquez cette logique à l'échelle d'une page. Wikidata l'applique à l'échelle de la connaissance mondiale.

Pourquoi les LLM apprécient autant Wikidata ?

Pour construire un modèle de langage, il faut de la connaissance, et surtout de la connaissance de haute qualité si l'on veut limiter les hallucinations au moment des requêtes. Or la donnée disponible sur Internet est partout : sites de presse, blogs, forums, dépôts de code comme GitHub pour le monde informatique, et bases ouvertes comme Wikipédia pour la connaissance du monde.

Chaque source possède un niveau de fiabilité différent. Un modèle considérera spontanément une fiche Wikipédia comme plus solide qu'un message de forum. Wikidata pousse ce raisonnement un cran plus loin : la donnée y est non seulement fiable, mais déjà structurée et reliée. Pour un LLM, c'est la différence entre lire un paragraphe et consulter une fiche prête à l'emploi.

Trois usages expliquent cet engouement :

  • Wikidata alimente le Knowledge Graph de Google, donc les fameux encarts de connaissance affichés à droite des résultats [3].
  • Wikidata figure parmi les bases de connaissances ouvertes les plus réutilisées pour entraîner et ancrer les modèles de langage [4]. Une entité bien décrite y a davantage de chances d'être reconnue, correctement attribuée et citée avec assurance.
  • Wikidata est interrogeable en direct par les agents, via SPARQL, pour aller chercher un fait vérifié au lieu de le reconstituer de mémoire.

Vous comprenez pourquoi cette base pèse lourd dans une stratégie de Generative Engine Optimization (GEO). Être présent et bien décrit dans Wikidata, c'est exister proprement dans l'écosystème qui nourrit l'IA, et cela d'un seul coup pour de nombreux systèmes à la fois.

Tout le monde peut-il entrer dans Wikidata ?

C'est là que je m'étais trompé. Je pensais au départ que Wikidata était au moins aussi sélectif que Wikipédia, et qu'une « notoriété publique » était indispensable. En réalité, c'est l'inverse : les critères d'admissibilité de Wikidata sont volontairement plus souples [5].

Un élément est accepté dès lors qu'il remplit au moins un de ces trois critères :

  1. Il possède un lien valide vers une page d'un projet Wikimedia (un article Wikipédia dans n'importe quelle langue, une catégorie Commons, une page Wikisource, etc.). Si vous disposez déjà d'une fiche Wikipédia, même dans une langue exotique, vous êtes automatiquement admissible.
  2. Il désigne une entité clairement identifiable, matérielle ou conceptuelle, que l'on peut décrire à l'aide de sources sérieuses et publiquement accessibles. C'est le critère le plus accessible, et celui que remplissent la plupart des personnes et organisations. Les identifiants délivrés par des tiers faisant autorité (VIAF, ISNI, identifiant BnF, GND, registres officiels) renforcent fortement cette admissibilité. Attention toutefois : un identifiant que l'on alimente soi-même, comme un ORCID, constitue un signal beaucoup plus faible aux yeux des administrateurs.
  3. Il répond à un besoin structurel, c'est-à-dire qu'il rend plus utiles les affirmations portées par d'autres éléments. L'auteur d'un ouvrage référencé, le développeur d'un logiciel notable ou le membre d'une organisation connue entre dans cette catégorie.

La barre est donc plus proche de « existence vérifiable » que de « célébrité ». Deux nuances méritent toutefois d'être posées clairement. D'abord, le critère 2 reste volontairement flou, au point de faire l'objet de discussions de réforme au sein de la communauté [6]. Ensuite, et c'est le point important, l'auto-promotion est explicitement découragée. Créer soi-même son propre élément relève du conflit d'intérêts [7], et un élément sans la moindre source finit supprimé. L'admissibilité large ne signifie pas absence de garde-fous.

Mon retour d'expérience

Je ne vais pas vous faire la leçon, car je me suis pris ce mur en pleine figure. J'ai tenté de créer ma propre entité Wikidata, ainsi que celle du blog. Quelques jours plus tard, un administrateur (Madamebiblio) a supprimé les deux fiches indiquant que celles-ci ne répondent pas aux exigences de notabilité [5:1].

Avec le recul, le verdict était écrit d'avance, et il illustre exactement les garde-fous décrits plus haut. En créant moi-même ces éléments, je me plaçais d'emblée en situation de conflit d'intérêts, ce que la communauté décourage explicitement. Et mes fiches manquaient de ce qui fait tenir un élément : non pas mes propres profils ou mon propre site, mais des sources indépendantes et des identifiants d'autorité délivrés par des tiers. Un ORCID que l'on remplit soi-même ne prouve rien aux yeux d'un administrateur. Une notice BnF ou VIAF, générée parce qu'une bibliothèque a catalogué un ouvrage publié, pèse infiniment plus lourd. La leçon est claire : sur Wikidata, on ne décrète pas sa propre notoriété, on la laisse se constater par des traces externes que l'on ne contrôle pas.

Conclusion

Wikidata est sans doute l'un des projets les plus sous-estimés de la galaxie Wikimedia. Invisible pour le grand public, il est pourtant devenu une couche d'infrastructure essentielle : il structure la connaissance, alimente les moteurs de recherche et nourrit les modèles de langage. Pour quiconque travaille la visibilité de ses contenus à l'ère de l'IA, comprendre Wikidata n'est plus une curiosité d'érudit, c'est un sujet de fond.

Ce sujet vous intéresse ? N'hésitez pas à passer sur le serveur Discord Geeek.


  1. Estimation de mi-2024, en croissance constante depuis. Les compteurs à jour (nombre d'éléments et de triplets) figurent sur la page Wikidata:Statistics. ↩︎

  2. Point d'accès SPARQL public de Wikidata : https://query.wikidata.org ↩︎

  3. Google a fermé Freebase, qui alimentait historiquement son Knowledge Graph, et en a migré les données vers Wikidata à partir de 2015. Voir Thomas Pellissier Tanon et al., « From Freebase to Wikidata: The Great Migration », WWW 2016, ainsi que la fiche Freebase : https://en.wikipedia.org/wiki/Freebase_(database) ↩︎

  4. Wikidata est régulièrement citée parmi les bases ouvertes réutilisées pour entraîner ou ancrer les modèles. La composition précise des corpus d'entraînement reste cependant rarement documentée publiquement par les laboratoires. ↩︎

  5. Politique de notoriété de Wikidata : https://www.wikidata.org/wiki/Wikidata:Notability ↩︎ ↩︎

  6. L'interprétation du critère 2 fait l'objet de discussions au sein de la communauté. Voir Wikidata:Requests for comment/Notability policy reform (https://www.wikidata.org/wiki/Wikidata:Requests_for_comment/Notability_policy_reform) et la refonte de 2015, Notability overhaul (https://www.wikidata.org/wiki/Wikidata:Requests_for_comment/Wikidata:Notability_overhaul). ↩︎

  7. La politique précise que créer un élément sur soi-même, ses proches ou son entreprise n'est pas autorisé, afin d'éviter tout conflit d'intérêts. Voir Wikidata:Requests for comment/Conflict of Interest : https://www.wikidata.org/wiki/Wikidata:Requests_for_comment/Conflict_of_Interest ↩︎
Digitalgia

21 juin 2026 à 13:00

After the investigation of nostalgia, I felt that I was close to identifying the concept that I was looking for. It had to be a concept that embraced an em-placed, chronic, and painful emotion in the face of negatively experienced environmental change, and I did not want to simply add “eco” in front of some existing form of distress. With the help of Jill Albrecht, I explored the pairings of words with the algia, pain or distress, that was at the heart of this issue. Two concepts seemed to me to be very close to what I was searching for: solace and desolation.

Earth Emotions (New Words for a New World), Glenn A. Albrecht

Je pense qu’il faut inventer de nouveaux mots décrivant de nouvelles émotions. Je suis allé lire Glenn A. Albrecht à la source pour découvrir le processus de définition de solastalgia et ceci est ma contribution, une tentative de description d’un monde qui évolue. Une partie de mon monde qui m’a fait évoluer et rencontrer des personnes ces dernières décennies.

Digitalgia donc, comme la souffrance ressentie lorsqu’on passe d’un univers numérique de la création à celui de l’oppression. Et des sentiments de peur et d’incapacité à inverser la tendance associés à cette évolution. Le trainSUV du progrès est en marche et le vélo de la raison est à la traîne. Le capitalisme est venu grignoter un espace d’expressions et d’échanges, morceau par morceau, pour ne laisser qu’un panoptique optimisant la consommation, la croissance et incitant à brûler la dernière goutte d’hydrocarbure disponible. Pour les personnes qui ont été les témoins de la création de ces espaces numériques, la peine peut s’apparenter à une forme de deuil et se traduire par un comportement dépressif.

Il y a aussi la tristesse de savoir que les nouvelles générations sont dans l’incapacité de penser qu’un tel environnement ait pu être possible à un moment donné compte-tenu de ce qui leur est proposé aujourd’hui. Au même titre que je ne peux penser une forêt plus vivante que celle dans laquelle j’évolue aujourd’hui, ou des mers moins dévastées que celles de mon enfance. Le mythe est puissant mais n’incite pas à la même frustration, au même passage à l’action, car le sentiment de perte est alors différent.

Note : je ne pense pas qu’il soit pertinent de traduire ce terme en « digitalgie » comme cela a pu être le cas avec « solastalgie » car la terminaison en IA me semble être d’autant plus pertinente dans ce contexte…

I define “solastalgia” as the pain or distress caused by the ongoing loss of solace and the sense of desolation connected to the present state of one’s home and territory. It is the existential and lived experience of negative environmental change, manifest as an attack on one’s sense of place. It is characteristically a chronic condition, tied to the gradual erosion of identity created by the sense of belonging to a particular loved place and a feeling of distress, or psychological desolation, about its unwanted transformation. In direct contrast to the dislocated spatial dimensions of traditionally defined nostalgia, solastalgia is the homesickness you have when you are still located within your home environment.

Ibid.


Réagir ?

🔗 Look, just fucking use Mastodon already

18 juin 2026 à 13:24

Arilin Thorferra
https://giants-club.net/articles/just-use-mastodon/

Who could have predicted Bluesky could ever have run that risk? I mean, apart from everyone warning us that it was launched by weirdo alt-right blockchain-shilling AI-loving shitbird Jack Dorsey, and that their current CEO came from a weirdo alt-right blockchain-shilling AI-loving shitbird background. You know. Besides them.

Brèves d’audit #2 : intitulé de lien, « lien vers »

18 juin 2026 à 08:42
Cas concret d'un audit d'accessibilité numérique : quelle recommandation pour rédiger l'intitulé d'un lien « lien vers » ?

∪ of Target Audiences (Accessibility, SEO, AEO/GEO)

15 juin 2026 à 20:27

Using SEO (search engine optimization) to justify accessibility was only ever a technique for bosses or clients or stakeholders who see accessibility as a cost center and are typically driven more by dashboards or money. Ideally, you want to get past that ASAP to drive better outcomes for humans, not SERPs (search engine results pages). I get it as a foot-in-the-door tactic — hopefully it goes no further.

But SEO also drove bad accessibility practices, such as alt text keyword stuffing, low-contrast text, verbose headings, link text built around keywords, gratuitous landing pages, and more. Karl does a good job of demonstrating how little SEO and accessibility are connected. As such, I’ve always been wary of companies pitching accessibility and SEO in their marketing.

Now I see companies pitching accessible & “AI-ready” or “agent friendly” work, often still including SEO. I’m calling foul.

Venn diagram with three circles. 1, Accessibility: The work needed to make things accessible to humans in assorted contexts. 2, SEO: The work needed to get your sites into search engines and maybe even ranked well. 3, AEO/GEO: The work to get your IP stolen by LLMs as they DDoS your site, so it can be later incorrectly regurgitated. Overlap with Accessibility and SEO: With bonus per­for­ma­tive use of the term “a11y.” Overlap of SEO and AEO/GEO: This is someone tricking you into speed-running having your IP stolen. There is no overlap of Accessibility and AEO/GEO nor all three.

We’ve already seen anti-user guidance from LLM companies asking for their notion of accessible sites. Never mind that these PhD-level genius LLM tools can’t handle a general site most kids navigate with ease. Let’s ignore the failure of that technology and instead start slapping misunderstood ARIA attributes on all our pages instead.

Sure, there’s overlap between SEO and LLM-thieving. SEO and accessibility even have slight overlap. But accessibility is about people. Twisting a human affordance to feed these corporate efforts to make humans redundant (among all the other harms) is a signal. Different people will read that signal in different ways. If it sells work and you still focus on humans first, cool.

But to me that signal says you aren’t serious about the work. That your TESCREAL patch is just waiting to get sewn on. I’m trying to be less absolutist, less black-and-white. But boy is it hard given what I see every time I peel back the veneer.

I made a thing (based on an old experiment) to better illustrate where I see the overlaps.

See the Pen Accessibility + SEO + AEO by Adrian Roselli (@aardrian) on CodePen.

Khrys’presso du lundi 15 juin 2026

Par : Khrys
15 juin 2026 à 07:42

Comme chaque lundi, un coup d’œil dans le rétroviseur pour découvrir les informations que vous avez peut-être ratées la semaine dernière.


Tous les liens listés ci-dessous sont a priori accessibles librement. Si ce n’est pas le cas, pensez à activer votre bloqueur de javascript favori ou à passer en “mode lecture” (Firefox) ;-)

Brave New World

RIP

Spécial IA

Spécial guerre(s) au Moyen-Orient

Spécial femmes dans le monde

Spécial France

Spécial femmes en France

Spécial médias et pouvoir

Spécial emmerdeurs irresponsables gérant comme des pieds (et à la néolibérale)

Spécial recul des droits et libertés, violences policières, montée de l’extrême-droite…

Spécial résistances

Spécial outils de résistance

Spécial MAGAM et cie

Les autres lectures de la semaine

Les BDs/graphiques/photos de la semaine

Les vidéos/podcasts de la semaine

Les trucs chouettes de la semaine

Retrouvez les revues de web précédentes dans la catégorie Libre Veille du Framablog.

Les articles, commentaires et autres images qui composent ces « Khrys’presso » n’engagent que moi (Khrys).

Fermeture de dialog avec l'attribut closedby

Par : Rodolphe
13 juin 2026 à 13:00

Pour rappel <dialog> permet de créer des boîtes de dialogue (modales, popups, popins, elles ont tant de noms) en HTML sans plus avoir à tout gérer en CSS+JavaScript pour positionner un élément <div> en absolu.

Et on a aussi connu cela : une popin qui se ferme quand on appuie sur echap alors qu'on voulait forcer l'utilisateur à valider un formulaire, ou à l'inverse une modale qu'on ne peut fermer qu'avec un bouton alors qu'un clic en dehors serait tellement plus naturel. Jusqu'ici, la solution consistait à empiler du JavaScript pour gérer ça à la main.

Désormais, un simple attribut HTML suffit.

Mentionné par Una Kravets et Bramus Van Damme à la Google I/O 2026.

Comment ça marche ?

L'attribut closedby s'ajoute directement sur l'élément <dialog> et accepte trois valeurs :

  • any — le dialogue se ferme via la touche Échap, un geste natif (retour arrière sur mobile), ou un clic en dehors (correspond à ce qu'on appelle un light dismiss).
  • closerequest — fermeture via la touche Echap ou geste natif uniquement, pas de clic en dehors. C'est le comportement par défaut d'une modale ouverte avec showModal().
  • none — fermeture uniquement via code (bouton, soumission de formulaire…), aucune alternative native.

Exemples rapides :

<!-- On peut cliquer à côté pour fermer -->
<dialog closedby="any">
  <p>Aperçu rapide, fermable au moindre clic extérieur.</p>
  <button onclick="this.closest('dialog').close()">Fermer</button>
</dialog>
<!-- Aucune fermeture "accidentelle" possible -->
<dialog closedby="none">
  <p>Formulaire critique. On ne vous laisse pas esquiver comme ça.</p>
  <button onclick="this.closest('dialog').close()">Valider et fermer</button>
</dialog>

Et sans closedby ?

Si l'attribut est absent ou invalide, le navigateur applique un comportement automatique : - showModal() → se comporte comme closedby="closerequest" (Echap fonctionne). - show() ou attribut open → se comporte comme closedby="none" (rien ne ferme sans code).

Autrement dit, rien ne change pour vos éléments existants. Ouf la rétrocompatibilité.

Compatibilité navigateurs

À ce jour, le support atteint environ 70 % de couverture globale d'après Caniuse ce qui est encourageant mais insuffisant pour un usage en production sans y réfléchir.

Navigateur Support
Chrome / Edge ✅ depuis la version 134
Firefox ✅ depuis la version 141
Opera ✅ depuis la version 119
Safari (macOS & iOS) ❌ pas encore supporté

🐌 Safari reste en retrait... et tant que ce n'est pas supporté un fallback JavaScript pour le light dismiss peut faire l'affaire :

// Fallback pour les navigateurs sans closedby="any"
document.querySelectorAll('dialog[closedby="any"]').forEach((dialog) => {
  document.addEventListener('click', (e) => {
    if (dialog.open && !e.composedPath().includes(dialog)) {
      dialog.close();
    }
  });
});

Accessibilité

L'attribut closedby agit uniquement sur la fermeture, il ne modifie pas la sémantique de l'élément. Les bonnes pratiques habituelles restent donc :

  • closedby="any" : le clic en dehors ferme la boîte de dialogue, vérifiez que ce comportement est prévisible pour les utilisateurs de lecteurs d'écran. Un clic accidentel à côté d'un formulaire partiellement rempli peut surprendre. Réservez cette valeur aux interactions légères et non critiques (petites popups d'information ou de prévisualiation).
  • closedby="none" : si l'utilisateur ne peut pas fermer via la touche Échap ni en cliquant en dehors, il doit impérativement y avoir un bouton de fermeture, accessible au clavier et aux technologies d'assistance.
  • Gestion du focus : à l'ouverture, le focus doit aller dans la modale ; à la fermeture, il doit revenir sur l'élément déclencheur (qui a ouvert la modale, par exemple un bouton).
  • Libellé/titre : pensez à aria-labelledby (pointant vers le titre) et éventuellement aria-describedby pour les descriptions. L'élément <dialog> expose déjà le bon rôle ARIA, mais sans nom accessible les lecteurs d'écran annoncent une boîte de dialogue anonyme.

Publié par Alsacreations.com

headingoffset is Not the Document Outline Algorithm

11 juin 2026 à 23:26

Hi, just me heading off some bad advice I’m starting to see in developer venues.

Background

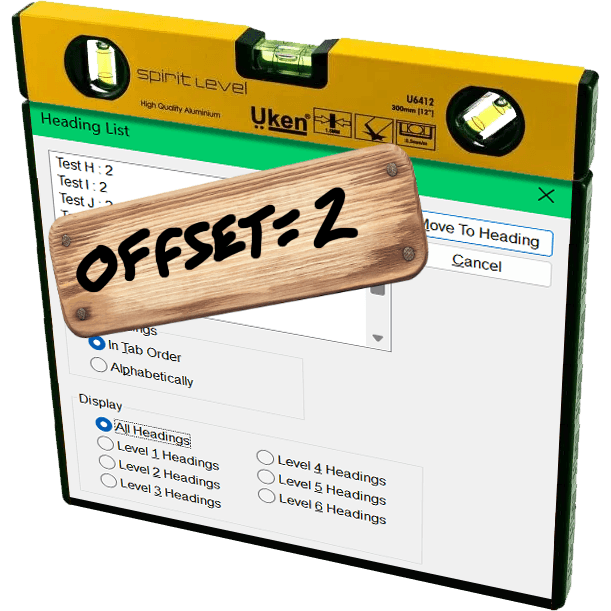
The JAWS heading list dialog with a yellow three-in-one surface level resting on top and a board nailed over it with hand-scrawled ‘offset=2’.

The proposed Document Outline Algorithm, where headings would automatically reset themselves to the appropriate level based on their position in the DOM structure, was never part of a final HTML specification. It was quickly proven to be unworkable; brief support in JAWS demonstrated that. You can read the tortured history (and a JAWS support demo) in my 2016 post There Is No Document Outline Algorithm.

In 2019 WHATWG worked to resurrect <hgroup>, partly in a novel effort to try to resurrect the Document Outline Algorithm. In the end, even that effort was futile. <hgroup> came back, but it came back as a grouping element only. The only impact it has on heading structures is that browser could, if they really wanted, ignore other headings in the same <hgroup>.

In 2020, Steve Faulkner wrote about the doc-subtitle role, from the Digital Publishing WAI-ARIA Module 1.0, as a way to handle subtitles until <hgroup> found its new footing. Sadly, a cadre of authors thought that role could be the basis for the Document Outline Algorithm.

Authors very much want to make the browser decide heading levels for them. Authors also very much continue to write content and HTML structures that make that impossible.

So I wasn’t surprised when Firefox’s recent announcement of headingoffset support coming to Firefox behind a flag resulted in many cheering the “return” (irony quotes) of the Document Outline Algorithm.

But it isn’t.

headingoffset

The headingoffset attribute lets authors offset heading levels for descendants of a given node.

So if you have, say a dialog that starts at <h2>, you could add headingoffset="2" and then let it pull in (server-side or via your preferred user-slowing front-end tooling) another page that uses <h1> as its first heading, you can be comfortable knowing that <h1> will be treated as <h3> in the accessibility tree.

This can be handy for content re-use without authors needing to make every heading a variable or burning down the DOM each time to forcibly re-write them.

But it’s still the author’s job to make an intentional and good decision. The browser will know nothing more about your content or structure than it did before. And it certainly doesn’t reduce WCAG risk.

Other useful nuggets:

  • headingoffset values must be valid non-negative integers.
  • headingoffset values must be between 0 and 8.
  • headingoffset values greater than 8 are specified to max at level 9, but existing bugs may impact that.
  • Other invalid headingoffset values should fall back to level 2, but again, bugs and implementation decisions wil impact that.
  • headingreset is a boolean attribute that tells browsers to ignore headingoffset for that node and its descendants.
  • Do not use headingoffset until you can confirm support for the computed heading level in your target audience browser.

Recap

  1. headingoffset is not the (nor any) Document Outline Algorithm, nor does it replicate it.
  2. headingoffset requires the author to make decisions based on content.
  3. Until JAWS and TalkBack fix existing bugs, probably don’t do / allow any heading levels higher than 6.
  4. Don’t do / allow any heading levels higher than 9.
  5. If you are hoping headingoffset will resolve your heading level problems in a hands-off way with imported or user-generated content, you may end up creating confusion and WCAG risk.
  6. Do not try to use headingoffset to try to recreate the Document Outline Algorithm.

Related

Not a ton of detail in this post, but at 500 words if you want more then here are some resources beyond what I linked:

Brèves d’audit #1 : ratio de contraste d’un lien texte

11 juin 2026 à 08:42
Cas concret d'un audit d'accessibilité numérique : sur quel critère signaler un contraste insuffisant pour le texte d’un bouton ?

Lancement du site a11yfrance.org

10 juin 2026 à 11:10

Suite au lancement de l’association a11y France en avril 2025, nous avons désormais un site web dédié : https://a11yfrance.org.

Qui sommes-nous ?

A11Y France, association de loi 1901, fédère les personnes professionnelles de l’accessibilité numérique et les personnes concernées pour un numérique véritablement accessible à toutes et tous.

L’association a été cofondée par Ideance, Temesis, Tanaguru, l’Association Valentin Haüy et la Fédération des Aveugles et Amblyopes de France. Elle compte actuellement plus de 40 membres actifs (liste à venir prochainement).

L'empire Stérin scruté par le Sénat

10 juin 2026 à 08:00

Le 4 juin dernier, Pierre-Édouard Stérin était auditionné par la commission d'enquête sénatoriale sur le financement des politiques publiques. Sous l'égide de sa présidente Sonia de la Prévôté (Union centriste) et de sa rapporteuse Colombe Brossel (Socialistes), cette commission s'intéresse au rôle croissant de l'argent privé - comme celui émanant de l'homme d'affaires d'extrême droite – dans le financement des associations et de la culture, sur fond de réduction des soutiens publics.

L'Observatoire des multinationales a publié il y a quelques mois une cartographie complète de l'empire contrôle par Pierre-Édouard Stérin, dans son volet économique comme dans ses versants philanthropiques et politiques (la frontière entre les deux étant très difficile à établir). Lire nos explications ici et là (mis à jour de février dernier).

L'année dernière, le propriétaire de la smartbox avait refusé de se rendre à son audition devant une autre commission d'enquête parlementaire, sur le financement de la vie politique. Suite à ce refus, passible de deux ans de prison et d'une amende de 7 500 euros, il a été entendu par la police judiciaire en novembre.

Cette fois-ci, il a répondu à la convocation. Il a assumé son statut d'exilé fiscal et s'est une nouvelle fois revendiqué « à droite de l'extreme droite » sur les questions de migrations. En revanche, il a esquivé toutes les questions sur le fonctionnement de son empire, par exemple sur les raisons pour lesquelles aussi bien le Fonds du bien commun que le projet Périclès sont - comme nous l'avons révélé - financés via des prêts d'autres sociétés qu'il contrôle plutôt que par des dons.

La commission d'enquête a également auditionné Arnaud Rérolle, le directeur du projet Périclès, et Edward Whalley, celui du Fonds pour le bien commun, deux antennes de l'empire Stérin, ainsi que des représentants de nombreuses structures financées par l'homme d'affaires, comme Politicae, institut de formation à destination des élus locaux, l'Institut de formation politique (son directeur Alexandre Pesey a dit à cette occasion quelques bêtises sur l'Observatoire des multinationales), Excellence ruralités, Familiya ou encore les Académies Saint-Louis.

Toutes ces auditions sont à retrouver sur le site du Sénat.

Les Sorties Marmots de la Semaine (du 5 au 11 Juin)

Par : Vincent
9 juin 2026 à 07:30

Après une semaine sans aucune sortie Marmots, les affaires reprennent et les jeux qui arrivent sentent bon l’été et les vacances… Les voyages en montgolfière et les barbecues… Les fiestas dans la jungle et les… trucs colorés à assembler. Décidément, certains ont des occupations bizarres en vacances.

Bonne semaine ludique avec vos Marmots !


Panorama

Jules Messaud & Melody Leblond

Melody Leblond

Scorpion Masqué

2 à 4 joueurs

8 ans et plus

Pose de tuiles

Voyagez en montgolfière pour récupérer les meilleures tuiles et former le plus beau des panoramas. Des mécaniques simplissimes, des illustrations toutes choupis et le plaisir simple d’assembler ses tuiles : « Panorama » est un jeu qui invite toute la famille autour de la table, joueurs comme non joueurs…

Le trouver chez

Très Futé Kids 2 : Jungle Party

Wolfgang Warsch

Glen Viljoen

Schmidt

2 à 4 joueurs

6 ans et plus

Roll & Write

« Très Futé Kids » revient pour un nouvel opus. Après avoir préparé un goûter d’anniversaire dans la première boîte, organisez la plus belle fiesta dans la jungle. À votre tour, lancez les dés, choisissez ceux d’une couleur, laissez les autres à vos adversaires, et cochez les meilleurs emplacements pour gagner un maximum d’étoiles colorées.

Le trouver chez

Kumi Kumi

Toshiki Sato

(non crédité)

Miraludo

2 à 4 joueurs

5 ans et plus

Observation/Rapidité

Dans « Kumi Kumi », soyez le plus rapide à reproduire une grille colorée, en combinant et en superposant des tuiles. Celles-ci sont composées de 2 calques de couleurs primaires, et c’est en les superposant que vous obtenez les couleurs secondaires (par exemple : Bleu + Jaune = Vert).

Le trouver chez

Miro Miro

Toru & Aiko Oyama

(non crédité)

Miraludo

2 à 6 joueurs

6 ans et plus

Observation/Estimation

Autre jeu japonais dans la même gamme que « Kumi Kumi », « Miro Miro » est bien plus abstrait abstrait pour les Marmots. Estimez la surface colorée d’une carte référence, en la comparant à toutes celles visibles sur la table. Celui qui choisit la carte qui contient la surface colorée la plus proche remporte la manche.

Le trouver chez

Barbecubes

Brett J. Gilbert & Rob Sparks

Rory Muldoon

Matagot

2 à 6 joueurs

8 ans et plus

Jeu d’adresse

Dans « Barbecubes », vous posez des saucisses et du poisson sur un barbecue. Sauf que les saucisses sont des jetons en pixel art, que le barbecue est fait de buchettes en bois et que c’est avec une petite pince que vous allez tenter de ne rien faire tomber dans les flammes.

Le trouver chez


🔗 Core Mobile Vitals: Understand how your users feel about your app

Tammy Everts
https://embrace.io/blog/core-mobile-vitals/

if you ask a mobile team “is your app healthy?”, you’ll probably get a 20-minute technical briefing that involves crash rates, ANRs, Apdex scores, CPU utilization, and a handful of other metrics that make total sense to engineers and mean absolutely nothing to everyone else in the building.

To be clear, those metrics are useful! But they don’t do what Core Web Vitals do.

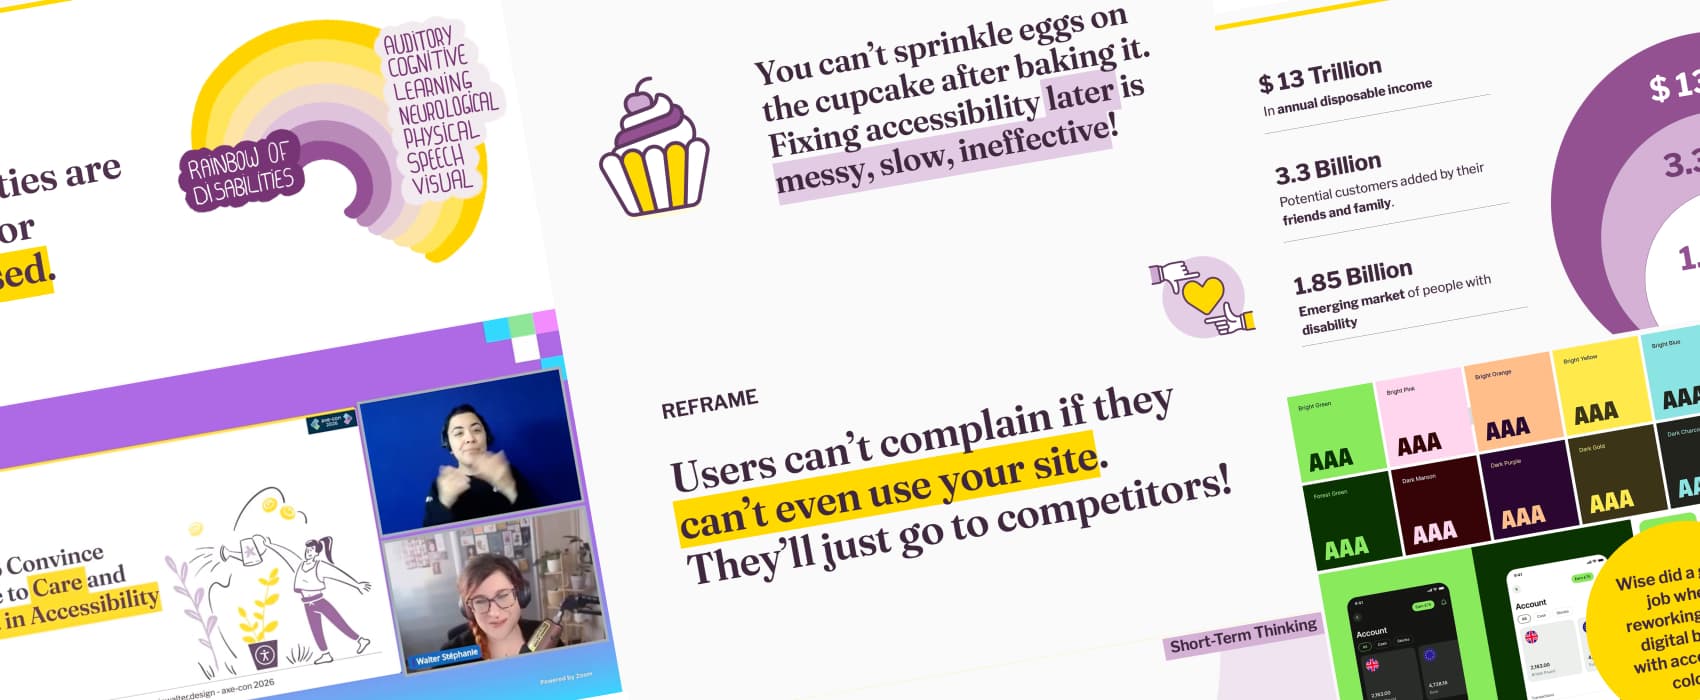
Accessibilité : 9 mythes et objections, et comment y répondre

Vous défendez l'accessibilité et vous vous heurtez à des objections ? Ce guide couvre 9 objections classiques, avec données, arguments et stratégies concrètes pour convaincre vos équipes d'investir dans l'accessibilité.

PAI 2026 : Le Tribunal des Affaires Exceptionnelles

Le mois de juin est à peine entamé que voici déjà le deuxième livre de la sélection Imaginaire du Prix des Auteurs Inconnus. Il faut dire que si le mois précédent, j’avais eu droit à un pavé de plus de 600 pages, ce mois-ci, l’œuvre dont la lecture m’a été attribuée est l’une des plus […]

L’article PAI 2026 : Le Tribunal des Affaires Exceptionnelles est apparu en premier sur De l'autre côté des livres.

Le retour de Trump, une aubaine pour Palantir

3 juin 2026 à 08:00

En 2025, le chiffre d'affaires de Palantir, multinationale spécialiste de l'analyse de données, a augmenté de 56% pour atteindre les 4,8 milliards de dollars. Cette croissance devrait se poursuivre sur le même rythme en 2026 puisque les dirigeants de l'entreprise prévoient un chiffre d'affaires pour cette année à 7,2 milliards.

Cette performance n'est pas sans rapport avec le retour au pouvoir de Donald Trump. Palantir est impliquée dans de nombreuses politiques voulues par le président américain, depuis la chasse aux migrants menée par ICE jusqu'à la politique de coupe dans les dépenses fédérales et de réduction du nombre de fonctionnaires en passant par la guerre en Iran, et en tire de juteux revenus.

Mais Palantir connaît aussi une croissance soutenue hors des États-Unis et du côté des grandes entreprises privées, y compris de nombreux champions français. Le signe que derrière sa malgré la rhétorique techno-fasciste de ses dirigeants et les nombreux scandales dans laquelle l'entreprise est impliquée, elle continue à exercer une forte séduction sur le monde économique.

Lire notre enquête complète : Palantir, la Big Tech au coeur de l'administration Trump

Les datacenters réchauffent la planète

27 mai 2026 à 09:54

Une nouvelle enquête de l'Arcep, autorité indépendante de régulation des réseaux en France, montre que la consommation électrique des datacenters a augmenté de 38% en trois ans dans le pays. Les émissions de gaz à effet de serre que génèrent ces infrastructures numériques ont bondi, quant à elles, de 44%, tandis que les consommations d'eau croissent de 16% sur la même période.

L'Arcep reconnaît des progrès en termes d'efficacité de la part des opérateurs, mais ils ne compensent pas la forte progression de la capacité informatique des nouveaux centres mis en service : « Alors que les centres ouverts en 2023 présentaient déjà une capacité informatique moyenne de 9 MW par centre, contre 3 MW pour les centres déjà installés, ceux mis en service en 2024 atteignent désormais 20 MW en moyenne. »

Et ces chiffres devraient continuer à monter en flèche si les projets actuels, tel que le datacenter annoncé par Google près de Châteauroux (lire À Châteauroux, Google avance masqué : les dessous d'un projet de data center XXL) ou le mégaprojet Campus IA porté par un fonds souverain émirati à Fouju, en Seine-et-Marne (lire MGX, le très peu rassurant fonds émirati derrière l'immense centre de données « souverain » prévu en Seine-et-Marne, voient le jour.

L'essor de l'industrie numérique a longtemps été présenté comme un facteur de dématérialisation, et donc de limitation de notre empreinte environnementale. La ruée actuelle vers la construction partout dans le monde de datacenters géants au nom de « l'intelligence artificielle » montre bien qu'il n'en est rien.

❌