Les recherches lancées depuis l'appareil photo d'un smartphone ou une capture d'écran ne se confondent plus avec les requêtes textuelles dans la Search Console.
Plus de quinze ans après la fermeture de Lycos Europe, l'éditeur ADN Contents mise sur le souvenir laissé par le portail chez les internautes des années 1990. Mais pas que.
Comme chaque lundi, un coup d’œil dans le rétroviseur pour découvrir les informations que vous avez peut-être ratées la semaine dernière.
Tous les liens listés ci-dessous sont a priori accessibles librement. Si ce n’est pas le cas, pensez à activer votre bloqueur de javascript favori ou à passer en “mode lecture” (Firefox) 😉
La centrale de Hamaoka, exploitée par Chubu Electric, se trouve dans une zone exposée au risque de méga-séisme. Les contrôles réglementaires engagés par l’autorité japonaise de sûreté portaient sur le redémarrage de deux tranches nucléaires, dans un pays où les exigences parasismiques sont au cœur de la conception des installations. L’entreprise avait reconnu en janvier avoir transmis aux autorités des éléments susceptibles de sous-estimer le risque sismique.
Recep Tayyip Erdogan, qui a proclamé en 2026 « la décennie de la famille », prend régulièrement pour cible les personnes LGBT+, qu’il qualifie de « perverses » et auxquelles il impute la chute drastique de la natalité.
Organisé par l’association italienne ultraconservatrice Pro Vita & Famiglia, l’événement doit se tenir jusqu’à ce jeudi 17 septembre. L’exposition a été inaugurée, entre autres, par Marion Maréchal, qui revient dans le giron du Rassemblement national, à l’aube de la présidentielle.
Les 30 et 31 juillet, après une déclaration manipulée et amplifiée sur les réseaux sociaux, des milliers d’exilés ont tenté de gagner l’exclave espagnole depuis le Maroc. Rapidement, une vague xénophobe s’empare de la ville et devient une caisse de résonance à l’échelle européenne. Sur place, la solidarité compose désormais avec la suspicion et le rejet.
Si ce déménagement a pu finalement démarrer, c’est notamment grâce à l’implication des habitant·es, au rachat de leur maison d’origine et à la construction d’un nouveau village pensé pour durer.
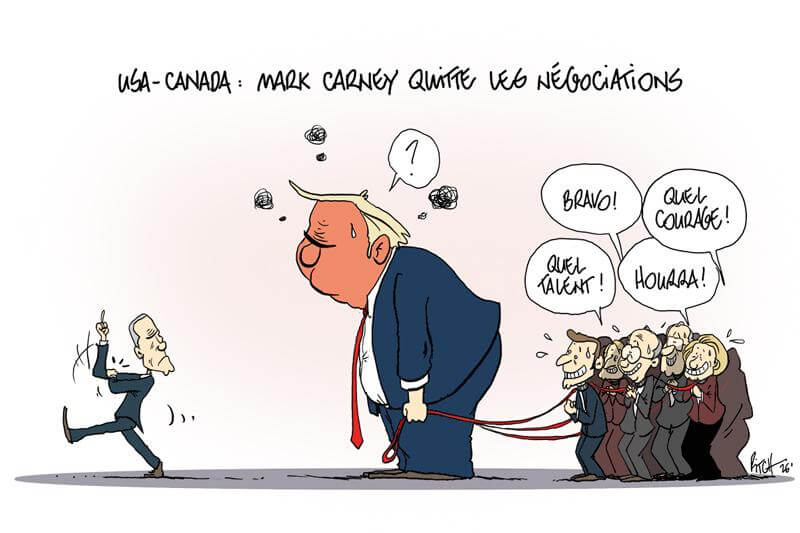
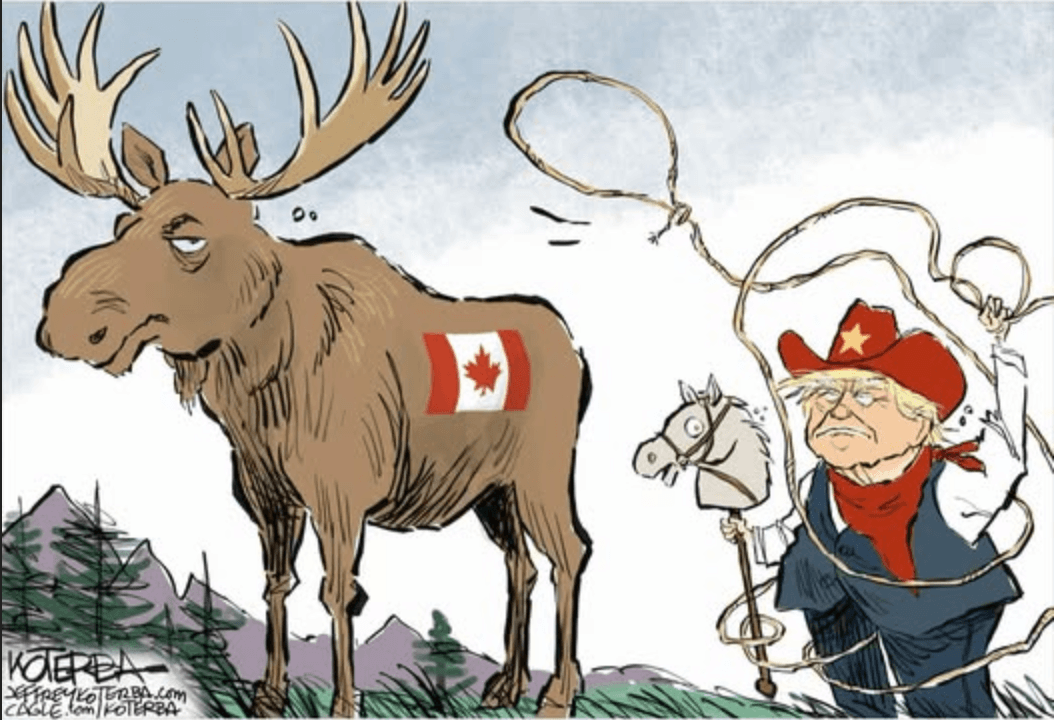
Le premier ministre canadien Mark Carney a annoncé son intention de solliciter un statut inédit de membre associé de l’Union européenne. Il ne s’agit pas non plus d’une simple lubie, puisque Ursula von der Leyen, présidente de la Commission européenne, a déjà appuyé cette idée.
La députée écologiste de Paris a récemment appelé ses collègues et les militants de gauche à quitter X pour laisser l’extrême droite « se bouffer la tronche » entre eux.
In 2021, America approved $65 billion to fund broadband internet services as part of President Biden’s Bipartisan Infrastructure Law. But Trump’s administration announced they’d withhold funds from states with net neutrality protections…
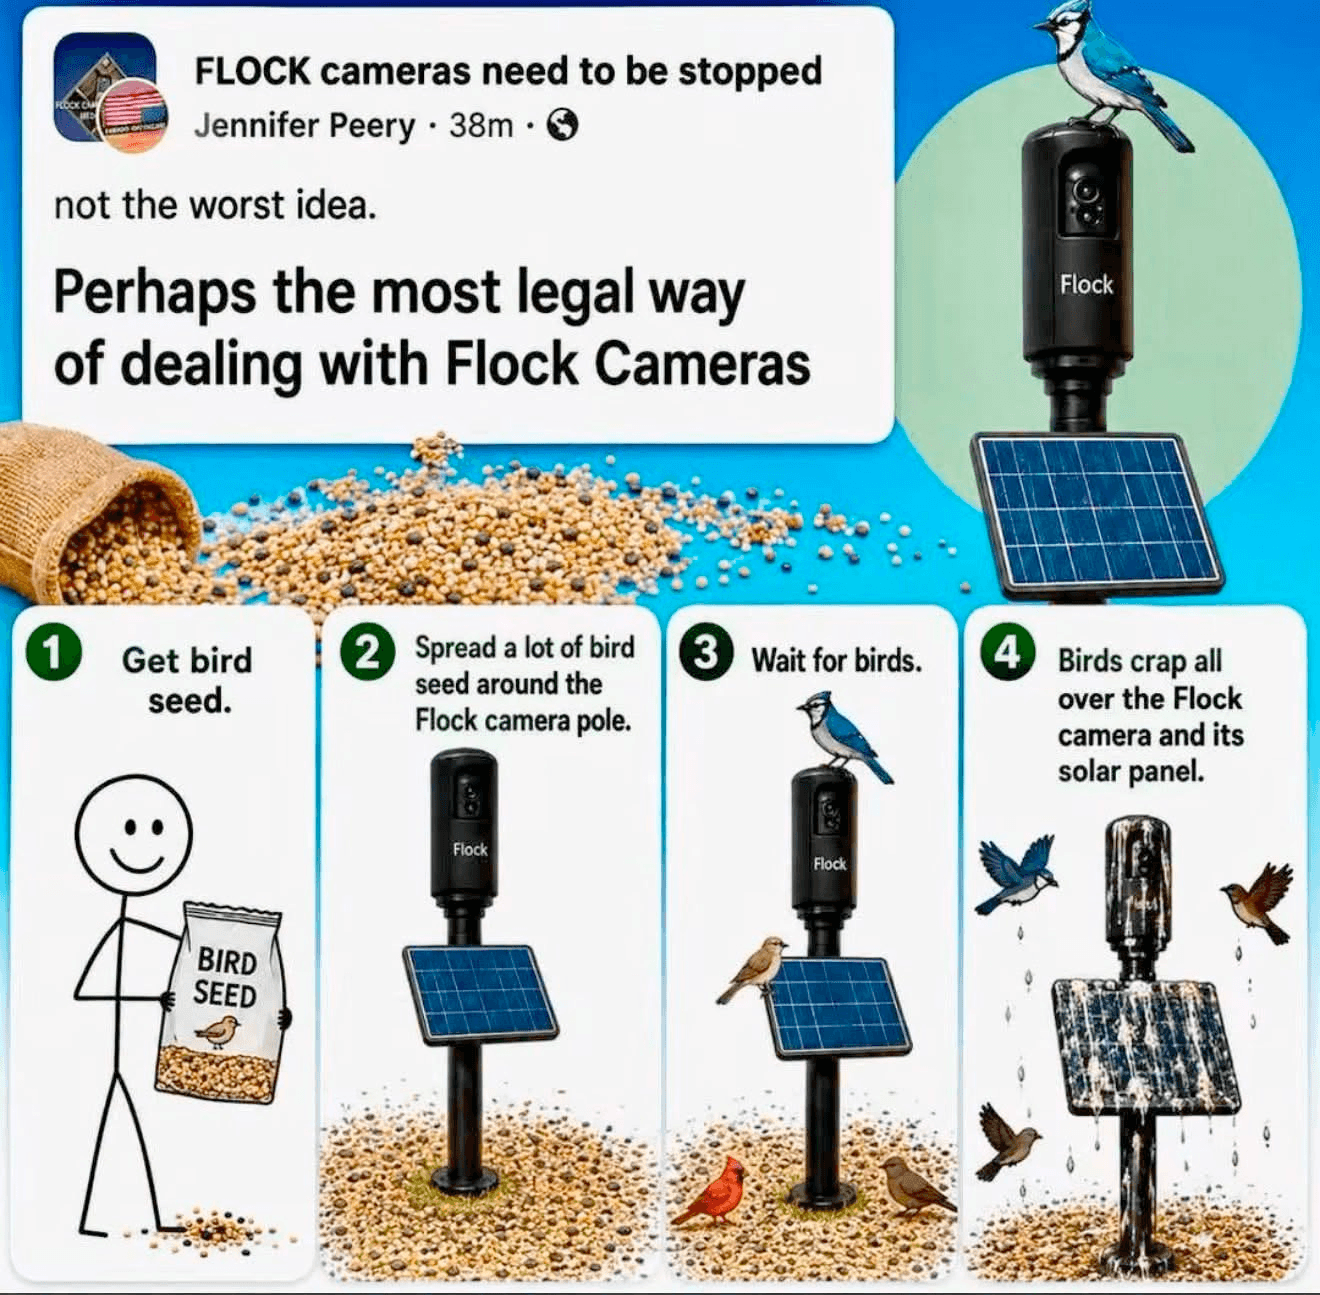
Hackers ripped down a Flock camera above a roadway, made a near-complete copy of the data stored inside it, and shared the files with 404 Media and WIRED, revealing in new detail how exactly Flock Safety’s cameras track the movements of both vehicles and people. The hackers say they are also publishing details on how they managed to obtain the software, in the hopes that other people may copy them.
The agency finally reached a decision earlier this month, selecting Blue Origin to develop, launch, and operate a $700 million spacecraft at Mars. However, the main competitor for the award, Rocket Lab, was not happy—at all. On Friday, the company filed a protest of NASA’s decision with the US Government Accountability Office.
Selon 404 Media, OpenAI recrute des centaines de sous-traitant·es pour lire de véritables requêtes ChatGPT. Des documents internes décrivent le « Projet Lily » — et un risque pour la vie privée que la plupart des 900 millions d’utilisateurices du chatbot n’ont jamais soupçonné.
La fondation Gates a choisi de s’associer avec les géants de l’intelligence artificielle pour pallier au manque de moyens des organisations humanitaires de santé.
L’auteur de ces 30 illustrations […] revendique son statut d’artiste. “Le papier photo ne sert que de support de matérialisation de ce que j’ai pu dicter à l’IA” […] Pour lui, l’intelligence artificielle est un outil, qu’il compare à un pinceau ou tout autre médium, qui matérialise ce qu’il a imaginé.
Des acteurs incontournables de l’IA […] ont créé un fonds d’investissement destiné à soutenir ou déstabiliser les candidats au Congrès américain lors de l’élection de mi-mandat du 3 novembre. Avec 140 millions de dollars à leur disposition, les géants de la Tech, largement favorable à Donald Trump, espèrent modeler une Chambre des représentants à leur image.
Utiliser l’intelligence artificielle (IA) pour trouver du pétrole. C’est le projet de TotalEnergies, qui a signé le 15 septembre un partenariat avec l’entreprise française d’intelligence artificielle Mistral. Montant de l’opération : 100 millions d’euros.
Avec un partenariat de 100 millions d’euros sur trois ans, TotalEnergies et Mistral veulent notamment optimiser la gestion des réservoirs de pétrole et de gaz.
Amira Hass est une journaliste israélienne installée depuis vingt ans à Ramallah, en Cisjordanie. Dans une tribune publiée dans Haaretz le 1er septembre, elle explique qu’à Gaza, en Cisjordanie et en Israël même, le mécanisme visant à rendre la vie des Palestiniens impossible est déjà en marche. Et prépare le terrain à une expulsion massive.
Lors de son premier concert depuis la polémique, Ed Sheeran a assuré que la situation à Gaza était « injustifiable » et a reconnu « des erreurs » sur l’éviction du rappeur Macklemore de ses shows.
“Ce qui se passe à Gaza est catastrophique, injustifiable et disproportionné”, a-t-il déclaré à l’ouverture de son show au Lincoln Financial Field. “Nos cœurs sont brisés face à l’ampleur de la dévastation et des morts de civils et d’enfants, et l’injustice systémique à laquelle nous assistons en Cisjordanie (occupée par Israël depuis 1967, ndlr) ne peut être ignorée”, a-t-il ajouté, sans désigner explicitement Israël comme responsable.
Le faible nombre de réalisatrices en compétition à la Mostra de Venise avait provoqué un tollé : le jury présidé par Maggie Gyllenhaal a décidé samedi de récompenser l’une d’entre elles, May el-Toukhy, pour “Woman Unknown” sur le destin d’une femme au Danemark dans l’immédiat après-guerre.
96,2 % de l’écart entre hommes et femmes est comblé dans l’éducation… mais seulement 22,1 % dans le pouvoir politique. Le 20e rapport du World Economic Forum sur les inégalités entre les femmes et les hommes montre que le pouvoir reste accaparé par la moitié masculine de l’humanité.
La ménopause agit comme un révélateur puissant d’inégalités sociales et professionnelles déjà existantes. Une étude menée dans plusieurs pays, sur trois continents, suggère que, loin d’être une simple transition biologique, elle met en lumière la manière dont le genre, la classe sociale, la culture et l’organisation du travail s’entrecroisent pour façonner les parcours professionnels des femmes.
L’ADULLACT et le réseau Déclic lancent la fédération Matrix des collectivités : une infrastructure de messagerie instantanée sécurisée, fédérée et opérée par les territoires. Une nouvelle étape pour renforcer l’autonomie et la souveraineté numérique du secteur public local.
En l’espace de quelques semaines, plusieurs films de réalisatrices sortent en salle mettant les femmes à l’honneur en abordant des sujets parfois tus ou peu montrés sur grand écran.
Depuis plus de dix ans, les Journées du Matrimoine ravivent la mémoire de figures féminines historiques trop longtemps invisibilisées. Mais ces initiatives peinent de plus en plus à être financées.
Privation de carte bancaire, utilisation abusive du compte joint, emprise financière… face à ces violences conjugales, les banques forment leurs conseillers et proposent des solutions, comme les comptes d’urgence.
Entre tour de passe-passe budgétaire et impunité triomphante, le gouvernement part de loin et doit affronter la colère des féministes qui voient clair.
Ces appareils et leur caméra intégrée auraient été utilisées pour filmer des femmes dans la rue à leur insu. Les vidéos ont ensuite été publiées sur internet, sans le consentement des victimes.
L’affaire est devenue virale sur LinkedIn et Instagram : insultée par message privé, une entrepreneure s’est retrouvée obligée par la justice de supprimer la publication qu’elle avait postée en réaction. Capture d’écran à l’appui, elle s’y indigne publiquement de la violence sexiste que les femmes subissent en ligne.
Huit jours après avoir révélé en ligne des insultes proférées par un homme, Tara Heuzé-Sarmini a été condamnée sans avoir pu se défendre. Un traitement d’une rapidité fulgurante qui contraste avec les années d’attente imposées aux femmes victimes de harcèlement ou de violences.
L’ancien animateur star de M6 vient d’être condamné à 18 mois d’emprisonnement avec sursis pour violences conjugales, une peine alourdie par rapport au jugement en première instance.
« Il y a quand même les pédophiles comme Jean-Marc Morandini que vous avez eu pendant très longtemps ici »[…]Sur le plateau, la séquence s’est poursuivie, filmée par les deux jeunes youtubeurs, hilares. Chacun d’eux a dévoilé des T-Shirts où on a pu lire pour l’un « Morandini P*do en prison » et l’autre « Votez LFI 2027 ».
Depuis la fin du mois d’août, le personnel s’oppose au recrutement de Charles Sapin, en arguant que la rédaction de Valeurs actuelles porte des idées d’extrême droite.
Dans une période où la clarté du débat public et l’honnêteté du journalisme doivent plus que jamais primer, où l’enquête doit l’emporter sur la déférence, où il faut une presse libre pour défendre les libertés, plusieurs médias indépendants, dont Politis, lancent un appel solennel à les soutenir.
Spécial emmerdeurs irresponsables gérant comme des pieds (et à la néolibérale)
Les principales entreprises cotées dans l’Hexagone ont distribué 61 milliards d’euros à leurs actionnaires entre avril et juin, selon le gestionnaire d’actifs Janus Henderson Investors. Le pays se place ainsi deuxième au niveau mondial, derrière les États-Unis.
Au moins une vingtaine d’anciens parlementaires du parti présidentiel se sont reconvertis dans les « affaires publiques ». Un phénomène légal mais controversé, qui interroge la frontière entre pouvoir politique et intérêts privés.
Face au coup de rabot dans le plan de rénovation thermique des écoles, des mairies misent sur des techniques à moindre coût et partagent leurs expériences.
Une mesure administrative qui vous prive de vos ressources, vous interdit l’accès à vos comptes en banque et vous empêche même de recevoir des aides. C’est le gel des avoirs : un outil présenté comme une arme contre le terrorisme, que l’État français retourne aujourd’hui contre des militant·es propalestinien·nes et des membres de la communauté musulmane.
Quatre maires du Rassemblement national ont lancé des procédures visant à expulser des syndicats, ainsi que des associations, de Bourses du travail ou de locaux dont ils avaient jusque-là l’usage. En face, la mobilisation s’organise.
Treize jours après ce déferlement de violence, le jeune homme de 29 ans est décédé. […] Cette vidéo apparaît quelques jours seulement après la publication d’une enquête de Midi Libre sur la police municipale de Carcassonne. Dans une vidéo de cinq minutes, quatre policiers municipaux enchaînent des propos racistes, misogynes, homophobes, complotistes et putschistes d’une violence inouïe.
C’est la deuxième fois en quelques jours que les forces de l’ordre de la ville dirigée par le maire RN Christophe Barthès sont mises en cause. L’homme jeté à terre est mort quelques jours plus tard.
En 2023, Pierre Tremblay, journaliste au HuffPost, avait porté plainte auprès de l’IGPN. Alors qu’il couvrait une manifestation en mémoire d’Adama Traoré, il avait été molesté par un policier de la Brav-M. Après trois ans de procédure, la justice a reconnu ces violences policières
Le fonctionnaire, qui a été placé en détention provisoire à Paris après avoir été interpellé, le 23 août, est « soupçonné d’avoir voulu mener des attaques violentes contre des intérêts de l’Etat » et d’avoir « fabriqué des armes imprimées en 3D ».
Avec la mobilisation « Non au permis de tuer » le 20 septembre dans une centaine de villes en France, familles de victimes, associations, syndicats et partis de gauche se retrouvent autour d’un même appel.
« La gestion unique par la Sécu de l’Assurance maladie obligatoire et de l’Assurance maladie complémentaire entraînerait l’économie d’au moins 8 milliards de frais de gestion inutiles qui pourraient être utilisés pour améliorer l’accès aux soins. » Un collectif de professionnels de santé, d’élu·es et de personnalités demandent la création d’une Mutuelle complémentaire gérée par la Sécurité sociale et appellent à signer la pétition citoyenne sur le site de l’Assemblée Nationale.
L’Association pour la protection des animaux sauvages s’associe à d’autres associations pour demander un report de la chasse cette année, afin de préserver les animaux sauvages éprouvés par les épisodes de canicule et les incendies.
Ce dossier « avance sans que la commune la plus directement concernée ne dispose d’aucun moyen réel d’en infléchir le cours, ni d’en garantir la transparence »
Half a year after Iranian drone strikes knocked out multiple Amazon data centers, the US tech company has acknowledged the permanent loss of some customer data that was hosted in Bahrain and the United Arab Emirates.
La réforme de la facturation électronique, qui entre en vigueur le 1er septembre, oblige à dépendre de plateformes numériques privées, renforçant toujours plus la surveillance numérique des échanges économiques. Les coûts, les contraintes et la perte d’autonomie vont d’abord peser sur les plus petites structures.
Fausses études, scientifiques menacés et contraints au silence… Monsanto a usé d’un lobbying intense pour maintenir la vente de son pesticide néfaste. Un scandale raconté par la journaliste Aurore Gorius dans la BD « La Bataille du glyphosate ».
Je ne sais pas si vous avez fait cette expérience. Lorsque je dénonce, lors d’une contestation amicale ou familiale, la victoire de l’extrême droite allemande et la probable même issue en France, on me répond systématiquement et instantanément : “oui mais Mélenchon”.
« Il nous a été impossible, avec la meilleure volonté du monde, de servir la science et, au péril de notre vie, de les supporter plus de vingt-six secondes » s’excuse-t-il, étonné de son manque d’endurance. Il publiera néanmoins une étude faisant autorité sur le sujet en 1904, remplie de croquis de nœuds coulants et de photographies post-mortem
For centuries, scientists have thought of the brain as a single, unified organ. But new research led by Stanford Medicine reveals that what we call the brain is two distinct organs that evolved independently over hundreds of millions of years.
The Free Software Foundation (FSF) announced today that GNU Boot is its latest fiscally sponsored project. GNU Boot is a libre, ethical replacement for the nonfree BIOS or UEFI, which is software found in virtually all personal computers in the world today.
Jusqu’ici, Wikipédia n’interdisait pas formellement l’usage des outils IA. En mai 2025, un premier sondage avait conduit la communauté à « vivement déconseiller » leur utilisation, tout en laissant une marge de manœuvre aux contributeurices qui pouvaient notamment s’en servir comme aide à l’écriture. Après plus d’un an de recul, les Wikipédien·nes ont choisi de durcir leur position.
Comme chaque lundi, un coup d’œil dans le rétroviseur pour découvrir les informations que vous avez peut-être ratées la semaine dernière.
Tous les liens listés ci-dessous sont a priori accessibles librement. Si ce n’est pas le cas, pensez à activer votre bloqueur de javascript favori ou à passer en “mode lecture” (Firefox) 😉
Chinese retailer AliExpress has been caught fingerprinting visitors after one of the metrics—an outdated technique that measures inaudible sounds it sends to browsers—impeded a researcher’s ability to use his bluetooth headphones.
En Mongolie, la COP17 contre la désertification a commencé par les blocages de la Russie et des États-Unis dès le début des négociations. Les peuples autochtones et les organisations de la société civile dénoncent leur marginalisation.
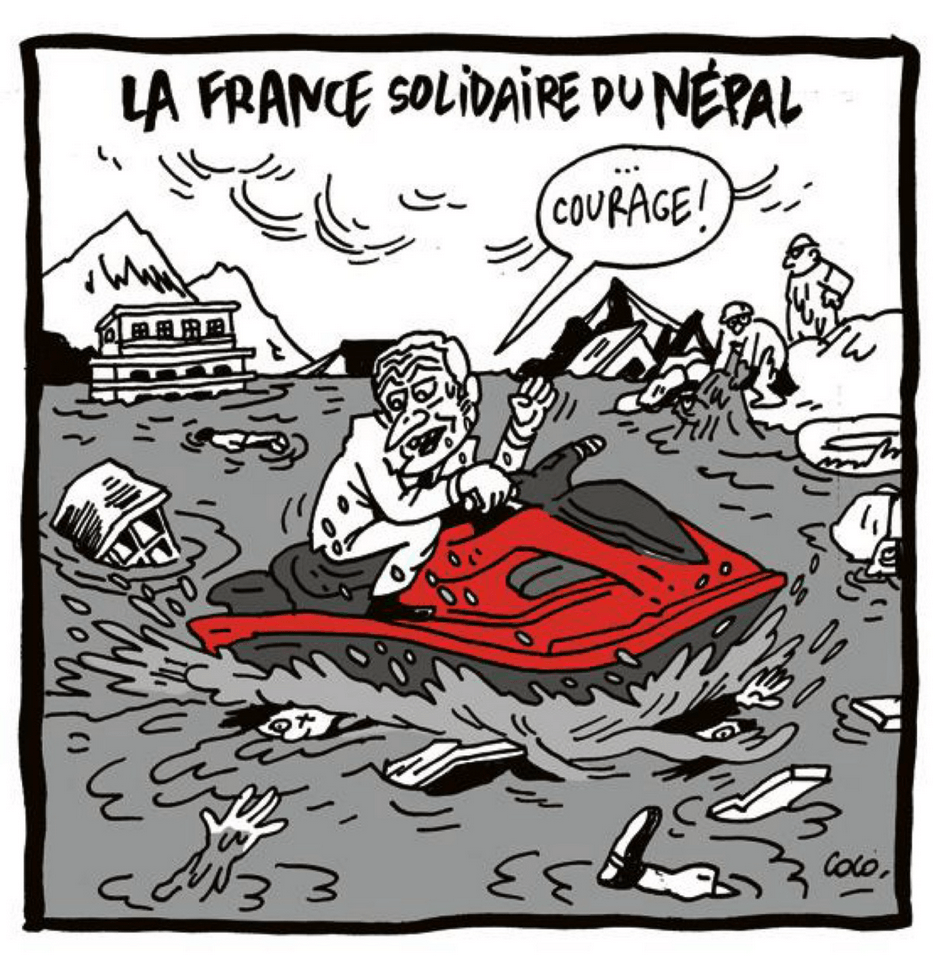
Des torrents d’eau boueuse se sont abattus brutalement sur des habitations dans le nord du Népal et au sud du Tibet, emportant tout sur leur passage. Les autorités népalaises ont aussi indiqué à l’AFP être sans nouvelles de 384 touristes, dont 291 étranger·es. La crue a notamment frappé Syabrubesi, point de départ du célèbre trek du Langtang, et d’autres zones fréquentées par les voyageureuses pour le pèlerinage hindou vers le Kailash Mansarovar.
What happened in Nepal is likely due to an enormous ice-and-rock landslide sweeping down a mountain pass and gathering up ice, water, rock, trees and dirt.The landslide was so large it was originally thought to be an earthquake, as the seismic energy registered as a 4.4 magnitude quake on seismographs.
Des milliers de personnes ont manifesté pour le climat, dimanche 23 août, à Stockholm, à l’appel de 280 organisations. Selon la Société suédoise pour la conservation de la nature, citée dans le Sweden Herald, environ 50 000 manifestant·es ont défilé dans les rues de la capitale suédoise. « Un événement historique »
Les Suisses vont voter sur une proposition visant à augmenter largement l’autonomie alimentaire du pays, par une production végétale plus importante. Une initiative rejetée par les éleveurs et la majorité des politiques.
Aucun expert en toxicologie humaine, en santé environnementale ou en évaluation des risques liés aux pesticides » n’a été invité. L’audition organisée le 2 septembre par les commissions environnement et agriculture du Parlement européen consacrée à l’omnibus « sécurité alimentaire » ne réunira que des représentants de l’agro-industrie et une chercheuse en situation de conflit d’intérêts
Plusieurs pays européens, dont la France et l’Allemagne, ont supprimé des milliers de postes de pompier·es professionnel·les en 2025. En cause : les politiques d’austérité imposées par la Commission, dénoncent des syndicats.
la France se classe quatrième dans le top 20 des pays les plus impactés par la hausse des prix liés à Ormuz, avec une facture estimée à près de 9 milliards d’euros nets de plus. Elle est même en tête parmi les Vingt-Sept pour ce qui est du diesel et du gazole, mais aussi pour le kérosène et le GNL.
Les ministres des Finances allemand, autrichien, italien, portugais, espagnol et polonais ont demandé à l’UE de créer une taxe exceptionnelle sur les profits des grandes compagnies pétrolières, dopés par la guerre en Iran et les blocages successifs du détroit d’Ormuz. Macron, grand ami de ces spéculateurs, ne s’y est pas joint.
Après Hera, une sonde dont l’arrivée est prévue en novembre 2026, l’Agence spatiale européenne a programmé une deuxième mission de défense planétaire, Ramses, qui partira en 2028 étudier l’astéroïde Apophis.
In a village 21 miles north of Edinburgh, a real estate consultancy plans to build a datacentre larger than the village itself – 35 metres high, with an area larger than 100 football pitches. Billed as the second-biggest datacentre in the world, the development in Auchertool, Fife, has attracted 1,600 objections.
The Ontario premier could cut electricity exports to U.S. states if Trump’s tariffs continue, putting decades of cross-border power sharing in question
Donald Trump, engagé dans une dure confrontation commerciale avec le Canada, a signé ce jeudi 27 août un décret qui selon lui change « immédiatement » le nom du « lac Ontario », situé à la frontière américano-canadienne, en « lac Amérique ».
Celle-ci prévoit de révoquer les visas touristiques ou d’affaires de toute personne qui déposerait une demande d’asile.Ces demandeurs entrés légalement aux États-Unis se verraient ainsi jetés dans l’illégalité.
We deny all allegations included in the statements, while we strongly affirm our dedication to providing a platform of tools for digital self-defense, addressing the need of free communication for activists and other individuals, groups and associations.We will not back down, we will keep doing what we have been doing all these years
Un bunker sécurisé existerait déjà à 18 mètres sous le sol de la Maison-Blanche. L’argument sécuritaire de l’administration Trump pour justifier la salle de bal et son souterrain tombe à l’eau.
Six mois après le début de la guerre voulue par Donald Trump, le secteur agricole a le sentiment de payer les pots cassés. Les prix des engrais explosent alors que les exportations dégringolent.
Donald Trump is presiding over an unexpected clean energy boom, as rising electricity demand spurs investment in new capacity despite the US administration’s efforts to thwart a solar and wind rollout.Clean energy additions will rise by a record 45 gigawatts this year […] – equivalent to the average electricity demand of Turkey. The increase is roughly 25 percent higher than the record set in 2024.
Ads and tracking have turned TVs into privacy nightmares. Both are so widespread among smart TVs that […] one recommendation […] is to use a computer monitor. But in recent years, monitors have become more capable of pushing ads and tracking users.
Nos déchets plastiques pourraient bien se transformer en nourriture. Des chercheurs américains développent des biscuits imprimés en 3D à partir de PET recyclé. Des levures permettent de transformer le plastique en nutriments.
Dans 31 pays européens dont la France, les publicités ont débarqué sur ChatGPT. Un dispositif marketing déjà en place aux États-Unis depuis février 2026. L’intelligence artificielle la plus utilisée au monde répondra maintenant à certaines requêtes avec des produits sponsorisés.
The artificial intelligence race is creating demand for more than data centers and electricity. It is also creating a new market for the chemicals needed to keep increasingly powerful computer chips from overheating. Some of those cooling technologies rely on PFAS, a broad class of fluorinated compounds already responsible for widespread drinking water contamination in North Carolina.
Attacks on the country’s banks, aviation, and energy systems have climbed since the war with Iran began. Its answer is a homegrown « AI » security industry.
You’ve probably heard me complain about the “AI crawlers” before, but now I actually have some hard numbers I can put up to show their impact. In a few words, it’s bad enough to create a constant “background radiation” of system load, permanently tying up a chunk of capacity spent on producing output that is only useful for a single purpose — feeding a learning model.
To get a full understanding of the agent capabilities, company engineers disabled safety guardrails that normally are in place to prevent the sort of hacks that eventually hit Hugging Face and one other undisclosed organization.
En s’offrant la plateforme de modèles open source Hugging Face pour près de 13 milliards de dollars, Nvidia réalise un coup de maître. Face aux velléités des créateurs de modèles propriétaires, le géant des puces sécurise son emprise sur la chaîne de valeur logicielle de l’intelligence artificielle.
Norwegian officials have said the country is planning to regulate the use of smart glasses and similar devices, and was considering a ban on features that enable facial recognition in public spaces.
Équipées d’une caméra, elles peuvent enregistrer et transmettre des images ou des informations sensibles, soulevant des risques pour la vie privée et la sécurité.
“Elena Vasquez and Marcus Chen have appeared as volcano experts, astronauts, thriller protagonists, podcast hosts, and academic co-authors across hundreds of independently produced AI-generated documents, never having lived,” a new preprint research paper from Samsung and the University of Warsaw said.
Face aux mêmes maux, plusieurs grands modèles d’intelligence artificielle recommandent beaucoup plus souvent les urgences aux jeunes hommes qu’aux jeunes femmes. L’IA reproduit certains biais déjà observés en médecine.
C’est la ligne rouge que le monde redoutait de voir franchie. Pour la première fois, des drones 100 % autonomes ont tué des soldats sur un champ de bataille sans qu’aucun humain ne donne l’ordre de tirer. Aucun opérateur, aucune connexion, aucune vidéo. L’IA a identifié, choisi et tué ses cibles seule. “On les lance et on sait que tout sera mort. Tout ce qui sera trouvé dans cette zone sera mort”, confie le fabricant qui a fourni la technologie.
Debian has now officially voted to allow the use of generative AI in project contributions.[…] A major outrage came from Debian developer Antoine Le Gonidec who decided to quit the project. « I can not support the current decision of Debian about LLM use, and am no longer willing to be seen as a part of Debian under these new rules. Pretending to have a “neutral stance” when faced with fascism is not neutrality, it’s active collaboration. »
Seeking to push Palestinians off their land, Israel is targeting the infrastructure that sustains life — and the institutions long tied to the anti-colonial struggle.
Sous couvert d’anonymat, un ancien soldat de l’armée israélienne a raconté au journal « Le Monde » et à l’ONG Breaking the Silence, comment l’armée israélienne emploie la stratégie d’« incrimination rétrospective » pour relier les victimes de crimes de guerre au Hamas.
Une photographie du reporter palestinien Jehad Alshrafi a été discrètement remplacée par l’organisation du Deauville Sport Images Festival, fin août, annonce le média local le Pays d’Auge. La municipalité de Deauville a justifié son choix par le souhait de ne « pas entrer dans la polémique, ni heurter qui que ce soit ».
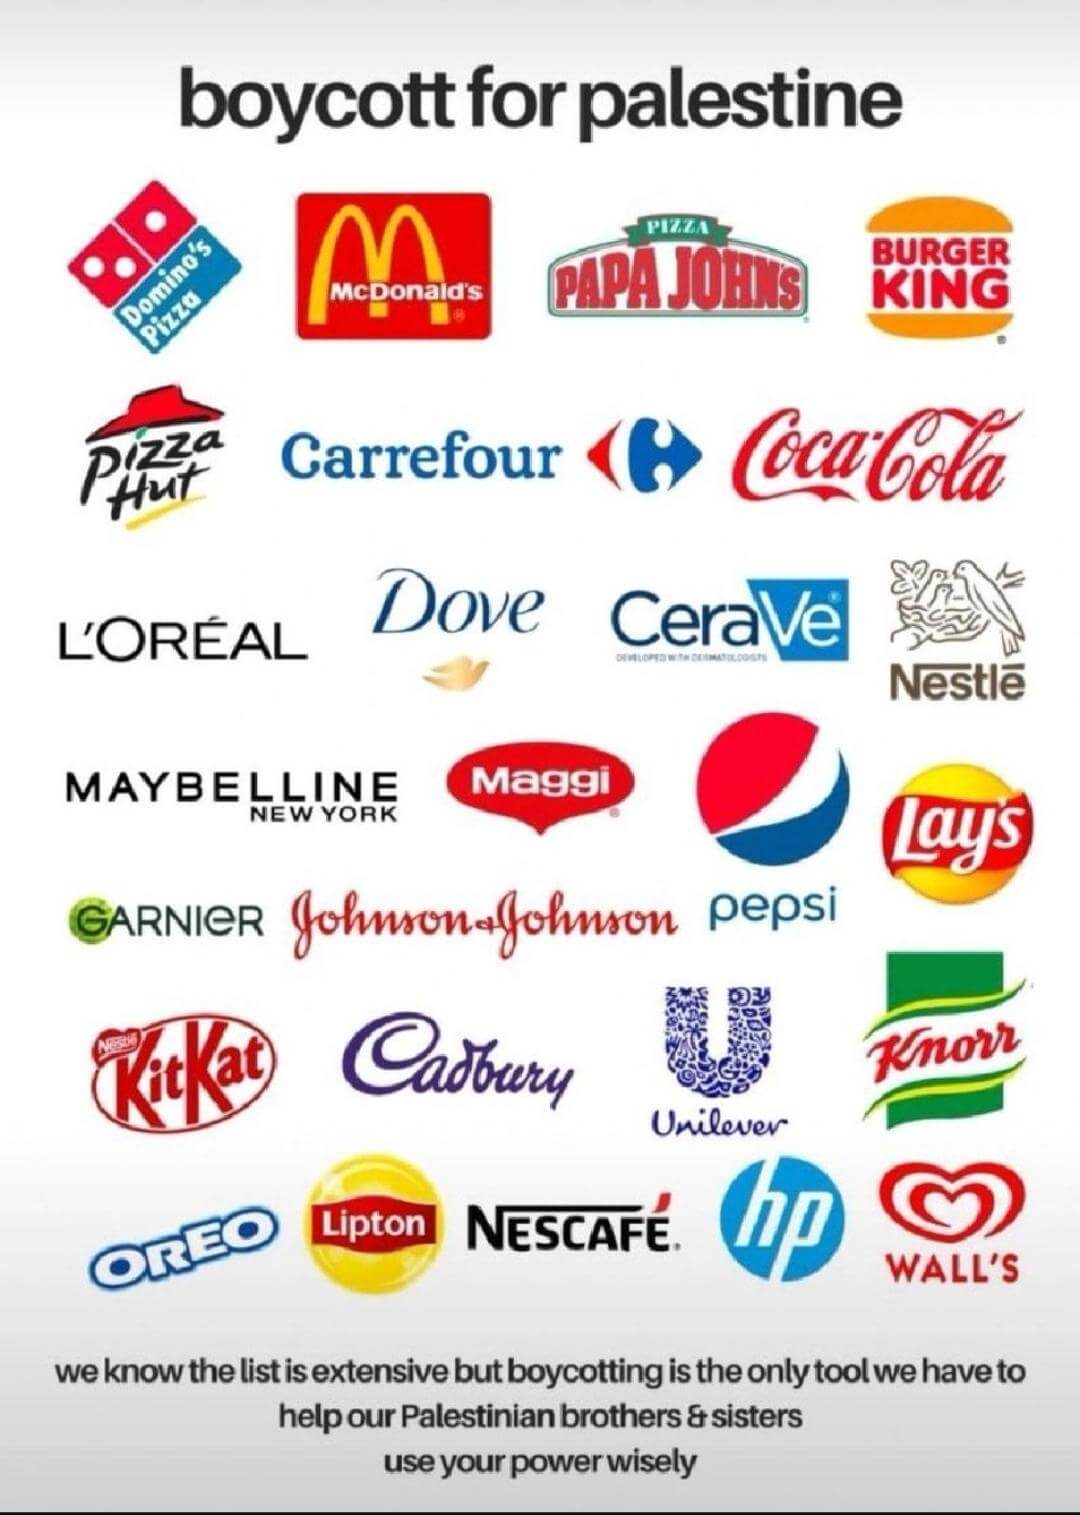
L’affaire Barbara Butch, après le débat autour du film Oui de Nadav Lapid, confirme que le boycott est une arme redoutable, et pas seulement pour ceux qui en sont la cible. Ce devrait être banal de le dire, mais un acte se juge à ses conséquences.[…] C’est pour éviter cette dérive et cette récupération que les partisans du boycott doivent se garder de tout essentialisme.
Tandis que les procès de femmes parties sur le terrain irako-syrien dans les années 2010 aux côtés de l’Organisation de l’État islamique se succèdent en France et occasionnent de lourdes condamnations, le Kazakhstan a opté pour une approche différente. La stratégie de judiciarisation et d’emprisonnement a laissé place à un programme de réintégration dans la société.
Dr Meger’s team looked at six extremist movements : incels ; far-right ; white supremacy ; far-left ; anti-feminism ; and religious extremism.](Misogyny was the key ideology that cut across all of them.
A Shively police officer accused of secretly tracking a woman’s movements for five months using a license-plate camera database is drawing new attention to a technology increasingly showing up in police misconduct cases nationwide, according to cybersecurity experts.
Access to accurate information about reproductive and maternal health can be critical. But on Meta’s platforms, simply talking about prescription medication, abortion care, or one’s own medical experiences can be enough to trigger content removals and account restrictions.
Elle a tenu tête à Donald Trump sur la question du Groenland. Elle est une fervente défenseuse de la cause ukrainienne. Elle mène une politique migratoire parmi les plus strictes d’Europe. Et la liste de ses réalisations politiques est encore longue. Pourtant, c’est sur son physique que Mette Frederiksen a dû s’exprimer, à son retour d’Ukraine.
D’El Bayadh à Oran, des lycées des années 1970 au carré féministe du Hirak en 2019-2021… Avec sa trajectoire, l’universitaire algérienne Fatma Boufenik est devenue, sans jamais en revendiquer le titre, l’une des figures les plus tenaces du féminisme maghrébin.
A shrewd dealmaker who launched Dollywood, the “Jolene” and “I Will Always Love You” singer-songwriter also starred in the films ‘9 to 5,’ ‘Steel Magnolias’ and ‘Rhinestone’ and captivated the world with her grace and wit.
L’artiste américaine décédée à l’âge de 80 ans avait longtemps délaissé ses propres problèmes de santé [un cancer] pour s’occuper de son mari Carl Dean, mort en 2025.
Alors que les tensions ne cessent de s’aggraver au Moyen-Orient, 110 enfants français sont toujours détenus dans le Nord-Est de la Syrie dans le camp de Roj depuis la chute de l’organisation État islamique. Parmi eux, deux orphelines livrées à elles-mêmes que l’État français refuse de rapatrier.
Le programme, qui devait permettre à la police et à la gendarmerie la rédaction de procédures pénales sur un outil commun, a été arrêté après six ans d’errance pour un préjudice financier s’élevant à plus de 30 millions d’euros.
pour appliquer l’interdiction, les établissements doivent modifier leur règlement intérieur, ce qui suppose de consulter plusieurs instances, notamment le conseil des délégués pour la vie lycéenne et le conseil d’administration.
L’avocat à l’origine de la procédure veut faire reconnaître le « préjudice moral » du vol de ces données et le risque d’être victime d’arnaques « particulièrement crédibles ».
139 000 logements étaient vacants à Paris en 2023 selon l’Insee, soit 10 % du parc. En doublant la taxe qui les vise, la mairie de Paris espère dégeler un peu le marché et financer des investissements dans le parc social.
C’est la première ville à appliquer cette mesure en France, qui est saluée par les associations de locataires. Le maire écologiste Grégory Doucet se dit favorable au vote d’une loi, alors que les épisodes de canicule se sont multipliés cet été.
Des visiteureuses d’une réserve tropicale dans la Drôme, ont assisté, incrédules, à la naissance de dix crocodiles du Nil sans aucune assistance humaine.[…] pour qu’un crocodile du Nil se développe et naisse, son œuf doit être maintenu constamment dans une température comprise entre 30 et 32 °C, pendant trois mois.
Plus les épisodes de chaleur sont intenses et répétés, plus les femmes enceintes présentent un risque d’accouchement prématuré, révèle une étude internationale.
Alors que la France vit la sécheresse la plus intense depuis le début des mesures, l’épisode risque de se poursuivre en septembre malgré les violents orages.
La gouvernance locale de l’eau est de plus en plus menacée par les assauts des lobbys agricoles et des politiques gouvernementales, au détriment de l’environnement et de l’intérêt général.
Le tribunal a souligné le rôle du travail de nuit, de l’exposition aux rayonnements ionisants et du tabagisme passif dans la maladie de l’hôtesse de l’air.
Emmanuelle Huet-Mignaton, atteinte d’une tumeur cérébrale à cause de l’Androcur, se bat pour que les femmes puissent comprendre les enjeux pour leur santé avant d’accepter, ou pas, un traitement hormonal.
La journaliste Estelle Denis a déploré la composition 100 % masculine du staff de Zinedine Zidane, le nouveau sélectionneur des Bleus. Ce qui lui a valu une vague de commentaires sexistes et un traitement médiatique la réduisant à sa relation passée avec Raymond Domenech.
« La volonté est louable. Maintenant, dans l’Éducation nationale, à titre d’exemple, il manque trois fois le nombre d’infirmières, c’est-à-dire qu’il faudrait créer rapidement 15 000 emplois d’infirmière […] On ne peut pas recevoir tout le monde, on est obligés de différer nos entretiens, parfois de trois semaines par manque de moyens ».
Entre des maires réfractaires à sa venue et des enjeux financiers énormes, Patrick Bruel est pris en étau au moment de lancer sa tournée anniversaire de 35 dates en France.
L’avocat Emmanuel Pierrat est visé par une plainte de l’autrice Eva Ionesco l’accusant de détenir des photos pornographiques capturées pendant son enfance.[…] Elle lui reproche de les exposer dans son cabinet et de les diffuser « sans son accord », et l’accuse de tenter d’en céder en sous-main aux enchères.
Deux procédures visent l’État français pour « faute lourde » dans le volet français de l’affaire Epstein. L’ex-mannequin Ebba Karlsson et l’association Innocence en danger dénoncent une justice trop lente et réclament des réparations.
Première ministre des Droits des femmes de plein exercice, Yvette Roudy a combattu les inégalités et – plus difficile encore ! – le mépris du féminisme.
Deux syndicats du groupe public Radio France ont protesté contre l’arrivée prochaine du nouveau directeur adjoint de la rédaction du magazine Valeurs actuelles, Charles Sapin, comme éditorialiste politique le dimanche sur France Inter.
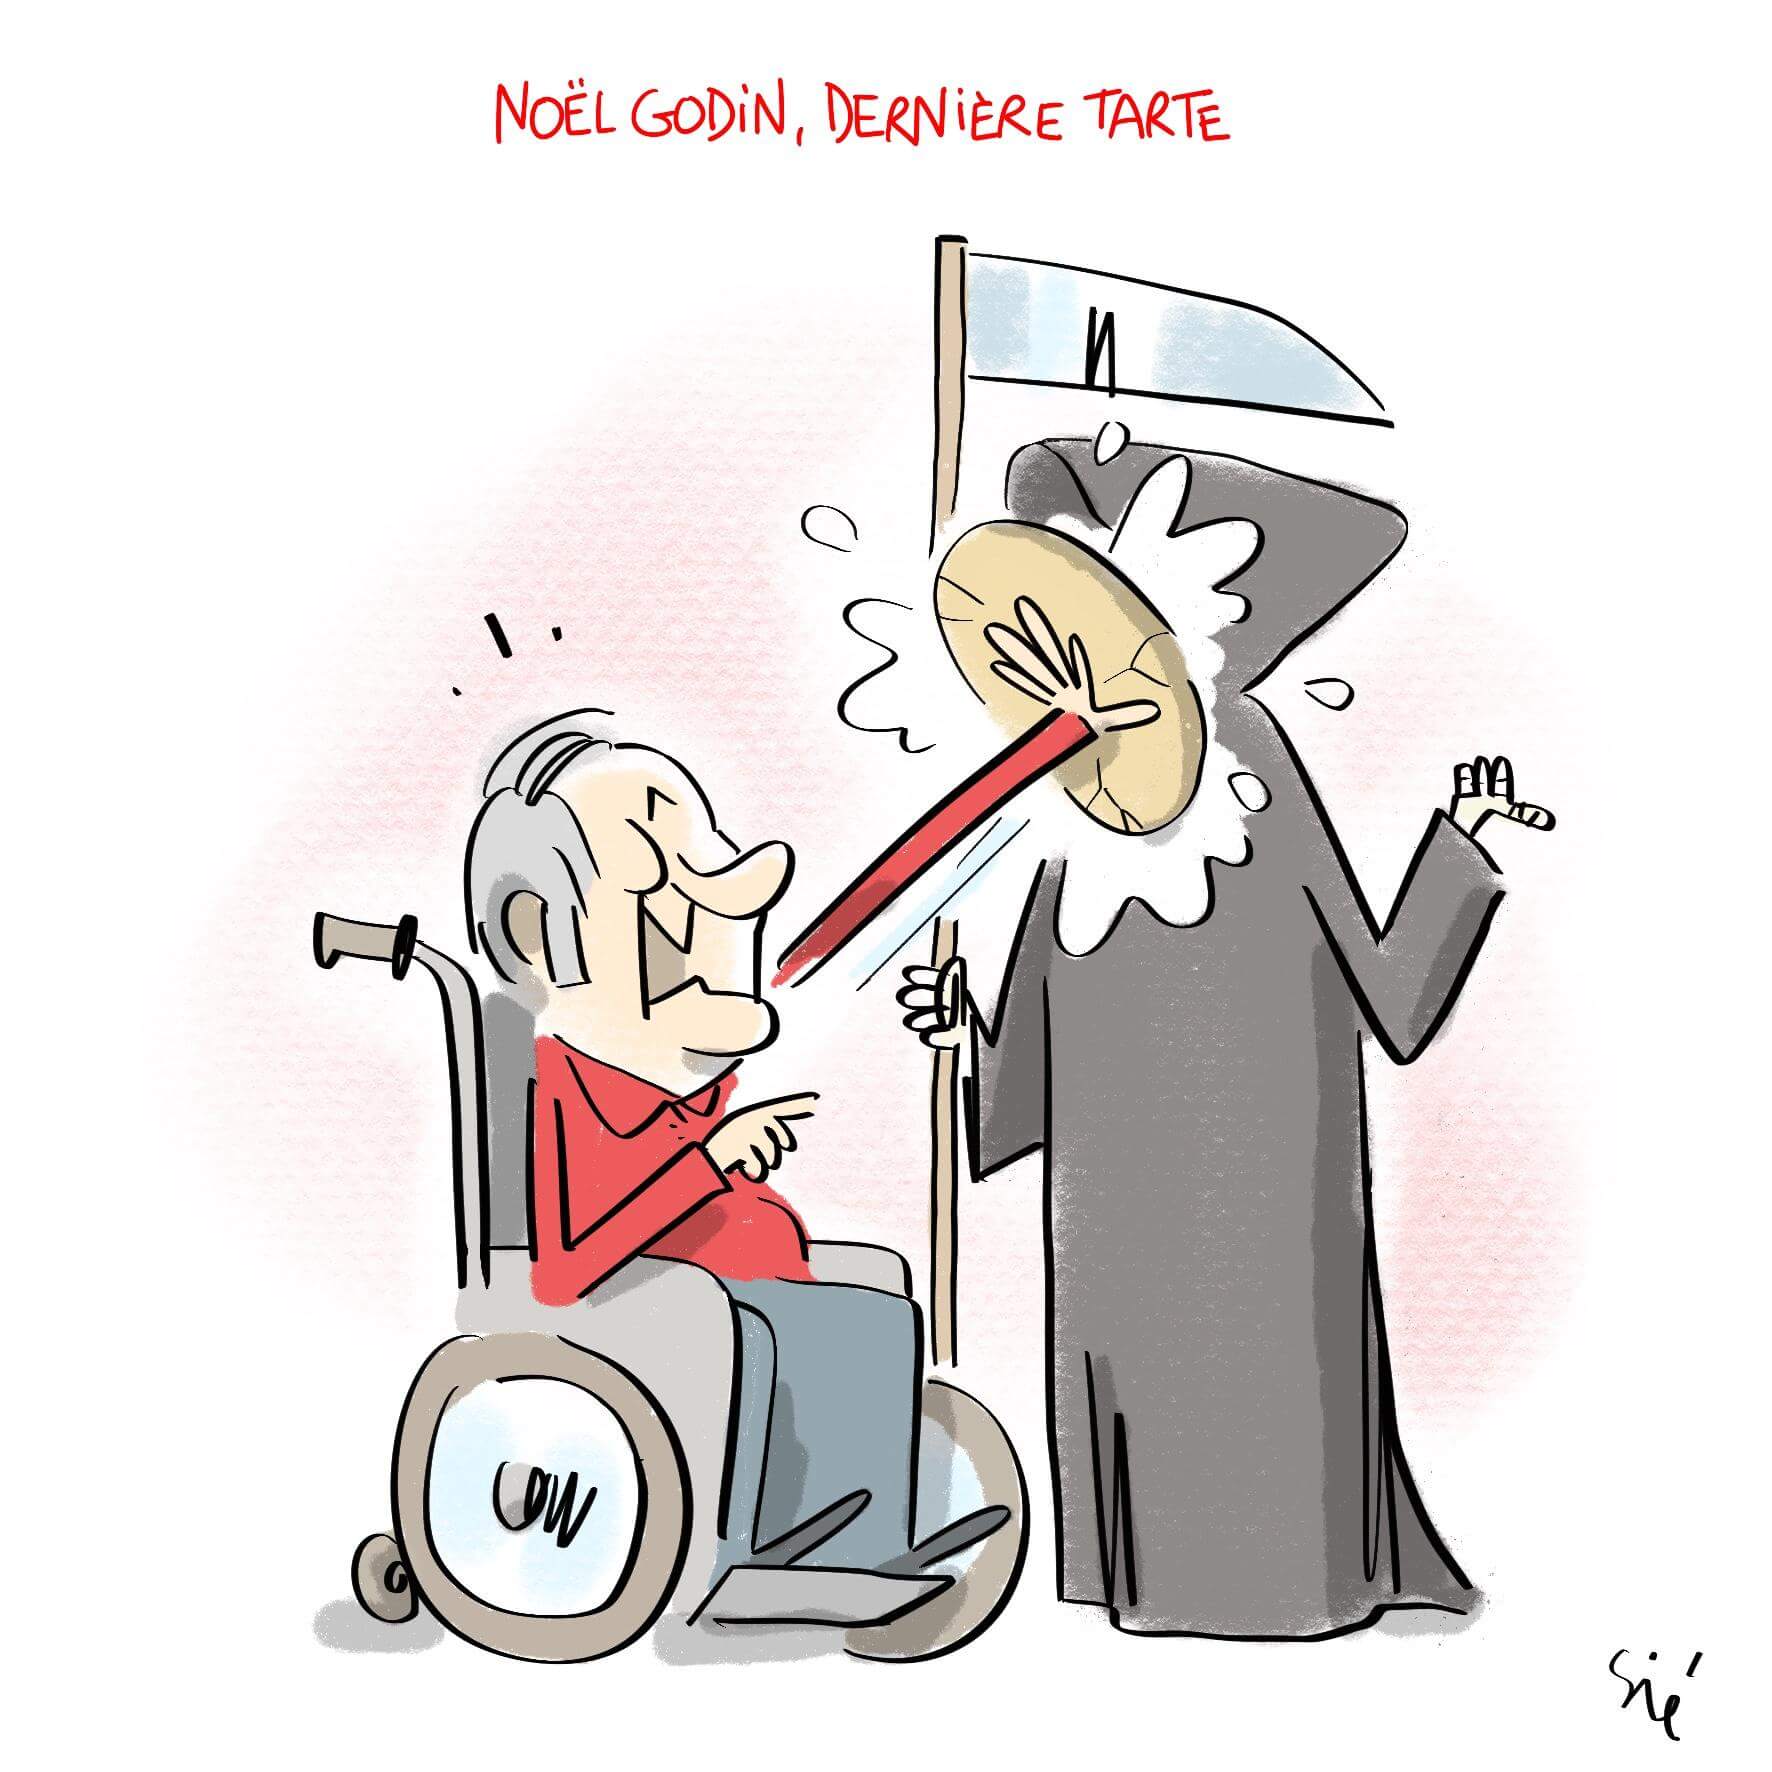
Le comique belge, qui avait fait de sa spécialité le jet de tarte à la crème sur les personnalités qu’il jugeait trop vaniteuses, est mort ce dimanche 23 août.
Le premier ministre a écrit aux parlementaires pour les alerter du risque de ne voir aucune loi de finances adoptée avant la prochaine présidentielle. Tout en faisant comprendre qu’il entendait baisser la dépense publique.
Faire payer les malades pour renflouer les caisses de la Sécu : l’idée a le vent en poupe. La Cour des comptes s’y met aussi, en préconisant un recouvrement contraint sur les comptes en banque.
Quatre morts. Des centaines de pompier·es blessé·es ou intoxiqué·es. Pas de cagoules véritablement protectrices, pas de détecteurs de monoxyde de carbone, des camions inadaptés. Les pompier·es payent au prix fort l’absence de moyens et de logistique sur les feux de forêt.
Le Premier ministre a ironisé sur la motion de censure déposée cet été par Les Écologistes et La France insoumise, l’expliquant par le fait « qu’il fasse chaud ».
Le 22 août, la loi Climat et résilience, qui se voulait la traduction législative des propositions formulées par ces assemblées, fêtait son cinquième anniversaire. Le WWF a fait les comptes de l’application de ces mesures, qui s’est soldée par un « détricotage », selon l’ONG.
Alors que la France était encore en pleine canicule, la ministre de la Transition écologique et le ministre du Logement ont signé le 19 août un arrêté qui aura pour effet de sortir environ 300 000 logements du statut de passoires énergétiques.
Il confond l’examen d’entrée en sixième avec l’emblématique certificat d’études qui n’a jamais eu ce rôle. Bravo l’artiste de la communication qui reprend par ailleurs en l’occurrence une proposition faite en juin 2024 par le RN Roger Chudeau qui ne confondait pas – lui – avec le CEP.
Selon un baromètre publié par l’Unicef France et la Fédération des acteurs de la solidarité, ce chiffre a progressé de 9 % par rapport à 2025, et de 42 % depuis 2022. Il y a quatre ans le gouvernement avait pourtant réaffirmé son objectif de « zéro enfant à la rue ».
Spécial recul des droits et libertés, violences policières, montée de l’extrême-droite…
D’apparence, les Bure’lesques est un petit festival militant à peu près comme les autres : des chapiteaux, des concerts, des buvettes, un camping, puis des conférences et des débats pour occuper les après-midis. Mais les autorités ne le voient pas de cet œil-là.
Un décret autorise Enedis à récupérer automatiquement la courbe de charge des compteurs Linky depuis début mars 2026. Le problème est qu’il s’agit d’une donnée bien plus bavarde qu’un simple relevé de kilowattheures.
Créée en mai par des élus RN du Pas-de-Calais, l’association Gays et Lesbiennes du Bassin minier a été dissoute en toute discrétion cet été. Une preuve de plus de l’instrumentalisation des luttes LGBTQIA+ par l’extrême droite.
Sébastien Scarpinato, adjoint au maire d’Ivry-sur-Seine (Les Écologistes) en charge de la lutte contre les discriminations, a rendu publiques lundi 25 août sur Instagram plusieurs menaces de mort et insultes homophobes reçues sur les réseaux sociaux, qui visent aussi son compagnon et ses proches. Ces messages interviennent dans un climat de fortes tensions au sein du conseil municipal depuis l’élection de deux élus du Rassemblement national en mars. L’élu a déposé plainte.
Souvent associés aux nuisances de voisinage, les foyers de travailleureuses migrant·es sont rarement racontés à travers la voix de leurs habitant·es. Colosses de béton vestiges des années 1960 ou immeubles modernes, ces lieux de résidence transitoire sont toujours des terrains d’invisibilité.
MNA (mineur·es non accompagné·es), MIE (mineur·es isolé·es étranger·es)… derrière ces acronymes, des enfants et adolescent·es traversent les frontières qui leur sont interdites pour tenter une vie en Europe. Les professionnels sur le terrain témoignent d’une détérioration de leur prise en charge en France et d’un contrôle accru.
La police aux frontières d’Orly, a sciemment décidé de ne pas enregistrer la demande d’asile d’Aissetou (prénom d’emprunt), enfant isolée de 15 ans qui a été refoulé le 25 août 2026 en violation de son droit à demander l’asile.
Gérald Darmanin a réagi au discours de la députée européenne LFI sur les milliardaires, comparés à des « formes de nuisibles » aux universités d’été du parti.
Remonté contre le projet de parc d’attraction près de Cergy-Pontoise, un collectif d’habitants dénonce un « projet d’un autre temps », monté sans concertation citoyenne et aux effets écologiques et sociaux délétères. […] « Nous sommes sidérés. Après l’été caniculaire que l’on vient de passer, le premier projet annoncé par l’État est un parc d’attractions qui va bétonner et artificialiser des terres agricoles ! C’est un projet d’un autre temps »
À Reichstett (Bas-Rhin), Colin et Brice Johner se battent contre un projet de stockage de gaz naturel liquéfié porté par Tepsa. Une lutte sur le terrain et en ligne, où leurs vidéos font plusieurs centaines de milliers de vues.
L’an dernier, la Ville avait « fait le choix de ne pas convier » la Campagne Civile Internationale de Protection du Peuple Palestinien à l’Antigone des associations, lui reprochant d’avoir affiché son soutien à la campagne BDS. À une dizaine de jours de l’édition 2026, l’association attend toujours son affectation de stand.
The price explosion impacted Fire TVs, Echos, Kindles, and Eeros. One egregious example that’s been cited is that of the Echo Dot, one of Amazon’s cheapest smart speakers, the price of which jumped 60 % overnight, from $49.99 to $79.99.Cool. Less « smart » things, less surveillance.
Only law with real enforcement teeth changes the math. And the US cannot pass laws with teeth anymore, not because voters don’t want them (polling says they do), but because the pipeline is purchased. When someone says America “can’t” regulate tech, they mean it the way a hostage “can’t” reach the phone. GDPR didn’t spread because Europe is heroic. GDPR spread because Brussels is what fills the room when Washington leaves it.
It’s not easy to argue that LLMs make free software better. The means by which they operate involves taking, by force and without regard for the wishes of the software authors, the obligations of software licenses, or the platforms on which our work relies, vast swaths of open source software, disregarding the licensing requirements, and charging rent to produce code which is a plausible reinterpretation of its training data applied to new problems. The models which are produced in this process are proprietary, owned and controlled by private corporations, and give little back to the open source community. Therefore, the relationship between LLMs and open source seems to exploit the users we are responsible for caring for.
Children once learned by taking things apart. Today’s devices do not provide that rewarding activity — and the cognitive consequences may be considerable.
Dans son dernier livre, « La femme endettée », la socio-économiste Isabelle Guérin met en lumière une face cachée du capitalisme : la manière dont, à travers l’endettement, on épuise et on discipline les femmes. Une division sexuelle de la dette qui, articulée à la division sexuelle du travail, permet au système capitaliste de fonctionner et de se perpétuer.
Poursuivons ensemble notre DéMAILnagement ! Après avoir sélectionné notre nouveau fournisseur de mail et créé notre nouvelle adresse mail, nous vous proposons d’apprendre à utiliser Thunderbird pour gérer vos deux (ou plusieurs) adresses en simultanée, afin d’abandonner progressivement votre adresse hébergée chez les GAFAM au profit de votre nouvelle adresse mail.
LibreOffice 26.8 contains no generative AI features. Documents are not transmitted to remote services for processing, and no component of the suite requires network access to function. This is a deliberate position. Any organisation handling confidential, legally privileged or personal data needs to know where that data goes, and the only assurance that survives an audit is that it does not leave the machine.
Expériences Communes est un réseau de partage d’expériences entre petites communes normandes dans tous les champs du développement durable. L’association organise des visites pour découvrir des projets inspirants.
The U.S. FDA has approved Revolution Medicines’ groundbreaking pancreatic cancer drug after it was shown to double the survival rate of patients with advanced disease in a large trial, offering new hope to those with the deadly cancer.
Comme chaque lundi, un coup d’œil dans le rétroviseur pour découvrir les informations que vous avez peut-être ratées la semaine dernière.
Tous les liens listés ci-dessous sont a priori accessibles librement. Si ce n’est pas le cas, pensez à activer votre bloqueur de javascript favori ou à passer en “mode lecture” (Firefox) 😉
Le Parlement libanais a voté, mardi 11 août 2026, l’abolition de la peine de mort, une première au Moyen-Orient, dans une décision qualifiée d’« historique » par le ministre de la Justice, Adel Nassar. Le pays n’avait plus procédé à des exécutions depuis 2004.
Une personne a écopé d’une amende de 4 550 euros au Svalbard, dans l’Arctique, pour avoir actionné une corne de brume pour réveiller un ours polaire endormi.[…]La réglementation locale dispose qu’« il est interdit de déranger inutilement, d’attirer ou de poursuivre un ours polaire », déclaré espèce protégée au Svalbard en 1972.
Le trafic engendre des coûts que la collectivité doit supporter, souligne l’Université de Bâle dans un communiqué publié lundi. Il s’agit notamment des charges sanitaires liées à la pollution atmosphérique et au bruit, des frais médicaux occasionnés par les accidents de la route, des pertes financières dues au temps passé dans les embouteillages ainsi que des coûts associés aux dommages indirects du changement climatique.
L’extrême droite n’est plus une force politique marginale en Europe. Elle gouverne déjà plusieurs pays, domine la vie politique dans d’autres et influence désormais les principales décisions de l’Union européenne.
On Monday, the US Supreme Court decided in Trump v. Slaughter that the US Federal Trade Commission (“FTC”) may not be independent anymore. Since 2000, the EU has relied on the “independent” FTC as the enforcer of EU-US deals on personal data. According to EU treaty law, such oversight must be independent. In the current EU-US deal, the European Commission relies on the independent FTC 259 ( !) times. Max Schrems : “Given that there are no independent authorities in the US anymore, we call on the European Commission to orderly withdraw the adequacy decision on the US.”
Le 6 août, des bulldozers ont débarqué au sein du parc national de Big Bend, au sud du Texas, aux États-Unis. Des entrepreneurs mandatés par le gouvernement fédéral ont entamé les travaux de construction d’une barrière frontalière le long du Río Grande. « Il s’agit de l’attaque la plus odieuse contre un parc national américain depuis des générations »
The opportunistic pathogen was first identified in 1986 from the brain of a San Diego Zoo monkey, which died from the infection. Since then, only about 200 human cases have been recorded worldwide. About 90 percent of them have been fatal.
President Trump signed an executive order Monday that makes sweeping, unilateral changes to federal vaccine recommendations. The order aims to reduce the number of lifesaving vaccines all children are recommended to get—from 18 to 11—while also splitting them up and spacing them out over more time and more medical visits.
Physics PhD graduates in 2025 left the US at the highest rate in the last 30 years, finds a new AIP report. Of these graduates, non-US citizens left the country at nearly double the rate of the previous year, the largest one-year increase since 1997.
Cela fait plusieurs jours que Donald Trump a annoncé qu’il comptait rendre payant l’accès privilégié à ses publications sur Truth Social. Or, au vu de l’impact que celles-ci ont sur les marchés, la crainte de délits d’initié de grande ampleur s’est fait une place dans l’actualité américaine.
The X1 aircraft is comparable in size to a small regional airliner and can achieve a maximum takeoff weight exceeding 25,000 pounds with the help of four wing-mounted electric motors. The battery-electric propulsion system delivered more than one megawatt of power during the maiden flight.
Alors que les géants américains commencent à adapter leurs modèles à ce règlement européen entré en vigueur il y a dix jours, l’un de ses principaux architectes explique ce que l’on peut réellement faire de cet outil au service de l’autonomie.
Analyzing 30 of the most prominent companies currently in the market, they found that all but one had unlimited access to the consumer’s brain data ; two-thirds could share it with third parties ; and two implied that they were already selling it to third parties. “And if you sell something to a third party, […] they are not held by the original consumer agreement. You cannot be less protected. This is predatory. The companies act like this because there is no regulation. They think, ‘Let me just take possession of it all.’ It’s like the Wild West. You go in there and stake a claim for whatever you can.”
C’est le constat d’une étude publiée le 4 août […] le déploiement des outils d’IA va permettre de diminuer les coûts de forage, de récupérer entre 470 et plus de 1 000 milliards de barils supplémentaires de pétrole dans les gisements existants, et d’exploiter ceux qui étaient autrefois jugés non rentables.
Sous les yeux du monde, les soldats israéliens assassinent des enfants, avec une désinvolture méthodique. Dans leurs rapports, chaque fois, la même effarante litote : « des impacts ont été constatés ».
Des colons israéliens assiègent depuis plusieurs jours des habitations palestiniennes dans ce territoire, laissant les habitant·es sans accès à la nourriture.
Un cybercriminel s’est attaqué cet été au système d’information du fisc et au Serveur professionnel de données cadastrales. Deux à trois millions de Français·es pourraient être concerné·es.
Coup de théâtre après la mort d’un employé sur le chantier de la ligne C du métro toulousain lundi 3 août 2026. L’autopsie a révélé que l’homme de 48 ans a succombé à un écrasement, contrairement à ce qu’affirmait son employeur, qui évoquait un malaise. Une enquête pour “homicide involontaire” a été ouverte par le parquet de Toulouse.
Le Plug Off, festival débranché du réseau électrique, prévu à Plogoff les 22 et 23 août, est annulé, face aux fortes chaleurs et au risque d’incendie dû à la sécheresse.
Deux sapeurs-pompiers étaient décédés en juillet près de Bordeaux après que leur camion avait été « piégé » dans une parcelle de pins livrée aux flammes.
La région Île-de-France a décidé de fermer aux promeneurs les abords de la base nautique de Vaires-Torcy, en Seine-et-Marne, après deux noyades mortelles. Elle condamne ainsi un espace de fraîcheur gratuit, alors que les canicules s’enchaînent.
La designeuse Isabelle Daëron fait partie des dix derniers candidats dont les propositions ont été retenues par la Banque centrale européenne pour dessiner nos futurs billets. Ils seront mis en circulation courant 2030.
Nombre d’athlètes féminines, « moi y compris, se sont retrouvées en compétition à se focaliser davantage sur les caméras que sur leur propre performance », témoigne dans le guide pratique Holly Bradshaw, médaillée de bronze au saut à la perche aux Jeux olympiques de Tokyo en 2021 […] « Les commentateurs jouent également un rôle crucial pour enrichir les retransmissions », souligne-t-elle. Un aspect qui n’est toutefois pas couvert par le guide pratique.
Le Premier Ministre Sébastien Lecornu a rendu public dans un message publié sur X un bilan de la lutte contre la fraude sociale et fiscale “609 millions d’euros recouvrés au titre des fraudes sociales détectées et 11,3 milliards d’euros au titre des fraudes fiscales détectées”
Quand la France vient de brûler et que les Français subissent la cinquième canicule de l’été, présenter le président s’adonnant aux joies des sports nautiques ce n‘était peut-être pas la meilleure des idées.
Après les incendies de 2022 en Gironde, Gérald Darmanin avait promis une base aérienne locale pour que des canadairs puissent éteindre au plus vite les feux naissants. Mais rien n’a été fait. Interrogés, le garde des Sceaux et Bruno Retailleau se renvoient la responsabilité de cette annonce.
Le préfet de Seine-et-Marne a donné son autorisation le 29 juillet pour lancer le chantier de cet immense data center, qui va artificialiser 90 hectares de terres agricoles. Il devrait consommer, à lui seul, autant d’électricité que celle produite par un réacteur nucléaire.
Le préfet du Rhône a interdit ce rassemblement « introduisant une discrimination fondée sur la race et l’origine ethnique » et créant un risque de trouble à l’ordre public.
Lors d’un pot de départ, la BAC de Saint-Denis fait cramer son commissariat à coups de mortiers d’artifice après avoir vidé ses propres extincteurs pour s’amuser
Le pronostic vital du jeune homme est toujours engagé. D’après les premières investigations, ce dernier a doublé une voiture et s’est retourné “pour vérifier qu’il n’était pas suivi”, heurtant le fourgon de CRS qu’il n’avait pas vu.
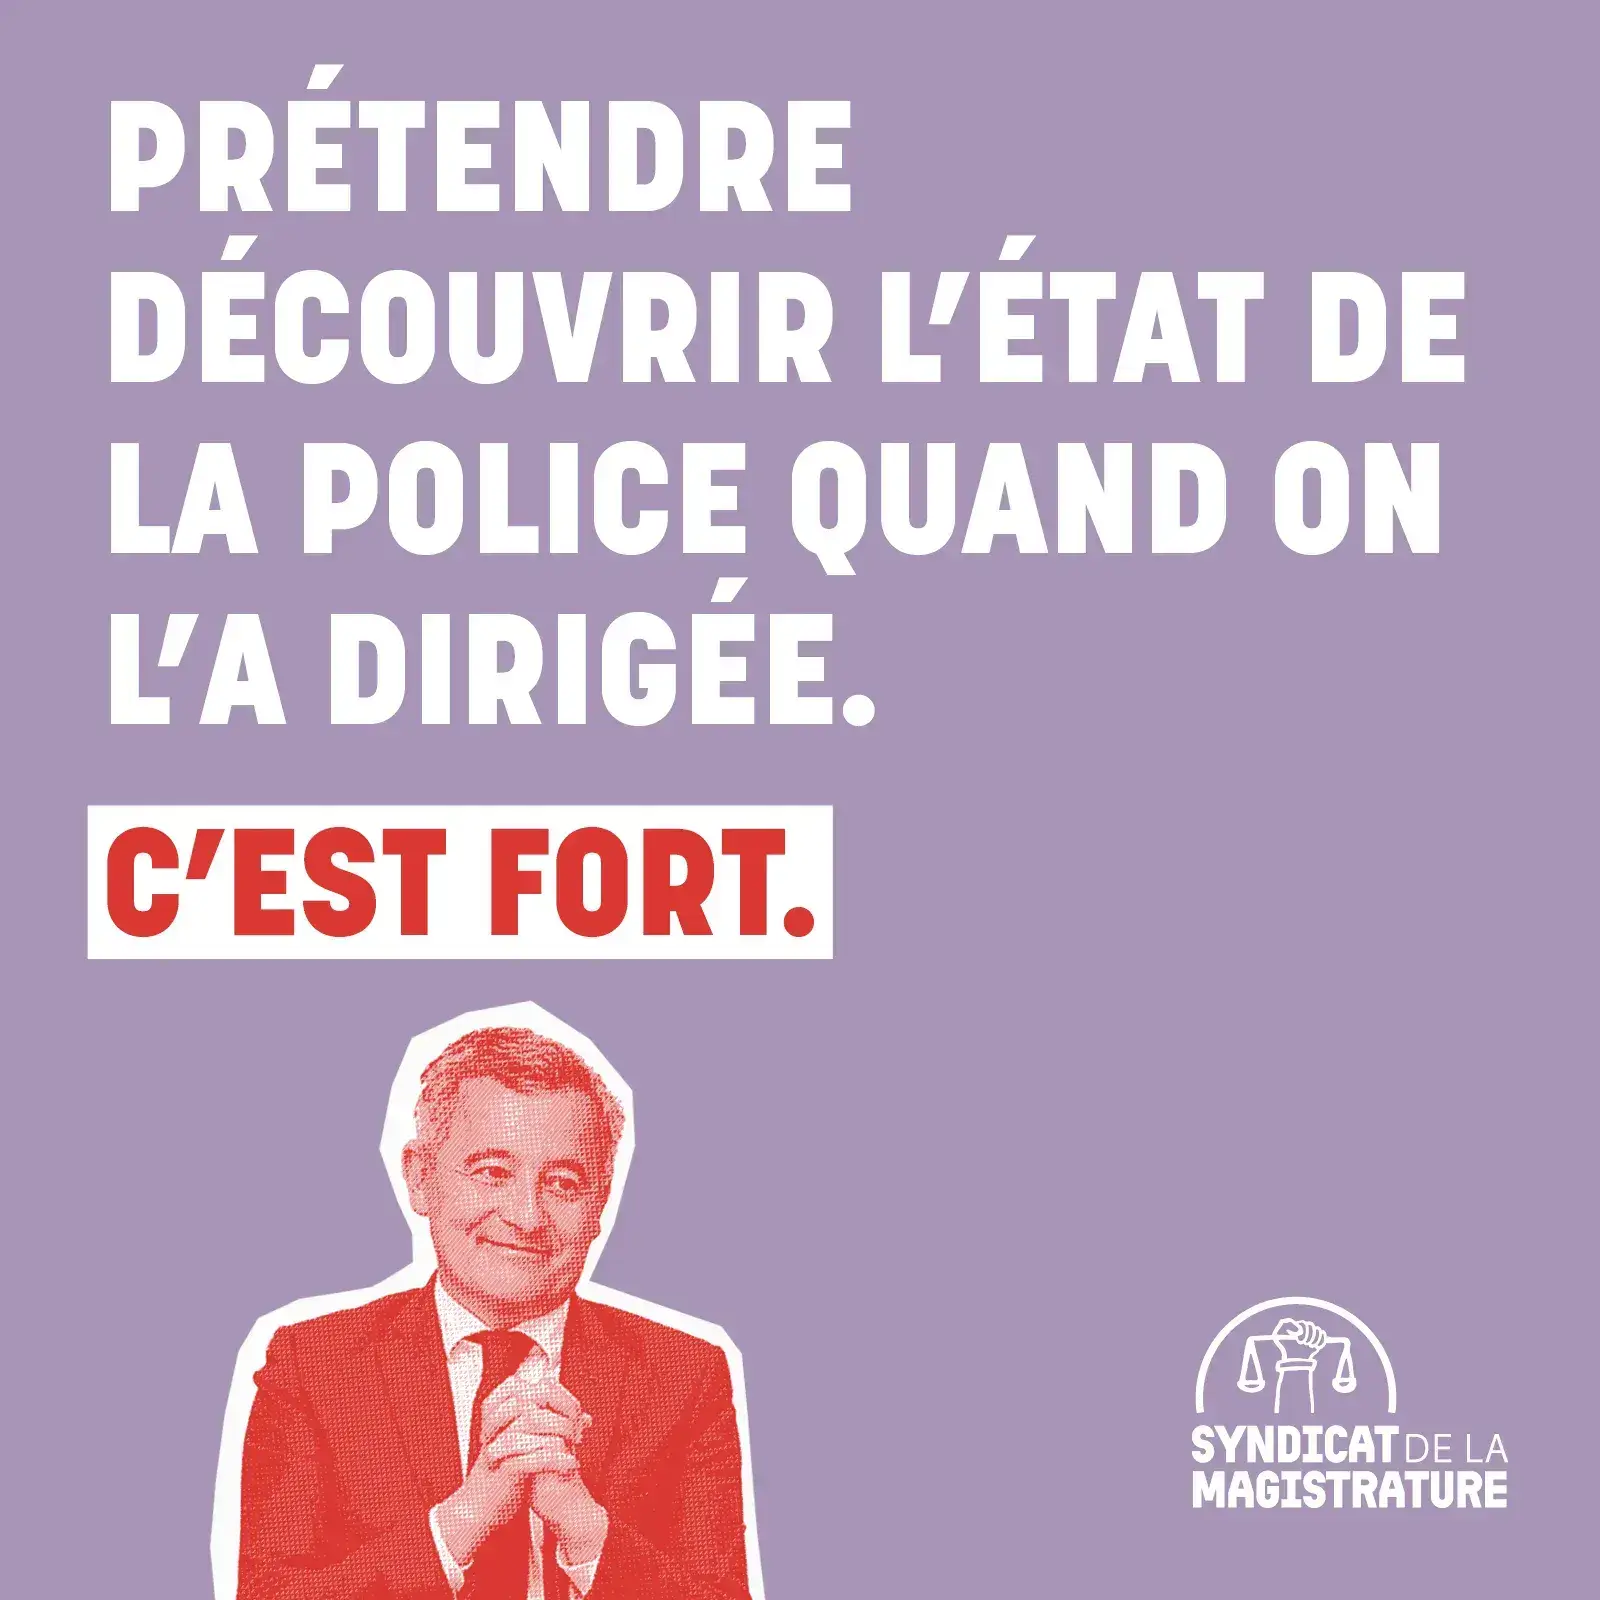
Solidaires du Syndicat de la magistrature victime d’attaques pour avoir critiqué l’instauration d’une présomption de légitime défense pour les policiers et les gendarmes, les signataires de ce texte rappellent le principe de l’indépendance des pouvoirs et le droit des magistrats à la liberté d’expression.
Plus les services publics obligent à utiliser internet pour effectuer des démarches, plus ils fragilisent l’accès à des droits essentiels pour des millions d’usager·es, alerte depuis plusieurs années la défenseure des droits. Deux chercheureuses appellent l’État à garantir un égal accès aux services publics.
Tails a réparé une faille de sécurité critique du noyau Linux. Cette faille permettait à un site internet de désanonymiser un·e utilisateur·ice utilisant Tails. Il est donc urgent de mettre à jour sa version de Tails à 7.10.1 avant toute utilisation de cette distribution Linux réputée pour son haut niveau de sécurité et d’anonymat.
“OneDrive Photos automatically scans your system storage for photos,” and apparently “doesn’t need a Microsoft account to work, as it can also detect your local files.”
En mai 2026, le réseau Internet par satellite Starlink, de la société SpaceX d’Elon Musk, avait réussi à s’implanter dans plus de la moitié des 54 États du continent africain.
Jeudi 30 juillet, des dizaines de milliers de personnes ont convergé depuis le Maroc vers la ville de Ceuta. Au moins 77 personnes sont mortes en essayant de rejoindre l’enclave espagnole, dans une indifférence générale qui souligne une hiérarchisation des vies et un racisme banalisé.
En mêlant information et divertissement, ces feuillets pouvaient paraître quelques jours à peine après un séisme, un incendie, mais aussi relater toutes sortes de faits divers. Retour sur l’histoire d’un format médiatique méconnu, qui a su contourner la censure pour faire circuler des nouvelles dans le Japon d’avant le XXᵉ siècle.
Baltimore has engineered a 68 % drop in homicides since 2019, outpacing the national average—all while operating with 400 fewer officers. Here’s how the city debunked the myth that more police are the only answer to violent crime.
Comme chaque lundi, un coup d’œil dans le rétroviseur pour découvrir les informations que vous avez peut-être ratées la semaine dernière.
Tous les liens listés ci-dessous sont a priori accessibles librement. Si ce n’est pas le cas, pensez à activer votre bloqueur de javascript favori ou à passer en “mode lecture” (Firefox) ;-)
As countries around the world look to follow Australia’s lead in restricting young people’s access to social media, a new report by the eSafety Commissioner might give them reason to pause, at least temporarily.
Des records absolus de température sur terre et en mer, des forêts en feu, des fleuves à sec, une surmortalité importante, et un seuil de + 2 °C qui pourrait être franchi pour la première fois dès le début de l’année 2027.
Eight of the biggest oil companies amassed profits of more than $90bn (£67bn) in just three months as the Iran conflict sent energy prices soaring and the emissions-fuelled climate crisis caused deadly heatwaves.
Starting last week, the German automaker started blasting a promotion for the new Spider-Man movie into its customers’ cars without warning — because nothing says riding in luxury like a full-vehicle pop-up ad. BMW, showing that it was about as in-touch as its drivers are familiar with turn signals, teased the promotion as a “special surprise.”
Selon une nouvelle étude publiée dans Nature Sustainability et relayée par Live Science, environ un cinquième des réservoirs dans le monde sont déjà à haut risque de remplissage par les sédiments, et d’ici 2060, la moitié pourraient devenir inopérants.
Le village indonésien de Somang, dans l’ouest de l’île de Java, était englouti sous les eaux d’un réservoir créé en 2023 pour approvisionner Jakarta. Mais la baisse du niveau de l’eau due à la sécheresse fait réapparaître les ruines de bâtiments.
Six expéditions archéologiques sont en cours en Crimée, sous l’égide de Moscou. Des agents russes sont accusés de fermer les yeux sur le pillage de sites antiques en échange de pots-de-vin, laissant disparaître de précieux vestiges.
En quelques jours, la Hongrie s’est improvisée laboratoire grandeur nature de la sobriété électrique. Pas par amour soudain de la décroissance, mais parce que le Danube, épuisé par la sécheresse, ne fournit presque plus assez d’eau pour refroidir Paks, l’unique centrale nucléaire du pays.
Un projet financé par l’UE et publié en open source peut-il vraiment rester ouvert s’il exige des puces propriétaires ? Le système de vérification de l’âge européen impose l’attestation matérielle, excluant de fait les ROM personnalisées et les environnements Linux indépendants.
Un incident de sécurité impliquant au moins un drone a entraîné la suspension temporaire du trafic à l’aéroport de Leipzig, hub militaire utilisé par l’Otan et pour l’Ukraine, près duquel un avion a heurté un objet volant. Les enquêteurs confirment que le drone portait une charge explosive.
German singer-songwriter Danger Dan and pianist Igor Levit were invited to perform a song titled “Keine Angst” (No Fear) for the 100th episode of a political satire TV show called “Die Anstalt” (The Institution). But shortly before the recording of the program, public broadcaster ZDF withdrew the invitation.
Une enquête OSINT retrace la diffusion des appels au passage et décrit un réseau horizontal, sans commandement apparent, capable de se reconstituer rapidement.
En réponse aux mesures similaires imposées par Rome après l’afflux massif de migrants à Ceuta, l’Espagne va instaurer des contrôles temporaires aux frontières à ses ports et aéroports pour les voyageurs en provenance d’Italie.
Inoffensifs pour l’humain, ces reptiles, qui peuvent dépasser les 2 m de long et sont capables de nager sur de longues distances, représentent toutefois une grande menace pour le lézard des Pityuses (Podarcis pityusensis). Une espèce endémique d’Ibiza et véritable emblème de l’île, qui se retrouve aujourd’hui menacée d’extinction.
Les villes d’Agadir et de Marrakech testent un nouveau revêtement poreux à la place du bitume conventionnel. La surface perméable pourrait refroidir les routes jusqu’à 9°C, notamment grâce à l’évaporation de l’eau.[…] Petit bémol, cependant : une étude de l’université Rutgers a montré que si le béton perméable dégage 25 % à 30 % de chaleur en moins les jours de pluie, il peut en dégager légèrement plus que l’asphalte conventionnel par temps sec et ensoleillé.
As Abelardo de la Espriella takes office as president vowing a new military offensive, the country’s last leftwing rebels are getting ready to fight back
the $2,000 figure covers the successful runs rather than every attempt the model made […] Outside researchers have also noted that OpenAI staff helped prepare the papers and formalize the arguments, with the company saying the mathematical content came from Astra. And nobody outside the company can run the model that did the work, so the result cannot be reproduced independently, only checked.
Studies show, over and over, that when we engage in AI-assisted learning we give up sooner. One found that after just “10 minutes of AI-assisted problem-solving, people who lost access to the AI performed worse and gave up more frequently than those who never used it”. An MIT study showed that test groups who used ChatGPT had the lowest brain activity and “consistently underperformed at neural, linguistic, and behavioural levels”. We undergo not just cognitive offloading, but cognitive surrender : we forget what was possible.
Dans un message publié sur ses réseaux sociaux, le premier ministre israélien a affirmé que Tel-Aviv rejetait le plan de Donald Trump pour Gaza, malgré des garanties sur le désarmement du Hamas. A l’approche des élections législatives, Benyamin Netanyahou ménage ses alliés d’extrême droite qui restent opposés à tout accord de paix dans l’enclave.
Dans la foulée de la décision de l’Unesco, le gouvernement israélien a annoncé, ce 30 juillet, une allocation de 112 millions de shekels (31,8 millions d’euros environ) à l’Administration civile israélienne pour restaurer et développer des sites archéologiques, y compris dans des secteurs relevant théoriquement de l’Autorité palestinienne.
In country after country, more women are dying from the heat than men. But researchers say biology isn’t the main reason. Age, working conditions, and unequal access to rest may drive the gap.
De nombreuses normes de conception reposent encore sur le modèle du « corps masculin par défaut », qui suppose une utilisation rapide des toilettes, en position debout et avec un temps de passage minimal. Lorsque les espaces sont aménagés en fonction du corps et des habitudes des hommes, les retards sont facilement imputés au comportement des femmes
With less than a third of cycling journeys taken by women, Colombia’s capital, Bogotá, is installing bike lanes, teaching cycling and making sure ‘stereotypes are left behind’
« Chaque postier sera intégralement rémunéré malgré la suspension temporaire de son activité », écrivait la direction de la Nouvelle-Aquitaine dans un courrier du 26 juillet […] mais « les heures non réalisées seront reportées ».
Dans les Pyrénées-Orientales, des habitants ont reçu l’ordre d’évacuer des jardins communaux afin que soit créée une « ceinture de protection » contre les incendies. Ils dénoncent la violence de cette décision et l’hypocrisie des autorités locales.
En raison des changements climatiques en cours, la manière de gérer l’eau en France sera déterminante au cours de ce XXIème siècle. Le temps ayant passé, il convient de rappeler la manière dont fut géré le bassin versant de la Seine au XXème siècle. Comparé à la non gestion du cours de la Loire, il donne à voir les bons choix en la matière.
De premières vendanges ont débuté ce 6 août en Champagne. Jamais elles n’avaient eu lieu aussi tôt dans l’année, le signe d’un été record en chaleur et en sécheresse.
30 000 personnes ont été appelées à se confiner pendant plusieurs heures, dimanche 2 août, en raison de l’incendie d’un entrepôt classé Seveso, à Gandrange (Moselle). Un nouvel épisode révélateur de la vulnérabilité des industries à la sécheresse et aux canicules ?
Le jeune homme de 17 ans est le seul homme sélectionné dans l’équipe de France aux Championnats d’Europe qui se déroulent actuellement à Paris. […] Longtemps exclusivement féminine, la natation artistique s’est ouverte récemment aux participants masculins.
45 membres d’un canal Telegram masculiniste ont été interpellés après une enquête du parquet de Paris. 34 seront jugés notamment pour provocation à la haine envers les femmes.
Selon le quotidien « La Provence », le quinquagénaire, déjà connu pour des faits de violence sur son ex-compagne, était colistier du candidat Rassemblement national dans la commune de Bollène, lors des élections municipales de mars.
Plusieurs candidats à l’élection présidentielle ont été récemment visés par des campagnes de désinformation sur les réseaux sociaux. Sans grande visibilité directe pour certaines au moins, elles arrivent quand même à se faire une place dans l’actualité via leur dénonciation par les autorités, les candidats et les médias.
D’abord en pause puis remis à l’ordre du jour cet été, le projet lancé par la présidente de l’Assemblée et chiffré à 52,8 millions d’euros cristallise les critiques.
Saisie par les députés « insoumis », écologistes et communistes, notamment au sujet de la création d’un « état d’alerte de sécurité nationale », l’instance n’a censuré aucune mesure de ce texte
Par un mécanisme d’inversion du blâme, les politiques environnementales et les écologistes sont accusé·es d’entraver la prévention des risques et d’accroître la vulnérabilité des populations.
Le DJ a connu un « torrent de harcèlement » après son tweet en réponse à l’hommage de Jordan Bardella à Kavinsky : « Merci de vous abstenir de cet hommage : la musique électronique vous déteste » […] il est devenu la cible de nombreux messages d’insultes et de menaces, dont il cite des exemples : « On s’en souviendra et tu seras le premier qu’on viendra chercher. »
À l’initiative de l’association Bio Consom’acteurs, près de 1000 personnes ont signé une lettre ouverte au président de la République, Emmanuel Macron, pour exiger un plan d’urgence, d’adaptation et d’atténuation face au réchauffement climatique.
À l’AfricaMuseum de Tervuren, en Belgique, des archives géologiques héritées du Congo belge attisent les convoitises de KoBold Metals, une start-up minière étasunienne dopée à l’IA et soutenue par des milliardaires de la tech.
Meta was paying out-and-out neo-Nazis to post on Facebook, an investigation from Australia’s ABC News found. These pages and individual creators posted content that appeared to be in clear violation of Facebook’s own hate speech policies. Nonetheless, they were able to earn money on their posts through the platform’s “Content Monetization” program — which is invitation-only.
« J’exige qu’elle soit “shut down” [qu’on peut ici traduire par “réduite au silence”] pour trahison envers la France », a écrit le milliardaire au sujet de Marine Tondelier, dans un message vu plus de 400 000 fois.
Longtemps restée dans l’ombre de son mari, Suzanne Césaire a pourtant, dans sa courte carrière littéraire, tracé les lignes d’une identité martiniquaise singulière, ancrée dans son rapport à la terre.
Une méduse de la taille d’un dé à coudre est capable de vivre éternellement, du moins en laboratoire.[…] Dans leur environnement naturel, en revanche, leur prétendue immortalité se heurte à une limite beaucoup plus terre à terre : les prédateurs peuvent tout simplement les dévorer.
Retrouvez les revues de web précédentes dans la catégorie Libre Veille du Framablog.
Les articles, commentaires et autres images qui composent ces « Khrys’presso » n’engagent que moi (Khrys).
Comme chaque lundi, un coup d’œil dans le rétroviseur pour découvrir les informations que vous avez peut-être ratées la semaine dernière.
Tous les liens listés ci-dessous sont a priori accessibles librement. Si ce n’est pas le cas, pensez à activer votre bloqueur de javascript favori ou à passer en “mode lecture” (Firefox) ;-)
Le régime iranien qui fabrique des drones utilisés par la Russie pour ses frappes en Ukraine accuse Kiev d’avoir attaqué un navire iranien en mer Caspienne et menace de représailles.
La Protection civile grecque a ordonné vendredi l’évacuation préventive d’une partie d’une banlieue à l’ouest d’Athènes en raison d’un incendie de forêt, selon un message d’alerte envoyé sur les téléphones portables. Par ailleurs, l’île touristique de Crète était toujours la proie des flammes, poussées par des vents violents malgré une certaine amélioration, selon les pompiers.
Changement de Constitution, partisans de l’ancien régime traqués, manifestations réprimées, corruption… La gouvernance de Félix Tshisekedi est de plus en plus soumise aux critiques tandis que la situation dans l’Est ne progresse pas, au contraire de l’épidémie d’Ebola, devenue incontrôlable.
Les grandes surfaces commerciales en Tunisie font face à une tension sur l’approvisionnement en eau minérale conditionnée, dans un contexte marqué par une forte hausse de la consommation liée aux températures élevées enregistrées ces dernières semaines.
L’Italie a formulé cette proposition, soutenue par le Danemark et la Finlande, après l’afflux massif de migrants ces derniers jours dans l’enclave espagnole au Maroc.
Le dirigeant socialiste espagnol a adressé une lettre offensive aux dirigeant·es de l’UE. Il déplore notamment une attitude « contraire » au principe de solidarité dans l’Union.
C’est par voie de presse que les dessinateurs de presse Cristina et André Carrilho, membres de Cartooning for Peace, ont découvert leurs noms sur une liste d’individus et d’entités désignés comme des « cibles » et « menaces » pour le pays, établie par le Movimento Armilar Lusitano (MAL), un mouvement armé portugais d’extrême droite.
I reported this on January 3rd, 2026. It is now July 24th. Six months later. The vulnerability is still live. Nobody has ever responded. I guess my email wasn’t in their prayers.
Flock cameras have been in St. Pete since 2022, and while police say they help solve crimes, civil liberties advocates say they create an unprecedented mass surveillance network.
Had the case been properly investigated, the court says now, evidence “would have identified an individual whose first name is Jay whose IP address appears to be in California.”
Le président américain a crié sur tous les toits que du « vandalisme » expliquait le fiasco de la rénovation de l’étendue d’eau, mais la justice a conclu que l’« installation bâclée » est en cause.
The finding appears to be a setback to Kennedy’s Make America Healthy Again agenda, which has typically focused on overhauling nutrition guidance while neglecting food safety and infectious diseases.
Jusqu’à récemment, la vaccination contre la rougeole semblait si efficace que le développement de traitements contre la maladie n’avait aucun intérêt, médicalement comme financièrement […] alors que les taux de vaccination déclinent, des entreprises biotechnologiques et des instituts universitaires se penchent sur des traitements spécifiques
Dans l’imaginaire collectif, la silicose, grave maladie incurable qui détruit la fonction pulmonaire, est associée au travail des mineurs. Mais d’autres ouvriers y sont exposés. C’est notamment le cas de ceux qui travaillent la pierre synthétique, ou quartz aggloméré, qui voient également leur risque de cancer du poumon augmenter.
« C’est presque exclusivement des séquences tout public, montrant des marmottes en train de jouer, de se comporter de manière adorable, de creuser ou de rapporter des plantes dans leur terrier… bref, leur routine quotidienne »
Le 24 juin à 22h, deux tremblements de terre de magnitude 7,2 et 7,5 ont violemment secoué le Venezuela. Il s’agit du plus puissant séisme à avoir frappé le pays depuis au moins l’année 1900. Au moins 5500 morts et 16700 blessés et entre 10 000 et 50 000 personnes sont encore portées disparues. 16 000 personnes sont sans logement et 856 bâtiments sont sinistrés.
Anthropic’s Project Glasswing may have uncovered tens of thousands of potential security flaws, but new research suggests AI-assisted vulnerability discovery has yet to produce the wave of real-world attacks many expected.
Le projet Debian débat de quatre propositions allant de l’interdiction des contributions directes assistées par IA à leur autorisation sous conditions. Derrière la qualité du code se joue surtout la protection des mainteneureuses bénévoles.
What it will come down to is whether the anti-AI groups in FOSS can work together and help each other to hold off the vast and commercially backed pressure from LLM-assisted and LLM-generated code, even though they may find themselves bitterly opposed in terms of politics and ethics.
Claude is exposing a wealth of users’ chats and creations in Google search results, meaning anyone can dig through conversations or other material that people used Claude to make but may not have realized were publicly available for strangers to see. The exposed data includes an AI-powered therapy app that someone appears to have vibe-coded, notes on meetings, and a dashboard someone made apparently to analyze medical billing data. Exposed chats reportedly include private cryptocurrency wallet keys and personal information like peoples’ addresses
Google’s aborted attempt to incorporate its Nano Banana 2 AI image generator as a Google Earth feature made it even easier for anyone to create modified versions of authentic imagery depicting real locations—something that Google boasted about when initially promoting the new feature.
Gaps in laws may help Pennsylvania high school escape AI nudes scandal.One of the first schools to shut down after students were found making AI nudes of female classmates is now asking a court to toss a lawsuit filed by victims who claimed that the school stayed silent for months while the emboldened boys targeted many more girls.
Our investigation found that Hugging Face, the top platform for sharing open-source AI models, isn’t just hosting tools that generate non-consensual intimate imagery. It’s helping users compare, benchmark and optimize them, making image-based sexual abuse easier to scale.
A senior judge has accused the Home Office of relying on “AI hallucinated” information to refuse an asylum claim. The case relates to a Moroccan woman and her child who fled her country after experiencing forced underage marriage and extreme violence, including rape. The woman claimed asylum on the basis of fears that she would be killed by her husband : a powerful, previously convicted criminal. The Home Office refused her case, citing evidence from a supposedly independent and authoritative document known as a country policy information note (CPIN), which they said confirmed that Morocco would be safe for her. But the document could not be found, although its existence was relied upon by a judge who rejected her appeal against the Home Office’s refusal decision in an immigration court known as the first-tier tribunal.
Dans la Silicon Valley, les fleurons de l’intelligence artificielle font face à des menaces grandissantes, numériques, mais aussi physiques dans les bureaux ou au domicile des dirigeants.
L’InP, c’est un symbole de notre foi aveugle dans l’innovation : on croit résoudre un problème (l’efficacité énergétique de l’IA) en en créant un autre (la dépendance aux matériaux critiques)
D’après la BBC, il est interdit d’afficher en public des emblèmes nationaux étrangers, tels que des drapeaux, sans autorisation. Les personnes qui ne respectent pas cette règle s’exposent à une amende pouvant aller jusqu’à 500 dollars singapouriens (soit environ 338 euros) et une peine d’emprisonnement pouvant aller jusqu’à six mois.
Mme Albanese est la cible d’attaques incessantes de la part d’organisations motivées politiquement, telles que UN Watch, qui mènent des campagnes de diffamation virulentes pour la réduire au silence et saper son mandat en matière de droits humains. Ces organisations n’ont qu’un seul objectif : protéger le gouvernement israélien de toute critique internationale et de toute responsabilité juridique. Malheureusement, des représentants de certains gouvernements occidentaux ont apporté un soutien indéfectible à ces campagnes de diffamation, accusant Mme Albanese d’antisémitisme. Nous rejetons ces accusations, qui sont infondées et incitent de manière irresponsable à des attaques contre Mme Albanese, mettant potentiellement sa sécurité personnelle en danger.
Le Britannique était visé par une procédure disciplinaire pour faute grave, liée à des accusations d’une collaboratrice. Cette décision survient au moment où la juridiction fait face à une pression croissante des Etats-Unis et d’Israël contre ses enquêtes sur les crimes commis dans les territoires palestiniens.
La périménopause, […] est par exemple peu documentée. Elle n’a fait son entrée dans le Larousse que cette année. La ménopause a, elle aussi, longtemps été traitée avec un mépris manifeste. Dans les années 1960, un médecin réputé de l’époque, Roger Wilson, allait jusqu’à qualifier de « vaches écervelées » les femmes ménopausées.
Le pareur lituanien à l’origine du sabotage a été suspendu de ses fonctions à vie, après qu’il a revendiqué son acte raciste et proféré de nouvelles insultes.
L’acteur américain se voit reprocher des « comportements sexuels délictueux » par quatre femmes. D’autres témoignages font état de comportements inappropriés vis-à-vis d’adolescentes.
Comment choisir une plateforme parmi 140 payantes ? La réforme de la facturation électronique concerne plus de dix millions d’entreprises, mais les craintes sont fortes chez beaucoup de petites structures paysannes ou artisanes, comme pour les auto-entreprises.
La Société Générale affiche, jeudi 30 juillet, un bénéfice net de 1,79 milliard d’euros pour son deuxième trimestre, du jamais-vu. La banque signe également un bénéfice record à l’échelle du semestre, à près de 3,5 milliards d’euros. En janvier dernier, le groupe annonçant la suppression de 1 800 postes en France.
Le Conseil constitutionnel a estimé, vendredi 31 juillet, que le code des collectivités qui a valu des amendes à Airbnb, pour un total de 8,6 millions d’euros, est conforme à la Constitution.
Pour trouver l’aire d’accueil des gens du voyage d’Hellemmes-Ronchin, en périphérie de Lille, il ne faut pas suivre les panneaux routiers — inexistants — mais plutôt les camions toupie en route vers l’usine à béton. Là, coincée entre une concasserie de gravats et un grand champ de blé, se dresse un parking poussiéreux, sans un seul point ombragé.
Enterrés dans un champ calciné, à quelques mètres des habitations [du Porge], ils ont explosé sous l’effet de la chaleur au deuxième soir de l’incendie, dans la nuit du 23 au 24 juillet. L’un d’eux a même perforé le mur d’une maison évacuée.[…] Depuis, 75 obus ont été retrouvés, venus d’un dépôt de munitions oublié datant de la Seconde Guerre mondiale, selon la municipalité.
Ces habitant·es soutiennent que la commune a été abandonnée face au feu, avec un résultat catastrophique puisque près de 200 maisons ont été détruites.
Au Cap-Ferret, menacé par les violents incendies en Gironde, l’homme d’affaires Benoît Bartherotte et des ostréiculteurs ont refusé d’évacuer pour protéger la presqu’île. Pendant que le premier érige un pare-feu controversé, les seconds se battent pour sauver leurs huîtres et leur outil de travail.
Aux yeux des assureurs, un feu de forêt ne coche pas les cases de la garantie Cat-Nat, le régime d’indemnisation des dommages majeurs causés par un événement naturel.
Connu pour ses tubes Nightcall, Roadgame, Testarossa Autodrive ou Rampage, Kavinsky a marqué toute une génération d’artistes, notamment ceux de la French Touch avec qui il collaborait régulièrement. L’annonce de sa disparition soudaine, trois jours avant son 51e anniversaire, a donc été vécue comme un choc dans le monde de la musique électro, mais pas uniquement.
L’ouverture de l’assistance médicale à la procréation pour les couples de femmes et les femmes seules fête ses cinq ans. Entre les délais d’attente, les inégalités d’accès et les discriminations persistantes, associations et professionnels de santé dressent un bilan très critique.
Sur sa page Facebook privée, le président du syndicat agricole de l’Oise Régis Desrumaux a violemment attaqué Marine Tondelier, secrétaire nationale d’Europe Ecologie les Verts, suite au vote de la loi d’urgence agricole.
Marine Tondelier exige « des excuses publiques » de la part d’un responsable de la FDSEA de l’Oise qui a fini par s’exécuter après l’avoir insulté de « grosse salope » sur Facebook. Si la patronne des Écologistes a reçu le soutien unanime des élus de gauche, cet événement met de nouveau en lumière le sexisme en politique.
Le chanteur de 67 ans est visé par deux nouvelles plaintes, l’une pour viol, l’autre pour agression sexuelle. Les faits dénoncés remontent à 1994 et 2005.
Derrière les promesses de « sororité » et de « reconstruction », se cachent parfois des structures qui s’apparentent à des organisations pyramidales. Dans le sud-ouest de la France ou en région parisienne, des réseaux de coaching attirent les victimes de violences conjugales via des stratégies dignes des plus agressives écoles de commerce.
« L’islamo-gauchisme et le wokisme ont gagné » […] « Je défends l’idée qu’Israël est une démocratie. Je constate que les preuves d’un génocide à Gaza restent introuvables. Je pense qu’on peut parler sans détour d’un antisémitisme musulman. »
« La seule solution qu’on nous offre, ce sont des masques FFP2, en quantité limitée, et qui ne sont pas résistants au feu » […] Pourtant, il existe bien de nouvelles cagoules, filtrantes celles-ci, qui ont été intégrées depuis 2019 dans le référentiel technique de la Direction générale de la sécurité civile
Pour nombre d’observateurs, [la FNSEA] a perdu une partie de sa capacité d’influence politique. Mais c’est justement dans ce contexte qu’il devient essentiel pour le syndicat de l’agro-industrie de renforcer ses appuis politiques, en particulier issus de la droite traditionnelle, son alliée historique.
La promulgation de cette loi est désormais suspendue, depuis le 24 juillet 2026, à la saisine du Conseil constitutionnel entreprise par plusieurs député·es « insoumis » et écologistes.
Ces derniers jours, environ 40 000 migrants ont traversé la frontière entre le Maroc et l’enclave espagnole de Ceuta.Ils n’auraient pas pu réagir plus vite. Pour servir leur discours, de nombreux dirigeants politiques français, à droite, à l’extrême droite, mais également chez les macronistes, sautent sur les vidéos en provenance de Ceuta
Jardins, écoquartiers, ferme municipale… Une fois élus, les maires d’extrême droite ne s’attaquent pas qu’à la culture et aux syndicats. Ils sabotent aussi des projets écologiques.
Un homme de 28 ans a été condamné à trois mois de prison avec sursis pour avoir fait ce geste en marge de la manifestation du 8 mars pour le droit des femmes. Il était jugé pour apologie de crime ou de délit. […] cet homme avait été candidat aux élections municipales à Mulhouse sur la liste du parti d’extrême-droite Reconquête
« Le dernier jour du festival, une fête tolérée a été organisée par le collectif [La Méandre] dans leurs locaux. On y était nombreux.ses et c’était super. Jusqu’à ce que la police puis 15 camions de CRS nous rejoignent et là c’était carrément moins festif »
les associations Data for Good, Humanité et Nature et France Nature Environnement Bouches-du-Rhône déposent des recours contre l’autorisation environnementale accordée par la préfecture au projet de centres de données de Pennes-Mirabeau.
Deux semaines après son lancement, la plateforme de recensement de victimes directes du changement climatique rassemble 105 000 personnes et plus de 30 000 témoignages. Son objectif : que « l’État regarde leurs réalités et agisse ».
Le tribunal administratif de Poitiers a ordonné le démantèlement de quatre réserves d’eau illégales à la lisière des Deux-Sèvres et de la Charente-Maritime. Une décision qualifiée d’historique par BNM.
Après une semaine de blocage, de nuits passées dans la canopée et de vives tensions, la mobilisation a payé. Ce mercredi 22 juillet, le maire de Jouy a officiellement signé un arrêté municipal garantissant la conservation et la protection des six tilleuls centenaires. Au pied des arbres, l’heure est à la fête et au bilan d’une lutte exemplaire.
Le géant Amazon profite de sa position dominante pour peser de tout son poids sur chaque maillon de la chaîne du livre. Ou comment la vente en ligne peut mettre en péril la « bibliodiversité ».
Alors que Tchap est devenue la messagerie sécurisée de référence de l’État, la France cherche désormais à étendre sa stratégie de souveraineté numérique à l’échelle européenne en promouvant le protocole Matrix auprès d’autres pays.
Alors que la justice a retenu la circonstance aggravante de racisme dans le meurtre de Thomas à Crépol, le racisme anti-Blanc s’invite à nouveau dans le débat public.
Au milieu des flammes, les écologistes sont mis en accusation. Stratégie de déni qui rappelle l’antiféminisme. Écologie et féminisme contestent l’actuel modèle économique : il valorise la destruction du vivant bien plus que sa préservation
la police de Delhi a déployé autour du site de protestation une infrastructure de surveillance […] Tours de surveillance, reconnaissance faciale assistée par l’IA, caméras à 360 degrés, caméras-piétons, unités mobiles et même lunettes intelligentes Meta ont créé un environnement dans lequel presque chaque déplacement des manifestants pouvait être enregistré, analysé et archivé.
En Argentine, la dictature n’a pas seulement imposé la terreur et le néolibéralisme : elle a également laissé une empreinte durable sur la façon dont le camp populaire pense la démocratie
Unlike some of Nolan’s other films, The Odyssey is not boring, thanks to the source material, which is impossible to mess up entirely. It’s a family-friendly audiovisual spectacle, like an elaborate Fourth of July fireworks display – and with about the same level of narrative and emotional depth.
Depuis plus d’un siècle, la France et l’Espagne se partagent l’administration de l’île des Faisans, un petit bout de terre posé au milieu de la Bidassoa. Du 1er août au 31 janvier, le plus petit condominium au monde est français, et le reste du temps, il est espagnol
Face à l’annonce irresponsable de Microsoft de ne plus mettre à jour son système d’exploitation Windows 10, qui va rendre obsolète plus de 400 millions d’ordinateurs dans le monde, la Ville a décidé de convertir progressivement les ordinateurs qu’elle fournit aux écoles sous Linux, le système d’exploitation libre et gratuit. Une expérimentation est ainsi menée dans trois écoles élémentaires. Une opportunité éducative mais aussi environnementale qui prolongera la durée de vie des ordinateurs.
« Le castor est un véritable ingénieur de son écosystème. S’il constate que le niveau du cours d’eau baisse, notamment lors des sécheresses, il construit des barrages, qui retiennent l’eau. Il participe aussi à la stabilisation des berges en faisant tomber les grands arbres tout en conservant leurs systèmes racinaires »
La coiffeuse Janet Stephens a corrigé une erreur de longue date dans l’interprétation des sculptures romaines. Pour faire tenir les cheveux, il fallait en fait une aiguille et du fil.
Retrouvez les revues de web précédentes dans la catégorie Libre Veille du Framablog.
Les articles, commentaires et autres images qui composent ces « Khrys’presso » n’engagent que moi (Khrys).
Vous apprenez l'audit d'accessibilité numérique sans entreprise pour vous encadrer ? Découvrez des pistes concrètes pour vous entraîner en autonomie et progresser vers la certification avec sérénité.
Quand on audite un menu de navigation, est-ce pertinent de signaler une erreur si l’état « survolé » d’un lien est indiqué seulement par un changement de couleur ?
Tout le monde connaît Wikipédia. Mais connaissez-vous Wikidata ?
Wikidata fait partie de la longue liste de projets gérés par la Fondation Wikimedia, au même titre que Wikipédia, Wikimedia Commons ou Wiktionnaire. Là où Wikipédia stocke de la connaissance sous forme de texte, donc de donnée non structurée, Wikidata fait exactement l'inverse : il stocke et expose des entités liées entre elles. Cela revient à construire un immense graphe de connaissance, dans lequel chaque personne, organisation, lieu ou concept est relié aux autres par des attributs lisibles par une machine.
Wikidata, qu'est-ce que c'est exactement ?
Wikidata est une base de connaissance libre, collaborative et multilingue. Chaque entité y porte un identifiant unique : un Q pour les éléments (Q42 pour Douglas Adams, par exemple) et un P pour les propriétés (P50 pour l'auteur, P19 pour le lieu de naissance). En assemblant ces briques, on obtient des affirmations du type sujet, prédicat, objet : ce que le monde de la donnée appelle un triplet RDF.
Le volume donne le vertige. Wikidata dépassait déjà 1,5 milliard de triplets sémantiques à la mi-2024 [1]. Et toute cette donnée n'est pas seulement consultable à la main : elle est interrogeable par requête, via un point d'accès SPARQL public [2]. On peut ainsi demander « tous les écrivains français nés à Nantes » et obtenir une réponse exploitable, là où une recherche classique ne renverrait qu'une liste de pages à lire.
#!/usr/bin/env bash
# Liste les écrivains nés à Nantes via le point d'accès SPARQL de Wikidata.
# Dépendances : curl et jq.

ENDPOINT="https://query.wikidata.org/sparql"

# Q5 = être humain, P106 = occupation, Q36180 = écrivain,
# P19 = lieu de naissance, Q12191 = Nantes.
QUERY='SELECT ?ecrivain ?ecrivainLabel WHERE {
  ?ecrivain wdt:P31 wd:Q5 ;
            wdt:P106 wd:Q36180 ;
            wdt:P19 wd:Q12191 .
  SERVICE wikibase:label { bd:serviceParam wikibase:language "fr,en". }
}
ORDER BY ?ecrivainLabel'

# Wikimedia impose un User-Agent descriptif, sous peine de blocage (HTTP 429).
curl -s -G "$ENDPOINT" \
  --data-urlencode "query=$QUERY" \
  -H "Accept: application/sparql-results+json" \
  -H "User-Agent: Geeek-demo/1.0 (https://www.geeek.org)" \
  | jq -r '.results.bindings[].ecrivainLabel.value'
Comment fonctionne Wikidata ?
Sur le fond, Wikidata est une base de données orientée graphe, alimentée par des contributeurs et des imports automatisés. Sa logique n'est pas isolée : elle appartient à la même famille que les données structurées que l'on retrouve aujourd'hui sur une majorité de pages Web, ces blocs JSON-LD qui décrivent un article, une FAQ ou une organisation au format Schema.org.
C'est le même esprit, celui du Linked Open Data : décrire le monde de façon explicite pour que les machines le comprennent sans deviner. Quand vous injectez un JSON-LD sur l'une de vos pages, comme je l'ai détaillé dans mon article sur les microdonnées FAQ en JSON-LD, vous appliquez cette logique à l'échelle d'une page. Wikidata l'applique à l'échelle de la connaissance mondiale.
Pourquoi les LLM apprécient autant Wikidata ?
Pour construire un modèle de langage, il faut de la connaissance, et surtout de la connaissance de haute qualité si l'on veut limiter les hallucinations au moment des requêtes. Or la donnée disponible sur Internet est partout : sites de presse, blogs, forums, dépôts de code comme GitHub pour le monde informatique, et bases ouvertes comme Wikipédia pour la connaissance du monde.
Chaque source possède un niveau de fiabilité différent. Un modèle considérera spontanément une fiche Wikipédia comme plus solide qu'un message de forum. Wikidata pousse ce raisonnement un cran plus loin : la donnée y est non seulement fiable, mais déjà structurée et reliée. Pour un LLM, c'est la différence entre lire un paragraphe et consulter une fiche prête à l'emploi.
Trois usages expliquent cet engouement :
Wikidata alimente le Knowledge Graph de Google, donc les fameux encarts de connaissance affichés à droite des résultats [3].
Wikidata figure parmi les bases de connaissances ouvertes les plus réutilisées pour entraîner et ancrer les modèles de langage [4]. Une entité bien décrite y a davantage de chances d'être reconnue, correctement attribuée et citée avec assurance.
Wikidata est interrogeable en direct par les agents, via SPARQL, pour aller chercher un fait vérifié au lieu de le reconstituer de mémoire.
Vous comprenez pourquoi cette base pèse lourd dans une stratégie de Generative Engine Optimization (GEO). Être présent et bien décrit dans Wikidata, c'est exister proprement dans l'écosystème qui nourrit l'IA, et cela d'un seul coup pour de nombreux systèmes à la fois.
Tout le monde peut-il entrer dans Wikidata ?
C'est là que je m'étais trompé. Je pensais au départ que Wikidata était au moins aussi sélectif que Wikipédia, et qu'une « notoriété publique » était indispensable. En réalité, c'est l'inverse : les critères d'admissibilité de Wikidata sont volontairement plus souples [5].
Un élément est accepté dès lors qu'il remplit au moins un de ces trois critères :
Il possède un lien valide vers une page d'un projet Wikimedia (un article Wikipédia dans n'importe quelle langue, une catégorie Commons, une page Wikisource, etc.). Si vous disposez déjà d'une fiche Wikipédia, même dans une langue exotique, vous êtes automatiquement admissible.
Il désigne une entité clairement identifiable, matérielle ou conceptuelle, que l'on peut décrire à l'aide de sources sérieuses et publiquement accessibles. C'est le critère le plus accessible, et celui que remplissent la plupart des personnes et organisations. Les identifiants délivrés par des tiers faisant autorité (VIAF, ISNI, identifiant BnF, GND, registres officiels) renforcent fortement cette admissibilité. Attention toutefois : un identifiant que l'on alimente soi-même, comme un ORCID, constitue un signal beaucoup plus faible aux yeux des administrateurs.
Il répond à un besoin structurel, c'est-à-dire qu'il rend plus utiles les affirmations portées par d'autres éléments. L'auteur d'un ouvrage référencé, le développeur d'un logiciel notable ou le membre d'une organisation connue entre dans cette catégorie.
La barre est donc plus proche de « existence vérifiable » que de « célébrité ». Deux nuances méritent toutefois d'être posées clairement. D'abord, le critère 2 reste volontairement flou, au point de faire l'objet de discussions de réforme au sein de la communauté [6]. Ensuite, et c'est le point important, l'auto-promotion est explicitement découragée. Créer soi-même son propre élément relève du conflit d'intérêts [7], et un élément sans la moindre source finit supprimé. L'admissibilité large ne signifie pas absence de garde-fous.
Mon retour d'expérience
Je ne vais pas vous faire la leçon, car je me suis pris ce mur en pleine figure. J'ai tenté de créer ma propre entité Wikidata, ainsi que celle du blog. Quelques jours plus tard, un administrateur (Madamebiblio) a supprimé les deux fiches indiquant que celles-ci ne répondent pas aux exigences de notabilité [5:1].
Avec le recul, le verdict était écrit d'avance, et il illustre exactement les garde-fous décrits plus haut. En créant moi-même ces éléments, je me plaçais d'emblée en situation de conflit d'intérêts, ce que la communauté décourage explicitement. Et mes fiches manquaient de ce qui fait tenir un élément : non pas mes propres profils ou mon propre site, mais des sources indépendantes et des identifiants d'autorité délivrés par des tiers. Un ORCID que l'on remplit soi-même ne prouve rien aux yeux d'un administrateur. Une notice BnF ou VIAF, générée parce qu'une bibliothèque a catalogué un ouvrage publié, pèse infiniment plus lourd. La leçon est claire : sur Wikidata, on ne décrète pas sa propre notoriété, on la laisse se constater par des traces externes que l'on ne contrôle pas.
Conclusion
Wikidata est sans doute l'un des projets les plus sous-estimés de la galaxie Wikimedia. Invisible pour le grand public, il est pourtant devenu une couche d'infrastructure essentielle : il structure la connaissance, alimente les moteurs de recherche et nourrit les modèles de langage. Pour quiconque travaille la visibilité de ses contenus à l'ère de l'IA, comprendre Wikidata n'est plus une curiosité d'érudit, c'est un sujet de fond.
Estimation de mi-2024, en croissance constante depuis. Les compteurs à jour (nombre d'éléments et de triplets) figurent sur la page Wikidata:Statistics. ↩︎
Google a fermé Freebase, qui alimentait historiquement son Knowledge Graph, et en a migré les données vers Wikidata à partir de 2015. Voir Thomas Pellissier Tanon et al., « From Freebase to Wikidata: The Great Migration », WWW 2016, ainsi que la fiche Freebase : https://en.wikipedia.org/wiki/Freebase_(database)↩︎
Wikidata est régulièrement citée parmi les bases ouvertes réutilisées pour entraîner ou ancrer les modèles. La composition précise des corpus d'entraînement reste cependant rarement documentée publiquement par les laboratoires. ↩︎
Using SEO (search engine optimization) to justify accessibility was only ever a technique for bosses or clients or stakeholders who see accessibility as a cost center and are typically driven more by dashboards or money. Ideally, you want to get past that ASAP to drive better outcomes for humans, not SERPs (search engine results pages). I get it as a foot-in-the-door tactic — hopefully it goes no further.
But SEO also drove bad accessibility practices, such as alt text keyword stuffing, low-contrast text, verbose headings, link text built around keywords, gratuitous landing pages, and more. Karl does a good job of demonstrating how little SEO and accessibility are connected. As such, I’ve always been wary of companies pitching accessibility and SEO in their marketing.
Now I see companies pitching accessible & “AI-ready” or “agent friendly” work, often still including SEO. I’m calling foul.
We’ve already seen anti-user guidance from LLM companies asking for their notion of accessible sites. Never mind that these PhD-level genius LLM tools can’t handle a general site most kids navigate with ease. Let’s ignore the failure of that technology and instead start slapping misunderstood ARIA attributes on all our pages instead.
Sure, there’s overlap between SEO and LLM-thieving. SEO and accessibility even have slight overlap. But accessibility is about people. Twisting a human affordance to feed these corporate efforts to make humans redundant (among all the other harms) is a signal. Different people will read that signal in different ways. If it sells work and you still focus on humans first, cool.
But to me that signal says you aren’t serious about the work. That your TESCREAL patch is just waiting to get sewn on. I’m trying to be less absolutist, less black-and-white. But boy is it hard given what I see every time I peel back the veneer.
Comme chaque lundi, un coup d’œil dans le rétroviseur pour découvrir les informations que vous avez peut-être ratées la semaine dernière.
Tous les liens listés ci-dessous sont a priori accessibles librement. Si ce n’est pas le cas, pensez à activer votre bloqueur de javascript favori ou à passer en “mode lecture” (Firefox) ;-)
Au Ghana, aux États-Unis ou en Turquie, les droits des personnes LGBTQI+ sont attaqués. Ces offensives sont d’autant plus visibles en ce mois où les marches des fiertés, ou prides, ont lieu aux quatre coins du monde.
Le continent européen se réchauffe bien plus vite que n’importe quel autre, alerte l’OMS. Un phénomène dont les répercussions sont d’ores et déjà visibles, alors que les décès prématurés dus à des vagues de canicules se multiplient en Italie, Espagne ou encore en Grèce.
Cela fait 1 566 jours aujourd’hui depuis que l’armée russe à lancée une guerre à grande échelle contre l’Ukraine, en février 2022. Lorsqu’on prend en compte l’annexion de la Crimée en 2014, cela fait 4 492 jours que l’Ukraine subit l’agression russe – deux fois plus que la Seconde Guerre mondiale.
Depuis une vingtaine d’années, de nombreux pays africains ont adopté des technologies biométriques pour enregistrer ou identifier les électeurices, avec la promesse récurrente de réduire certaines fraudes et d’améliorer la qualité des scrutins.
l’est de la RDC constitue un terrain propice à ce type de contagion : la déforestation causée par l’exploitation minière pousse les animaux contaminés vers les villes, tandis que les nombreux conflits armés parquent les réfugiés dans des camps propices à la propagation des virus.
The EU’s biometric-based Entry-Exit System (EES) may continue to cause long queues at borders for another two years, a Frontex official has said. At the same time, the travel industry warns that queues could divert holidaymakers to other destinations, causing EU countries to potentially lose billions in visitor spending.
Les élections du 17 mai dernier au Parlement d’Andalousie, qui décident de la composition du gouvernement régional, ont constitué une surprise pour certain·es et un choc pour le système des partis andalous, qui pourrait avoir des répercussions possibles à l’échelle de l’État espagnol. Le catalyseur de ce basculement est le résultat obtenu par Adelante Andalucía (AA), une coalition de la gauche radicale
il nous semble essentiel d’affirmer que l’immigration est un fait positif, que nous sommes en capacité d’accueillir plus de monde et que nous devons le faire. Ce qu’il se passe en Espagne actuellement montre que ce projet est possible et qu’il est porté par toute une partie de la société civile.
In recent days you will have read various articles announcing the arrival of Euro-Office, which is being “marketed” as the first open-source office suite developed in Europe. We feel compelled — reluctantly, since open source should rest on transparency, not deception — to correct this claim. The first open-source office suite developed in Europe was OpenOffice.org in 2001, based on StarOffice’s source code, followed by LibreOffice from 2010.
As Congress advances anti-LGBTQ+ legislation and states expand restrictions on queer and trans visibility, PEN America experts warn the tactics increasingly resemble those used by modern authoritarian governments.
Plusieurs collectifs et assemblées comptent bien perturber l’inauguration de ce “Mondial de la dépossession et de la guerre” et dont 13 matchs se joueront au Mexique. Autour de l’Assemblée “antimundialista”, des collectifs de proches de disparus et de la grève des enseignants, les mots d’ordre convergent comme les cortèges ont prévu de le faire en direction du stade Azteca.
À Los Angeles, capitale états-unienne du “soccer”, les tarifs ont découragé jusqu’aux plus passionnés, tandis qu’une possible intervention de la police de l’immigration effraie les quartiers latinos.
Le peintre anglais était l’un des derniers survivants du pop art. Des toiles les plus intimes aux tableaux les plus militants, retour en images sur les chefs-d’œuvre d’un travailleur acharné.
Depuis que Peter Thiel, le fondateur de Palantir, a déménagé à Buenos Aires, le président paléolibertarien travaille à faire du pays la capitale mondiale du techno-libertarianisme.
The move comes after Anthropic’s receipt of a US Commerce Department directive Friday evening, subjecting the new models to export controls restricting their use anywhere outside the United States.
OpenAI is preparing the biggest overhaul of ChatGPT since its launch kicked off the AI boom, as the $850 billion group hunts for new engines of growth ahead of a planned listing this year.The company intends to transform the chatbot into a “superapp” that combines coding tools and AI agents, adding products that executives believe will generate more revenue.
“A facial recognition algorithm flagged Robert Dillon as the man who tried to lure or entice a child under twelve years old at a Jacksonville Beach McDonald’s. It was wrong. Mr. Dillon […] had never set foot in Jacksonville Beach. But rather than test the machine’s answer against the evidence that would have cleared him, the officers built a case to confirm it.”
An AI agent tried to join the DN42 hobbyist network to perform a network scan, and bankrupted its operator with a $6531.30 AWS bill, to the extent that they are begging for donations from the DN42 community.
Forecasts of run-of-the-mill weather conditions have a lot of practical value, but there is life-or-death value in an accurate forecast of extreme weather conditions. The more extreme, the more true that is. But just as a bird-identifying algorithm can’t identify a bird it wasn’t shown during training, AI-based weather models can fail at predicting extreme weather that wasn’t in their training dataset.
On the evening of June 7, multiple missiles were fired from various parts of Iran toward Israel. Following tensions that had emerged among Tehran, Washington, and Tel Aviv in the days following the April 8 ceasefire, Tehran finally struck parts of northern Israel, including Haifa, in response to the Israeli military’s actions in the Lebanese city of Beirut.
Pushing to seize 70 percent of Gaza’s territory, the Israeli army is opening fire at Palestinian civilians caught off guard by the ever-expanding ‘Yellow Line.’
Elle disposait pourtant de tous les documents requis : visa en règle, accréditation presse et contrat officiel avec RFI. Elle couvre le conflit israélo-palestinien depuis six ans, depuis Jérusalem et Ramallah.
Une approche qui pourrait expliquer les limites des traitements actuels et aider à améliorer la manière dont cette pathologie est diagnostiquée, prise en charge et perçue dans la société.
Le 5 juillet 2023, le conseil régional Île-de-France présidé par Valérie Pécresse avait rebaptisé le lycée de Saint-Denis du nom de Rosa-Parks, jugeant la figure de la militante américaine « trop conflictuelle ». Ce 9 juin, le tribunal administratif de Montreuil a annulé cette décision pour vice de procédure.
Après la revendication d’un cybercriminel sur le piratage de Tchap, la messagerie instantanée de l’Etat, la Dinum et l’Anssi confirment la compromission de l’outil via l’usurpation d’un compte. Une enquête est en cours pour connaître le périmètre de l’incident.
Pour la première fois, tous les élèves de première planchent sur les maths ce vendredi. Pour les syndicats, cette épreuve anticipée a été conçue avant tout pour Parcoursup.
Sur la presqu’île de Crozon, dans le Finistère, le collectif Skoazell vient en aide aux femmes victimes de violences sexuelles. L’initiative est née du courage d’habitantes qui ont osé parlé. Le réseau apporte une aide logistique et morale.
Pendant des années, le docteur nantais Traverson a abusé de son autorité de médecin. Poursuivi pour des palpations des seins non justifiées sur une soixantaine de victimes, dont des mineures, il a été reconnu coupable en décembre 2025. […] L’enquête judiciaire aurait pu commencer plus tôt. En 2021, une première plainte est déjà déposée, pour une jeune fille de 11 ans à l’époque. Dans le cadre d’une hospitalisation psychiatrique, elle révèle que le docteur Traverson lui a touché le pubis. La plainte est toutefois classée sans suite.
Après le meurtre, fin mai, d’une enfant de 11 ans dans le Gers, le casier vierge du principal suspect, malgré des plaintes pour violences sexuelles sur mineure depuis 2017, provoque un débat sur les causes des dysfonctionnements de la justice et de la police dans ce type d’affaires.
un organisme de référence dans la lutte contre la pédocriminalité internationale avait fait remonter en France plusieurs signalements sur Jérôme Barella.
L’affaire Lyhanna met en lumière les limites d’une conception viriliste du pouvoir incarnée par le ministre de la Justice. Quand les violences sexuelles s’imposent au débat public, la posture de l’« homme fort » apparaît moins comme une solution que comme une partie du problème.
Face à la tragédie, Gérald Darmanin et Emmanuel Macron se sont empressés d’accabler les magistrats pour mieux échapper à la remise en cause de leur politique.
Le procureur de la République a requis l’ouverture d’une information judiciaire à son encontre et sa mise en examen pour des faits de viols, de tentatives de viols, d’agressions sexuelles et de harcèlement sexuel concernant neuf victimes commis entre 2010 et 2019.
Ces accusations révélées par « Mediapart » s’ajoutent aux nombreuses autres qui visent le chanteur de 67 ans, déjà mis en examen dans quatre affaires de violences sexuelles.
Notre média et maison d’édition sont attaqués en justice par une multinationale via une procédure bâillon. Cette multinationale se nomme Pierre Fabre, l’entreprise derrière la polémique A69.
Il y a une constante dans la politique pénale française depuis le milieu des années 1990 : chaque décennie produit sa figure de l’ennemi absolu, et chaque loi d’exception laisse des dispositifs qui, une fois installés, ne disparaissent jamais. Prendre la protection des enfants au sérieux, c’est exiger que les budgets publics aillent vers ce qui crée une réduction effective des violences, pas vers ce qui rassure à court terme et laisse les structures intactes.
Après un rejet en commission des Lois à l’Assemblée, le ministre de la Justice a annoncé retirer de son texte le dispositif de « plaider-coupable » très décrié.
À un an de l’élection présidentielle, le rapport du Conseil d’orientation des retraites est plus scruté que jamais. Au risque de faire l’objet d’une récupération pour pousser à un nouveau décalage de l’âge de départ à la retraite à plus de 67 ans.
« Pensées émues pour tous les pédocriminels qui n’ont jamais passé une nuit en garde à vue », a ironisé Andréa Bescond sur Instagram [qui] avait appelé à se rassembler place Vendôme pour dénoncer les dysfonctionnements de la justice dans les affaires d’agressions sexuelles sur mineur·e après le meurtre de la petite Lyhanna
Le retentissement médiatique d’un crime, quand son auteur est perçu comme issu de l’immigration, suscite chez les Français d’origine étrangère un réflexe silencieux : la crainte que la faute d’un seul rejaillisse sur tous.
La Cour de cassation a reconnu l’intention d’homicide du policier qui a tué Nahel Merzouk. Le 27 juin 2023, le jeune de 17 ans, était tué d’une balle tirée à bout portant lors d’un contrôle de son véhicule à Nanterre.
Face aux restructurations permanentes liées à l’ouverture à la concurrence, et au mal-être au travail qui s’installe, avec treize suicides depuis le début de l’année, la grève à la SNCF du 10 juin a été très suivie.
Cette prise de parole est intervenue après l’interruption de la cérémonie par quelques étudiants portant des masques du patron de TotalEnergies, Patrick Pouyanné, et de celui de LVMH, Bernard Arnault, diplômés de l’X, pour dénoncer les partenariats avec les entreprises privées.
René Mayrhofer […] vient de démissionner de Google pour une raison qui vous concerne directement : l’entreprise a signé un accord autorisant le Pentagone à utiliser son IA pour des opérations classifiées, et l’homme qui sécurisait votre smartphone estime que ces outils seront “probablement utilisés contre” les citoyen·nes européen·nes.
Alors qu’Amazon a préféré quitter le Québec plutôt que de signer une convention collective, sur les sites français du géant du Web, les syndicalistes dénoncent des sanctions prises à leur encontre et une culture d’entreprise qui entrave leur activité.
One day after WIRED revealed that Meta had quietly embedded an unreleased face-recognition system into an app installed on more than 50 million phones, the company removed it
Après une attaque au couteau à Belfast, le propriétaire de X avait appelé ses abonnés à protester et reposté des messages de leaders d’extrême droite, amplifiant selon des chercheurs des récits anti-migrants auprès de millions d’utilisateurs.
Les véhicules d’aujourd’hui savent où nous habitons, combien nous pesons et ce que nous avons mangé au dîner. Voici ce qu’il advient de toutes ces informations, et comment vous pouvez réduire le flux de données.
De 1960 à 1966, avant et après l’indépendance de l’Algérie, l’État français a expérimenté au Sahara dit algérien dix-sept bombes atomiques et autres essais chimiques. Ce sujet a longtemps été tabou en France, dans la presse, dans les discours politiques aussi bien que dans le cadre académique où enquêtes, témoignages, littérature et recherches sur ce thème ont été invisibilisés.
En agitant le spectre de la faillite de la répartition, les cercles libéraux et le Rassemblement national préparent le terrain pour les fonds de pension privés, au détriment des salariés les plus modestes. Pourtant, des propositions alternatives et réellement sociales existent.
In a 1990 interview, Steve Jobs famously stated that personal computers were “a bicycle for the mind” […] I sit in front of a Mac all day and that’s not how it feels […] That’s not a bicycle. It’s an SUV for the mind.[…] just about any “obsolete” or “underpowered” laptop can be enough once freed from the burden of always-on connectivity. It’s cheap. It’s available. You probably already have one.
We tend to view ourselves and the complex cells that build us as a distinct branch of the tree of life from the compact, seemingly featureless cells of bacteria and archaea. But we’ve found that our genome is actually a hybrid, a mish-mash of genes from bacteria and archaea, along with some that have evolved in our own lineage.
Hidden underground around the world lie 110 quadrillion kilometers of arbuscular mycorrhizal fungal networks—webs of ultra-thin threads that, if connected in a single line, would stretch almost a billion times the distance between the Earth and the sun
Retrouvez les revues de web précédentes dans la catégorie Libre Veille du Framablog.
Les articles, commentaires et autres images qui composent ces « Khrys’presso » n’engagent que moi (Khrys).
Hi, just me heading off some bad advice I’m starting to see in developer venues.
Background
The proposed Document Outline Algorithm, where headings would automatically reset themselves to the appropriate level based on their position in the DOM structure, was never part of a final HTML specification. It was quickly proven to be unworkable; brief support in JAWS demonstrated that. You can read the tortured history (and a JAWS support demo) in my 2016 post There Is No Document Outline Algorithm.
In 2019 WHATWG worked to resurrect <hgroup>, partly in a novel effort to try to resurrect the Document Outline Algorithm. In the end, even that effort was futile. <hgroup> came back, but it came back as a grouping element only. The only impact it has on heading structures is that browser could, if they really wanted, ignore other headings in the same <hgroup>.
Authors very much want to make the browser decide heading levels for them. Authors also very much continue to write content and HTML structures that make that impossible.
So I wasn’t surprised when Firefox’s recent announcement of headingoffset support coming to Firefox behind a flag resulted in many cheering the “return” (irony quotes) of the Document Outline Algorithm.
But it isn’t.
headingoffset
The headingoffset attribute lets authors offset heading levels for descendants of a given node.
So if you have, say a dialog that starts at <h2>, you could add headingoffset="2" and then let it pull in (server-side or via your preferred user-slowing front-end tooling) another page that uses <h1> as its first heading, you can be comfortable knowing that <h1> will be treated as <h3> in the accessibility tree.
This can be handy for content re-use without authors needing to make every heading a variable or burning down the DOM each time to forcibly re-write them.
But it’s still the author’s job to make an intentional and good decision. The browser will know nothing more about your content or structure than it did before. And it certainly doesn’t reduce WCAG risk.
Other useful nuggets:
headingoffset values must be valid non-negative integers.
headingoffset values must be between 0 and 8.
headingoffset values greater than 8 are specified to max at level 9, but existing bugs may impact that.
Other invalid headingoffset values should fall back to level 2, but again, bugs and implementation decisions wil impact that.
headingreset is a boolean attribute that tells browsers to ignore headingoffset for that node and its descendants.
Do not use headingoffset until you can confirm support for the computed heading level in your target audience browser.
Recap
headingoffset is not the (nor any) Document Outline Algorithm, nor does it replicate it.
headingoffset requires the author to make decisions based on content.
Until JAWS and TalkBack fix existing bugs, probably don’t do / allow any heading levels higher than 6.
Don’t do / allow any heading levels higher than 9.
If you are hoping headingoffset will resolve your heading level problems in a hands-off way with imported or user-generated content, you may end up creating confusion and WCAG risk.
Do not try to use headingoffset to try to recreate the Document Outline Algorithm.
Related
Not a ton of detail in this post, but at 500 words if you want more then here are some resources beyond what I linked:
Just in time for Google I/O, the Chrome for Developers site announced Modern Web Guidance (MWG):
Modern Web Guidance is a set of evergreen and expert-vetted skills that guide your AI coding agents across many common use cases to build modern web experiences that are accessible, performant, and secure.
I appreciate this set of LLM skills lists accessibility first, something I feel strongly every MVP (or early preview as Google calls this) must:
Simply, if your MVP does not have accessibility factored in, it is not viable. If you claim accessibility is a core principle but your version 0 does not include it, then it is not a core principle.
Last year I made a straightforward and simple request to Google (that also respects the law in most jurisdictions where Google does business):
Please, if your team cannot explain how the thing satisfies all WCAG Success Criteria at Level AA, then don’t release the thing.
Unfortunately, MWG accessibility doesn’t satisfy. Partly because not every pattern has tailored guidance. For example, you may remember when Google ran at a toast pattern before abandoning it:
Again, the people designing the feature neither understood accessibility nor had consulted anyone who did while they designed it, instead relegating accessibility to the later stages of their design and assuming it could simply be remediated with a modest effort and without any serious redesign or rethink.
I hoped Google also remembered and applied that experience here, making a skill tailored to toasts to avoid another debacle. Nope.
Reopening because this guide needs accessibility guidance in some form as there’s no general toast guidance.
But this is an early preview of what developers can do with MWG. It’s not going to cover every pattern. That would be absurd. So let’s look to a pattern Google decided to showcase at launch via this first example prompt on the page:
Create an accordion-style stats component that smoothly animates on open and close.
I expected a pile of <details name> elements, maybe CSS block-size with a JavaScript fallback, probably a couple placeholder images for generic stats, possibly a well-formed table to accompany them, and of course all of it passing WCAG. This is what Antigravity produced with MWG:
Antigravity with MWG went well beyond the prompt, providing a theme switcher, configuration settings, and plenty of calls to Google fonts. But it failed to do what I asked. The animation doesn’t work in Firefox. This despite the promise of baseline / Baseline support and fallbacks:
Progressive Enhancement & Nuanced Fallbacks: We distinguish between purely additive enhancements (like speculative preloading) which are safe to let older browsers silently ignore, and critical behaviors (like dialog controls or network beacons) where we write highly considered, low-overhead fallbacks.
[…]
Baseline-Aware Integration: We leverage real-time compatibility data from the Baseline project so agents can dynamically adapt to current browser support and any browser support preferences.
This is already worrisome given we know that three years on, Baseline still doesn’t really address baseline support:
The relatively new Web Platform Baseline offering does not track browser support for accessibility features built into the web platform. If you need to understand whether browsers support accessibility features as your own base level set of requirements, for legal or other compliance reasons, then Web Platform Baseline does not represent a baseline.
Let’s ignore the non-DRY code, like duplicated HTML text in the script and stringing out the transition instead of using transition-property. Antigravity with MWG didn’t even create a WCAG-conformant example from its own prompt. I found errors within moments. MWG failed its core promises of creating accessible and performant code. Despite its own explicit guidance.
For the first two of these MWG already had guidance, and the a11y skill just wasn’t picked up. Overall activation aside, this highlights the importance of including contextual a11y information.
[…] [W]e should try to have one guide for each common interactive element summarizing and linking/embedding relevant bits of guidance (e.g. tabs, accordions, drawers, etc). The more scattered the use case guidance is, the less likely it is that agents will actually pick up all the pieces.
And there’s the rub. There’s no way to guarantee you’ll get what you ask for, that you won’t get something else, and that these guides — the entire promise of MWG — will be honored. MWG asks authors to trust MWG when using an LLM to code interfaces. But MWG knows its guidance may be ignored:
LLMs are non-deterministic. Even if we do everything right, there is no guarantee any guideline will be used for any given prompt. Even if the relevant guide is picked up, it may not be read fully. Case in point: As you say, MWG already had guidelines for many of these things!
The underlying code generation technology can’t be trusted to follow the rules and the rules aren’t robust enough to blunt that reality.
If your job requires you to burn tokens to satisfy some manager’s dashboard, then yes, grab the MWD skills files and integrate them into your LLM work. You’ll almost definitely get better output than if you do nothing at all. There are smart people working on this and many of the accessibility rules I saw were on-point.
But that output will be wrong in subtler and more nuanced ways across potentially fatter piles of code with more unrelated output and unwanted dependencies. It will require a more specialized set of skills to identify errors. And those errors will be different every time the code is generated.
So on the side, keep supporting any existing pattern library. If it’s built well, it’s copy-ready code that you can stuff into a project just as quickly as a chatbot could generate it. It’s deterministic, so you get the same code every time. Ideally it’s been vetted, so you don’t need to look for errors. It’s tailored to your context, meaning you don’t need to yank out random style switchers and typefaces (hoping you got all the dependencies).
If your job doesn’t require you to burn tokens, then probably ignore MWG and, by extensions, LLM for code. In case the environmental damage, intellectual property theft, wealth redistribution to the rich, encoded biases, and built-in support of fascism weren’t enough.
Update: 24 June 2026
The Silktide blog has this banger of a quote:
Across the board, [Google Antigravity using Modern Web Guidance] was a deprioritization of accessibility requirements in favor of visual presentation.
I don’t agree Antigravity nor MWG should use APG, which a regular visitor here may know, but the author is correct the APG disclosure pattern is mostly harmless.
But Silktide is right that the, once again, Google built the wrong thing for the wrong people and then proudly shoved it out into the world with no hint of self-awareness.
Google a mis en ligne un guide officiel, assez compact, que beaucoup attendaient pour expliquer comment "optimiser son site" pour ses fonctionnalités d'IA (obtention de résumés automatiques, mode "IA" dans les résultats, etc.).
Bonne nouvelle pour le web : il n'y a rien de révolutionnaire, et cela ne devrait - pour le moment - aboutir à aucune technique fourbe qui impacterait les humains ou l'accessibilité numérique.
Le message principal est que les bonnes pratiques classiques restent valables.
Le but de cette actualité n'est pas de faire la promotion de l'usage de IA par Google mais bien de souligner l'espérance d'une absence d'impact supplémentaire sur la qualité du web actuel.
Les réponses générées par l'IA de Google s'appuient sur le même index de recherche qu'avant : si vous n'êtes pas indexé, vous n'existez pas pour l'IA non plus.
On attend toujours un contenu de qualité, une structure technique propre, une bonne expérience utilisateur. À ce sujet Google a également confirmé il y a quelques jours qu'il pénaliserait les sites modifiant le comportement du bouton retour du navigateur, notamment pour "faire rester" les humains sur un site dans un piège infini grâce aux méthodes history.pushState et history.replaceState.
Ce qui est intéressant, c'est la section mythbusting où Google démonte quelques idées qui circulent en ce moment... Les rumeurs et fausses astuces circulent encore plus vite qu'avant.
Les fichiers llms.txt : inutiles pour Google. Le fichier n'a aucun effet particulier sur le traitement de votre site.
Découper le contenu en petits morceaux : pas nécessaire, les systèmes comprennent des pages avec plusieurs sujets.
Réécrire ses textes pour l'IA : inutile également. Les systèmes comprennent le sens général, pas besoin de cibler chaque variante de requête imaginable.
Les données structurées : toujours utiles pour les résultats enrichis classiques, mais pas requises pour apparaître dans les réponses IA.
La seule vraie nuance apportée concerne le contenu "non générique" : avoir un vrai point de vue, une expérience personnelle, une analyse qui va au-delà du consensus. Dans un monde où produire du contenu banal est à la portée de n'importe quel outil ou LLM quelconque, ce qui a de la valeur c'est ce que vous seul pouvez apporter.
Vous vous souvenez de mon article qui explique comment installer et configurer le navigateur Brave, ce navigateur moderne qui reverse une partie de ses revenus publicitaires aux créateurs de contenu sous forme de BAT (Basic Attention Token), une cryptomonnaie indexée sur l'audience des sites visités ? Eh bien Brave revient avec une nouveauté qui mérite qu'on s'y attarde : les noms de domaine en .brave, basés sur une blockchain.
Un nom de domaine .brave acheté une fois pour la vie ?
La grosse particularité de ces domaines .brave, c'est leur modèle économique : aucune redevance annuelle. Vous payez le domaine une seule fois à l'achat et il est à vous à vie. Plus besoin de penser au renouvellement chaque année, plus de mauvaise surprise quand vous oubliez de payer et que votre domaine tombe dans la nature pour être racheté par un squatteur.
Côté tarifs, cela démarre à environ 15 € pour un nom standard, et cela grimpe selon la rareté et la longueur du nom choisi.
Pour information, geeek.brave vient d'être acheté à vie pour la modique somme de 15 €.
Ces domaines reposent sur la solution Unstoppable Domains, une société fondée en 2018 par Matthew Gould et Bradley Kam. Le principe : au lieu d'être enregistré dans le système DNS classique géré par l'ICANN, votre domaine est monté comme un NFT sur la blockchain Polygon. Vous en êtes donc le seul et unique propriétaire, et personne ne peut vous le retirer.
Les domaines .brave sont compatibles avec plusieurs réseaux de crypto : Bitcoin, Ethereum, Solana, Base, Sonic, etc. Au total, plus de 310 cryptomonnaies peuvent être associées à un même domaine.
À quoi cela sert concrètement un domaine .brave ?
Un domaine .brave, ce n'est pas juste un gadget Web3, voici ce qu'on peut en faire :
Recevoir des paiements crypto facilement : au lieu de partager une adresse de wallet à rallonge du genre 0x742d35Cc6634C0532925a3b844Bc9e7595f0bEb7, vous donnez juste votre-nom.brave. Beaucoup plus simple, beaucoup moins risqué (pas d'erreur de copier-coller).
Héberger un site web décentralisé sur IPFS, sans frais d'hébergement, accessible directement depuis Brave Browser. Si vous souhaitez juste réaliser une redirection vers un site classique, vous pouvez publier un simple fichier index.html avec un redirect dans l'entête. Cela renverra vos visiteurs sur votre site habituel.
Construire une identité numérique vérifiable via UD.me, avec vos profils sociaux, NFT, certifications, etc.
Se connecter à des applis Web3 sans mot de passe grâce à « Login with Unstoppable ».
Une vraie résolution dans Brave et bientôt partout ?
Depuis la version 1.81 du navigateur Brave (sortie en août 2025), les domaines .brave sont directement résolus nativement dans le navigateur et le Brave Wallet. Pas besoin d'extension, pas besoin de bidouille DNS : vous tapez monsite.brave dans la barre d'adresse, et la résolution fonctionne.
Le problème actuel : ces domaines ne sont résolvables que dans Brave (et quelques autres navigateurs compatibles Web3). Mais Brave et Unstoppable Domains travaillent sur une demande d'accréditation officielle auprès de l'ICANN en 2026 pour faire de .brave un vrai gTLD (domaine de premier niveau classique).
Si cette demande aboutit, vos domaines .brave deviendront accessibles depuis n'importe quel navigateur, comme un .com ou un .fr traditionnel. Et vous, vous l'aurez déjà acheté pour 15 € à vie.
En synthèse
Mon avis dans tout cela ? Pour 15 €, c'est un pari peu risqué. Soit le projet réussit son passage ICANN et vous avez un domaine grand public à vie pour le prix d'un repas. Soit il reste dans l'écosystème Web3, et vous avez quand même un identifiant blockchain utile pour les paiements crypto et un petit site IPFS.
Si vous êtes créateur, blogueur, ou simplement intéressé par le Web3, je vous recommande de réserver votre nom dès aujourd'hui, avant que les meilleurs noms partent. Pour ma part, c'est fait : https://geeek.brave est dans la poche.

 Connexion

 Les recherches lancées depuis l'appareil photo d'un smartphone ou une capture d'écran ne se confondent plus avec les requêtes textuelles dans la Search Console.
 Plus de quinze ans après la fermeture de Lycos Europe, l'éditeur ADN Contents mise sur le souvenir laissé par le portail chez les internautes des années 1990. Mais pas que.