❌

Vue lecture

Referrer Policy

Des mécanismes parfois vieux comme le Web sont présents sur nos sites sans que nous en ayons tous les tenants et les aboutissants. Celui présenté aujourd'hui fait partie de cette catégorie. C'est également l'occasion de voir que son importance peut être capitale dans certains cas de figure.
Son nom est Referrer Policy.

Introduction

Le mécanisme dit de Referrer (qu'on peut traduire par « référent » en français) est selon Wikipedia :

Un référent, plus connu sous l'anglicisme Referer ou Referrer [1], est, dans le domaine des réseaux informatiques, une information transmise à un serveur HTTP lorsqu'un visiteur suit un lien pour accéder à l'une de ses ressources, lui indiquant l'URL de la page où se situe ce lien qu'il a suivi.

En pratique, quand un utilisateur navigue vers un autre site via un lien (ou si un site charge une ressource externe), le serveur informe le site de destination de l'origine de la requête en utilisant l'en-tête HTTP Referrer.

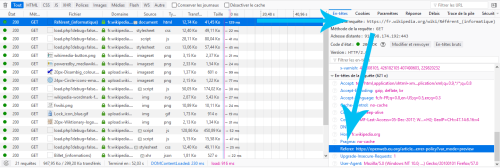
Si nous prenons l'exemple du logo d'Openweb, voici l'information de referrer envoyée :

Affichage du referrer pour le logo sous les outils développeurs de Firefox

Si nous ouvrons le lien précédent sur Wikipedia, voici l'information de referrer que l'on peut voir :

Affichage du referrer du lien sous les outils développeurs de Firefox

Cela peut être utile dans de nombreux cas (certains outils de statistiques se basent là-dessus, etc.), toutefois, cela peut aussi poser des problèmes de confidentialité et de sécurité. Ajoutons à cela que de nombreuses — et parfois insoupçonnées — APIs peuvent utiliser cette information... et parfois au désavantage des propriétaires de sites et/ou de leurs visiteurs.

Si ce mécanisme pouvait auparavant sembler être peu clair et peu paramétrable, une spécification relativement récente permet enfin d'en maitriser les comportements.

Referrer Policy

Son nom s'appelle très logiquement Referrer Policy, qu'on peut traduire par « Politique de referrers », ou « Politique de référents ».

Cette spécification est à l'instant de l'écriture de cet article une Candidate recommendation, c'est donc raisonnablement stabilisé et tout à fait utilisable en production.

À l'instar de Content Security Policy, vous pouvez donc avec Referrer Policy définir clairement votre politique en matière de referrers pour votre site… et la question est loin d'être aussi anodine qu'elle peut sembler l'être.

Principe et fonctionnement

Un en-tête HTTP est envoyé au navigateur contenant cette politique. En voici un exemple via PHP :


header("Referrer-Policy: ");

Voici les valeurs possibles :

Referrer-Policy: no-referrer : aucun en-tête referrer n'est envoyé.

Referrer-Policy: no-referrer-when-downgrade (valeur par défaut) : le referrer est envoyé si la sécurité de la destination est à priori égale (HTTPS→HTTPS), mais n'est pas envoyé pour une destination moins sécurisée (HTTPS→HTTP).

Referrer-Policy: origin : seule l'origine du document sera envoyée dans tous les cas. L'adresse https://openweb.eu.org/articles/ enverra le referrer https://openweb.eu.org/.

Referrer-Policy: origin-when-cross-origin : envoie l'URL complète si la destination a la même origine, et seulement l'origine pour les autres cas.

Referrer-Policy: same-origin : le referrer sera envoyé pour les URLs avec la même origine, et aucun referrer ne sera envoyé dans les autres cas.

Referrer-Policy: strict-origin : le referrer ne contiendra que l'origine du document si la sécurité de la destination est à priori égale (HTTPS->HTTPS), rien ne sera envoyé pour une destination moins sécurisée (HTTPS→HTTP).

Referrer-Policy: strict-origin-when-cross-origin : quand la requête a la même origine, l'URL complète est envoyée en referrer. Dans le cas contraire : le referrer ne contiendra que l'origine du document si la sécurité de la destination est à priori égale (HTTPS→HTTPS), rien ne sera envoyé pour une destination moins sécurisée (HTTPS→HTTP).

Referrer-Policy: unsafe-url : l'URL complète est passée en referrer, quel que soit le cas.

Le réglage par défaut a longtemps été à l'origine d'un mythe : que le passage à HTTPS tuait en lui-même le mécanisme des referrers. Quand le HTTPS était beaucoup moins répandu qu'actuellement, avoir un site en HTTPS impliquait d'avoir majoritairement des liens vers des sites ne l'ayant pas (et donc aucun referrer envoyé vers une destination moins sécurisée). Le passage de Google à HTTPS il y a quelques années a fortement contribué à propager ce mythe. Néanmoins, HTTPS et referrers sont deux choses séparées, désolé de tuer cette légende urbaine ! :)

Implications et données sensibles

De prime abord, vous vous dites peut-être que votre site n'a rien à cacher :

  • vous n'avez aucun problème à ce que les sites vers lesquels pointent vos liens soient au courant desdits liens ;
  • ou les ressources que vous utilisez sur d'autres sites ne sont pas un secret d'état non plus…

Posons clairement la question : en êtes-vous bien sûr ?

Si certes, des liens publics ne sont pas des secrets d'état… peut-être votre site a une interface d'administration, et vous n'avez sûrement pas envie que l'adresse de cette dernière soit transmise en referrer.

Autre cas de figure : imaginons un intranet sur lequel vous pouvez partager des liens. Souhaitez-vous que l'adresse de ce dernier soit transmise vers l'extérieur ? Avec tout ce que cela peut révéler comme détails sur le fonctionnement de ce dernier ? Bien sûr que non !

D'autres APIs comme CSP peuvent également transmettre cette information. Voici un exemple d'informations qui peuvent arriver sur un report-uri :

{ "csp-report": { "document-uri": "https://van11y.net/accessible-tab-panel/", "referrer": "https://plainjs.com/javascript/plugins/accessible-tabs-panel-system-163/", … }
}

Note : CSP étant assez verbeux de ce point de vue, ce genre d'information est fréquent.

Responsabilité en tant que concepteurs/possesseurs de sites

Vous avez plusieurs questions à vous poser en tant que concepteurs/responsables de sites à propos de votre politique de referrers.

Est-ce que l'adresse peut contenir des informations sensibles pour l'extérieur ?

S'il n'est pas souhaitable de communiquer certaines adresses vers l'extérieur, votre politique en matière de referrers doit le refléter. Et bien entendu, vous ne transmettez aucune information sensible en clair dans l'URL ?

Est-ce que l'adresse en elle-même est une information sensible ?

Si vous êtes sur un intranet ou une partie totalement privée de votre entreprise, c'est une information sensible que vous ne devez pas communiquer, a fortiori via referrer.

À titre d'exemple, si vous saviez le nombre surprenant d'intranets ou d'espaces privés qui partagent une page humoristique que j'ai créée il y a quelques années qui s'appelle « Est-ce qu'on met en production aujourd'hui ? »... je pense que les responsables sécurité de ces sites trouveraient moins drôle de savoir que cette information fuite, notamment en referrer dans des rapports générés par CSP que je reçois.

Beaucoup moins drôle comme exemple, imaginons un site d'entraide pour des femmes victimes de violences [2]. Imaginons donc une femme ainsi que l'état de choc dans laquelle elle peut se trouver après avoir été battue. Elle va donc laisser un message sur ce site, et peut-être parler du site personnel de son mari, pour dire que « c'était la première fois qu'il faisait ça », et « qu'il est gentil avec ses autres occupations ». Imaginons que ce dernier apprenne dans son outil de visites qu'un site de ce genre lui a envoyé des visites... que va-t-il penser suite à ce qu'il a fait à sa compagne ? Et que va-t-il faire ensuite ?

Autant le dire clairement : il est de la responsabilité du site de gérer et d'anticiper ce genre de risques. Certains sujets ne souffrent pas de traiter ces risques avec légèreté, et encore moins en tant que professionnels du métier.

Notes : des outils comme Mozilla Observatory suggèrent d'utiliser comme valeurs :

  • no-referrer
  • same-origin
  • strict-origin
  • strict-origin-when-cross-origin

Et ce, afin de ne pas divulguer d'informations sensibles.

Le W3c vous recommande de définir une politique de referrer.

Conclusion

Cette question des referrers dépasse de loin le simple cadre des statistiques des sites, et peut devenir un enjeu de sécurité ou de vie privée selon l'activité des sites.

Ce n'est bien évidemment pas un hasard si des outils comme Mozilla Observatory ou Security Headers invitent et recommandent d'utiliser cet en-tête de sécurité.

Maintenant que vous en connaissez les enjeux et le contexte, vous n'avez plus d'excuse pour ne pas le déployer en toute connaissance de cause à votre tour.

Références, compléments


[1] La graphie exacte de ce mot est en réalité Referrer, avec deux « r ». Mais l'erreur est si courante dans la langue anglaise, qu'elle a été commise au sein même des spécifications officielles du protocole HTTP (!). La forme erronée est par conséquent devenue standard dans l'industrie de l'informatique, lorsqu'il est question des référents.

[2] J'ai travaillé sur un site de ce genre : Violence que faire, et je peux vous assurer que le scénario évoqué est tout à fait plausible.

  •  

HTTPS : de SSL à TLS 1.3

Un changement de numéro de version, même mineur, est rarement anodin lorsqu'il s'agit d'un protocole de sécurité. Alors qu'une importante partie de l'écosystème qui gravite autour de SSL/TLS persiste à l'appeler SSL, aujourd'hui, c'est bel et bien uniquement TLS qu'il faut utiliser et avec une large préférence pour TLS 1.2 et TLS 1.3.

HTTPS est apparu dans Netscape Navigator en 1995 pour accompagner l'essor du commerce en ligne alors naissant. Initialement c'est le protocole SSL —Secure Sockets Layer— qui était intercalé entre TCP et HTTP. Depuis lors, SSL a bien évolué et a même changé de nom pour devenir TLS —Transport Layer Security—, on dénombre désormais six versions : SSLv2, SSLv3, TLS 1.0, TLS 1.1, TLS 1.2 et TLS 1.3. Elles apportent chacune des améliorations parfois subtiles mais qui peuvent se révéler cruciales. 2018 a été marquée par l'avènement de TLS 1.3. Dix ans après TLS 1.2, cinq ans après les révélations d'Edward Snowden, cette nouvelle version apporte plus de simplicité, de vitesse et de sécurité.

Cet article est relativement long car il aborde des aspects historiques en plus de la technique, mais d'un point de vue purement pratique il peut se résumer en quelques points :

  • TLS 1.2 est une nécessité, à activer si ce n'est déjà fait ;
  • SSLv2 et SSLv3 sont des calamités, à désactiver ;
  • TLS 1.0 est en sursis, planifier sa désactivation ;
  • TLS 1.1 ne sert pratiquement à rien ;
  • TLS 1.3 est l'avenir, considérer son adoption dès que possible.

Ces recommandations sont en phase avec celles de l'ANSSI —Agence Nationale de la Sécurité des Systèmes d'Information— : Recommandations de sécurité relatives à TLS (si ce n'est que l'agence française n'aborde pas encore TLS 1.3) ou le wiki de Mozilla concernant la configuration TLS : Security/Server Side TLS (destiné à la base au seul usage interne au sein de Mozilla, mais le guide Sécuriser votre site à l'aide du protocole HTTPS de Google et le National Cyber Security Centre britannique le recommandent).

Il arrive qu'on ne dispose que d'un contrôle partiel sur le paramétrage de TLS qui est souvent lié à un composant proche du système d'exploitation comme OpenSSL ou Secure Channel [1], il faut donc éventuellement s'adresser à son administrateur système ou son hébergeur pour parvenir à mettre en place certaines évolutions.

Il est en revanche assez facile de s'équiper d'outils pour analyser la configuration SSL/TLS d'un serveur ou d'un client web. SSL Labs (en ligne) et son quasi équivalent pour shell bash testssl.sh génèrent un rapport relativement complet sur la configuration d'un serveur web sécurisé quelconque et indiquent donc quelles versions de SSL/TLS sont actives, on trouve par exemple pour un domaine de la DGFiP.
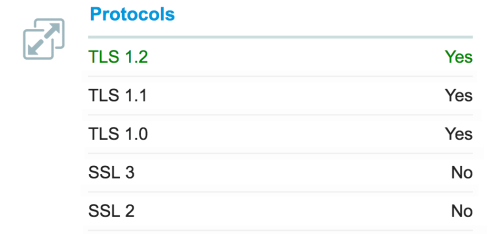
Versions de SSL/TLS actives

Avoir TLS 1.0, 1.1 et 1.2 comme seules versions actives est une situation encore courante actuellement. En effet, tous les navigateurs sont dotés de TLS 1.2 depuis plusieurs années (voir Can I use : TLS 1.2), mais le parc mondial n'est malheureusement pas constitué uniquement de navigateurs récents, c'est pourquoi TLS 1.0 et 1.1 restent encore souvent activés aux côtés de TLS 1.2 sur de nombreux serveurs. Quant à TLS 1.3 la diffusion de bibliothèques adaptées n'est effective que depuis peu.

On trouve sur SSL Pulse un ensemble de statistiques relatives aux éléments clés de la configuration SSL/TLS côté serveur, celles-ci proviennent de l'analyse mensuelle d'un large panel de sites web. Ce qui permet de prendre régulièrement le pouls de l'état de la crypto sur le web et d'éventuellement se situer par rapport aux autres sites.
Le graphique ci-dessous représente l'évolution des versions de SSL/TLS acceptées par les serveurs scrutés par SSL Pulse sur une période de quatre ans (les colonnes représentent les mesures d'octobre 2015, 2016, 2017, 2018 et 2019).
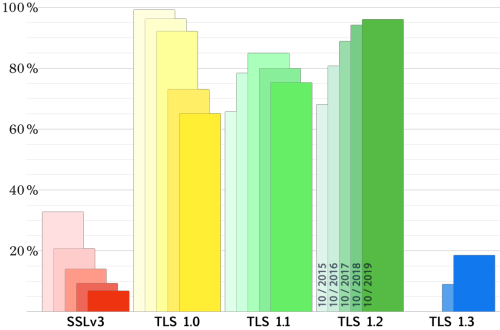
évolution des versions de SSL/TLS acceptées par les serveurs scrutés par SSL Pulse

On observe la disparition (toute relative) de SSLv3, le déclin de TLS 1.0, le retournement de tendance de TLS 1.1 qui suit désormais TLS 1.0 vers la sortie alors que TLS 1.2 est proche des sommets et TLS 1.3 bénéficie d'un départ canon. En se basant sur les tendances on peut déduire que les sites en pointe acceptent TLS 1.2 voire 1.3 mais refusent d'ores et déjà TLS 1.0 et 1.1, que le gros des troupes accepte indifféremment TLS 1.2, 1.1 et 1.0 et que les sites à la traîne ne peuvent traiter que TLS 1.0 parfois encore secondé par SSLv3. Ce découpage en trois populations correspond grosso modo à ce que propose Mozilla sur Security/Server Side TLS avec ses trois configurations : moderne, intermédiaire et vieillot ou la classification R3, R3− et R3−− de l'ANSSI.

Il faut en effet faire preuve de pragmatisme, la même configuration SSL/TLS ne peut pas convenir à tout le monde. De façon un peu caricaturale, un site orienté B2B sera certainement bien plus confronté à de vieux Internet Explorer pour qui TLS 1.0 reste nécessaire, alors qu'un site dont la confidentialité est une priorité ou doté d'un design qui repose sur des fonctionnalités CSS ou Flexbox récentes pourrait, au contraire, se passer de TLS 1.0 et des vieux clients web qui en dépendent. Une refonte peut être une occasion intéressante de réviser une configuration TLS, à condition de bien en mesurer les conséquences —ce qui implique que le front-end discute avec le back-end et le système. Si un site est prévu pour au minimum IE 11 et que son niveau de dégradation avec IE 9 ou plus ancien est tel qu'il vaudrait mieux ne pas l'afficher… la configuration TLS offre une solution radicale.

Le client web propose, le serveur web dispose

Le client et le serveur web négocient certains éléments lors de l'établissement de la liaison sécurisée. Il faut en effet qu'ils s'assurent de disposer d'algorithmes en commun pour signer, échanger des clés et chiffrer, mais la version du protocole SSL/TLS à utiliser est le tout premier point sur lequel ils doivent nécessairement s'entendre, car le reste de l'établissement de la liaison sécurisée (le handshake) varie légèrement d'une version à l'autre, ce sont surtout des initialisations, transmissions d'aléas et calculs de sommes de contrôle qui changent.
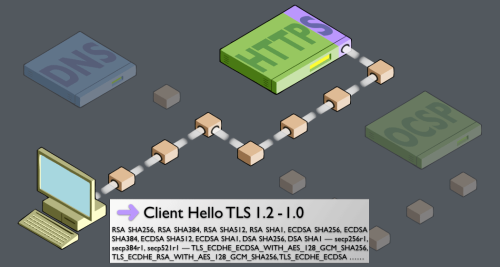
Proposition des capacités par le client

La règle de base est que le client propose, il va donc faire étalage de toutes ses capacités, parfois dans un ordre préférentiel. Puis c'est le serveur qui dispose vu que c'est lui qui va retenir quels algorithmes seront utilisés en fonction de ses propres capacités.
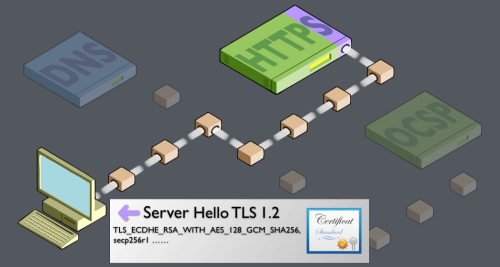
Réponse du serveur selon ses capacités

Il va sans dire qu'il se produit quelques problèmes intergénérationnels lorsque de vieux clients essayent de communiquer avec des serveurs qui cherchent à renforcer la sécurité des données en transit, car ceci s'oppose à une rétrocompatibilité très poussée, ou inversement lorsque des clients récents croisent un serveur resté figé à une autre époque.
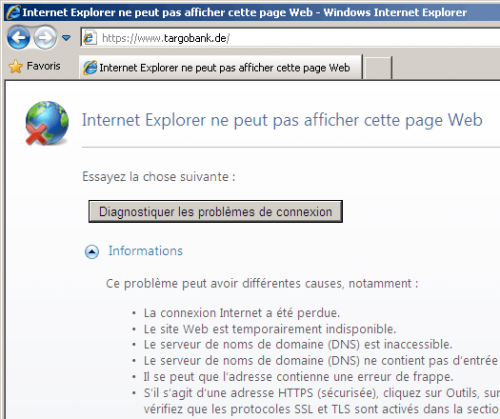
Echec de négociation TLS avec IE8

IE 8 sur Windows XP n'arrive pas à négocier l'ouverture de la connexion sécurisée avec un site qui nécessite au minimum TLS 1.1.
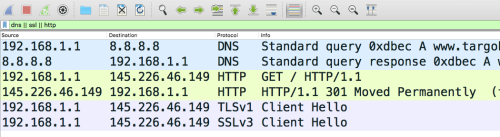
Détail réseau de la discussion entre le navigateur et le serveur

Les traces réseau révèlent que le navigateur a fait deux tentatives, une fois en TLS 1.0 et une fois en SSLv3, le serveur n'a pas même daigné lui répondre, le navigateur se retrouve alors déboussolé et ne peut afficher qu'un message d'erreur assez générique. Ce point est à prendre en compte lorsque l'on planifie de désactiver TLS 1.0 sur un site existant, il faut en effet prévenir les derniers utilisateurs qui se présentent encore avec de vieux clients web du changement à venir bien avant la désactivation effective.

Le client web propose, le serveur web… explose

Dans le « Client Hello », qui correspond au premier message adressé par le client au serveur, figurent la version la plus élevée et la plus basse du protocole que le client propose d'utiliser, de nos jours on y trouve très souvent TLS 1.2 et TLS 1.0, mais ceci n'est qu'une convention qui laisse d'ailleurs planer un doute quant au fait que TLS 1.1 puisse être utilisé ou non.
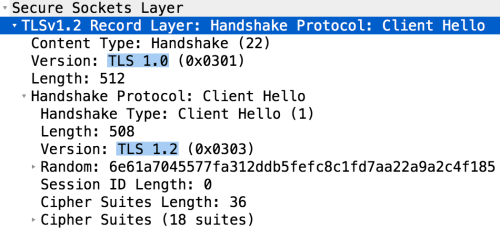
Détail d'un Client Hello

Pour des raisons historiques et de nombreuses mises en œuvres bancales, cet aspect est un brin moins trivial qu'il ne devrait l'être. En effet lorsque les premiers clients aptes à utiliser TLS 1.0 ont entamé le dialogue avec des serveurs qui ne connaissaient que SSLv3, les négociations ne se sont pas déroulées exactement comme prévues… En théorie les serveurs en question auraient dû décliner la proposition d'utiliser TLS 1.0 et se rabattre sur SSLv3 à la place, en pratique certains serveurs se sont figés d'effroi et dans le mutisme le plus total.

Ce phénomène porte le nom d'intolérance de version et a forcé les clients web à émettre une première tentative de négociation pour TLS 1.0 puis, en cas d'échec ou en l'absence de réponse, une seconde tentative pour SSLv3, exactement comme on le voit sur les traces réseau d'IE 8 ci-dessus.

Sans grande surprise le même phénomène, un peu atténué, s'est produit lorsque les premiers clients TLS 1.1/1.2 se sont adressés à des serveurs qui ne connaissaient que TLS 1.0 et SSLv3. Certains sites ont alors conseillé à leurs utilisateurs de désactiver TLS 1.2 et TLS 1.1 dans les « Options Internet » de Windows, les privant donc de ces versions sur tous les autres sites !
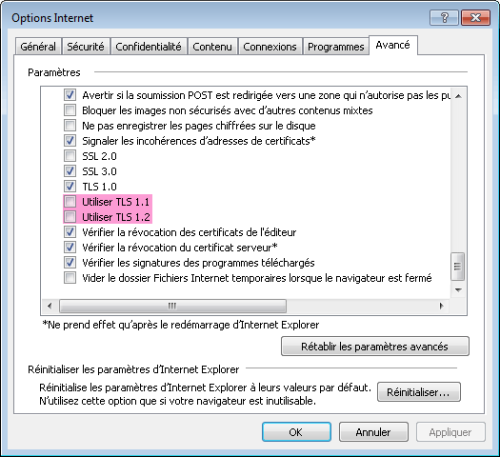
TLS 1.2 et 1.1 désactivés sous IE

Si les deux cases « Utiliser TLS 1.2 » et « Utiliser TLS 1.1 » sont décochées Internet Explorer devient incapable de négocier les versions de TLS les plus récentes. Du coup il n'est pas tout à fait possible de faire le lien entre un User Agent et le support de TLS 1.2 vu que celui-ci peut être désactivé par ailleurs, ce qui implique de se pencher directement sur les logs de négociations TLS pour, par exemple, déterminer la part exacte des clients qui nécessitent TLS 1.0 sur un site donné.

La bonne nouvelle est que ce problème d'intolérance ne se produira pas avec TLS 1.3. En effet, lors de la conception de ce dernier, il a été évalué qu'environ 2% des serveurs web sécurisés seraient intolérants aux clients qui chercheraient à négocier TLS 1.3 d'entrée de jeu. De ce fait, les clients TLS 1.3 se présentent en définitive comme de simples clients TLS 1.2 mais arborent en plus une nouvelle extension qui permet une énumération claire des versions du protocole que le client souhaite utiliser. Les extensions inconnues étant proprement ignorées par les serveurs web, il ne devrait plus y avoir de problème d'intolérance.
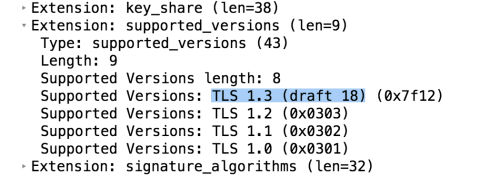
Versions de TLS supportées

Firefox 51.0.1 indique clairement qu'il souhaite utiliser TLS 1.3 (sur la base du draft 18).

Des temps anciens à l'ère post NIST

Ces dernières années la majorité des failles de sécurité ou faiblesses rendues publiques comme BEAST, POODLE, DROWN, SWEET32… concernent les versions les plus anciennes du protocole SSL/TLS. En compilant sur plus de 20 ans les différentes évolutions de ce protocole, on comprend mieux pourquoi TLS 1.3 devenait nécessaire et représente une étape significative vers un Internet plus sûr.

Un des objectifs de cette partie est de montrer que ce qui définit SSL/TLS n'est pas une spécification monolithique unique mais plutôt un patchwork de RFC apparues progressivement et dans lesquelles les différentes mises en œuvres logicielles vont piocher plus ou moins d'éléments ; les explications détaillées concernant certains concepts (auxquels sont souvent associé des acronymes : CBC, GCM, ECDHE…) ne seront fournies que dans les articles relatifs aux certificats et aux suites cryptographiques.

SSLv2 (1995)

SSL version 2 constitue la version initiale proposée par Netscape, la version 1 n'ayant jamais servi. SSLv2 présente des lacunes importantes et ne devrait plus être utilisé depuis très longtemps, très très longtemps même, l'IETF s'est clairement prononcé sur ce sujet en 2011 dans la RFC 6176. Toutefois, au début 2016, l'attaque DROWN a mis en lumière sa présence sur de nombreux serveurs HTTPS et SMTP alors que les clients web pouvant se connecter de la sorte ont disparu depuis belle lurette, et plus aucune autorité de certification ne peut émettre de « certificat SSL » avec des caractéristiques adaptées aux clients web qui ne connaîtraient que SSLv2. Ceci est malheureusement symptomatique de négligences de sécurité élémentaires : défaut de mise à jour et reconduction de paramètres par méconnaissance.

SSLv3 (1996, RFC 6101)

Conscient des faiblesses de SSLv2, Netscape propose SSLv3 dès l'année suivante. Cette version est restée active et très largement utilisée pendant près de 18 ans (le long règne d'IE 6 et la prédominance de Windows XP y sont pour quelque chose). En septembre 2014, l'attaque POODLE scelle le sort de SSLv3 car la seule contre-mesure possible est sa désactivation au profit de TLS. Mais cette version était déjà décriée depuis des années comme en témoigne les tutoriels de désactivation de SSLv3, la RFC 7568 de 2015 en interdit l'usage et préconise TLS 1.2 à la place. Il est à noter qu'en raison de POODLE, la majorité des navigateurs ont définitivement désactivé SSLv3 vers la fin 2014.

À moins de vouloir à tout prix être compatible avec Internet Explorer sur Windows XP Service Pack 2 (le SP3 apporte TLS 1.0 qu'il faut toutefois activer manuellement dans « Options Internet ») il n'y a strictement aucune raison d'activer SSLv3 côté serveur.

TLS 1.0 (1999, RFC 2246)

Pour concilier les divergences entre Microsoft et Netscape concernant l'évolution de SSL, le protocole est confié à l'IETF —Internet Engineering Task Force— et renommé TLS —Transport Layer Security— au passage. À cette époque, TLS 1.0 ne constituait qu'une évolution assez légère de SSLv3 (en interne l'identification de version est d'ailleurs 3.1). TLS révise cependant une partie de l'établissement de la liaison (le handshake) et apporte de la flexibilité avec l'introduction d'extensions optionnelles qui permettent de faire évoluer le protocole sans revoir ses bases et constamment réviser son numéro de version.
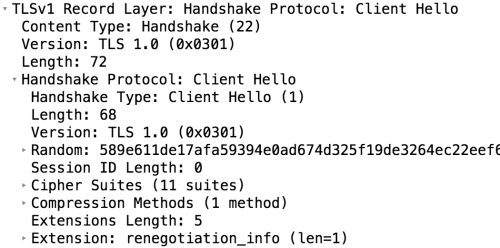
Exemple de Client Hello avec des extensions

Les premières années l'utilisation des extensions est restée très limitée, le Client Hello produit par IE sur Windows XP ne dépassera jamais cette forme rudimentaire.

AES —Advanced Encryption Standard— (2002, RFC 3268)

Le chiffrement symétrique AES a été intégré dans TLS quelques années après la parution de TLS 1.0, il est aujourd'hui très largement répandu et restera vraisemblablement indispensable encore de nombreuses années.

Parmi les améliorations apportées à Secure Channel dans Windows Vista par rapport à Windows XP figurent la mise en œuvre de suites cryptographiques qui proposent le chiffrement AES et dans un autre domaine le SNI…

SNI —Server Name Indication— (2003, RFC 3546)

SNI est une extension TLS qui revêt désormais une importance toute particulière ! En effet, précédemment SSL partait du principe qu'un seul domaine était hébergé par adresse IP et à aucun moment le protocole ne faisait mention du domaine visé… Un peu à l'image de HTTP/1.1 qui a permis l'hébergement virtuel avec l'en-tête « host », TLS donne la possibilité d'indiquer le nom du serveur via l'extension SNI, ce qui permet donc d'héberger plusieurs sites sécurisés sur une même adresse IP sans avoir à mutualiser le certificat et la clé privée.
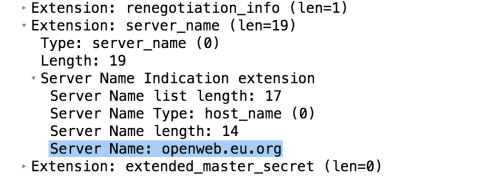
Extensions SNI (exemple sur Openweb)

Les clients web incapables de gérer SNI sont en voie de disparition (voir Can I use : SNI) et les hébergeurs ont donc désormais massivement recours à SNI pour offrir HTTPS à tout le monde.

Aujourd'hui TLS 1.0 montre de sérieux signes de fatigue, car les suites cryptographiques qui y sont communément associées reposent sur des méthodes de chiffrement dont la cryptanalyse révèle désormais les faiblesses, on notera :

  • l'interdiction du chiffrement RC4 dans la RFC 7465 voir également RC4 NOMORE ;
  • un problème de chaînage et d'initialisation des blocs CBC BEAST Attack ;
  • ou encore les blocs de 64 bits qui fragilisent le Triple DES SWEET32.

De ce fait, configurer TLS 1.0 correctement est un exercice de plus en plus périlleux, le PCI SSC —Payment Card Industry Security Standards Council— (Visa, Mastercard et les autres réseaux de cartes) a banni cette version des paiements CB en ligne et par là même des sites d'e-commerce dans PCI DSS 3.2 depuis la mi-2018. Le 15 octobre 2018, Apple, Google, Microsoft et Mozilla ont annoncé conjointement la fin de la prise en charge des versions 1.0 et 1.1 de TLS dans leurs navigateurs à compter de mars 2020 (la pandémie de Covid-19 a toutefois introduit un sursis de quelques mois). Pour satisfaire aux exigences de PCI DSS, certains hébergeurs proposent en option des configurations uniquement basées sur TLS 1.2.

Désactiver TLS 1.0 revient à tourner le dos à environ 3 % des navigateurs utilisés et plus particulièrement IE 8 et antérieurs sur Windows XP et IE 9 et antérieurs sur Windows Vista, les versions de Safari antérieures à la 7 sur OS X ainsi que le navigateur intégré (pas Chrome) des appareils Android antérieurs à 5.0.

Avec l'arrêt de la branche ESR 52.9.0 de Firefox, Windows XP et Vista se retrouvent sans navigateur maintenu, Chrome ayant déjà jeté l'éponge (notification de Chrome 49), il devient donc de plus en plus dangereux d'utiliser ces systèmes.

TLS 1.1 (2006, RFC 4346)

TLS 1.1 est une version de transition qui consolide certaines RFC intermédiaires et inclut une modification de l'initialisation des blocs CBC (suite à un signalement fait en 2001) qui prévient l'attaque BEAST qui n'apparaitra toutefois qu'en 2011. Cette attaque a révélé à quel point la cryptographie sur le web était en retard, en effet en 2011 aucun navigateur ne peut traiter TLS 1.1 ou 1.2 et il en va pratiquement de même pour les serveurs (OpenSSL évolue alors malheureusement très lentement).

Le rattrapage brutal effectué depuis lors explique pourquoi TLS 1.1 est une version que l'on peut pratiquement oublier, en effet la gestion de TLS 1.1 est très souvent apparue simultanément avec celle de TLS 1.2. La question qui se pose au niveau de la configuration d'un serveur est donc de savoir jusqu'à quand il doit encore accepter TLS 1.0 avant de passer exclusivement à TLS 1.2 et plus récent.
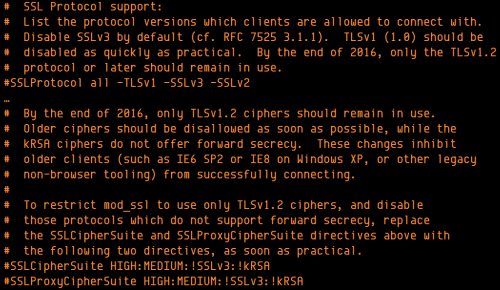
Commentaires du fichier de configuration Apache 2.4.x à propos de TLS

Les commentaires du fichier de configuration httpd-tls.conf d'Apache 2.4.x suggèrent de désactiver TLS 1.0 dès que possible et de ne conserver que TLS 1.2 d'actif à compter de la fin 2016.

ECC —Elliptic Curve Cryptography— (2006, RFC 4492)

La cryptographie à base de courbes elliptiques est une rupture technologique (enfin mathématique) par rapport aux algorithmes précédents qui reposent souvent sur de grands nombres entiers et la difficulté de les factoriser (type RSA). Utiliser les équivalents ECxxx présente quelques avantages :

  • la description d'un point sur une courbe est un objet bien plus petit ;
  • les calculs sont globalement plus rapides ;
  • les plus petites clés EC offrent déjà un niveau de sécurité un cran au-dessus de ce qui se fait communément (équivalent à 3072 bits en asymétrique).

Utiliser en priorité l'algorithme d'échange de clé ECDHE est désormais unanimement conseillé.

En revanche, l'utilisation de clés et de signatures ECDSA est encore rare dans les certificats par rapport à l'omniprésent RSA mais celle-ci devrait connaitre un regain d'intérêt dans les prochaines années avec la disparition des clients web incompatibles (principalement IE et Chrome sur Windows XP).
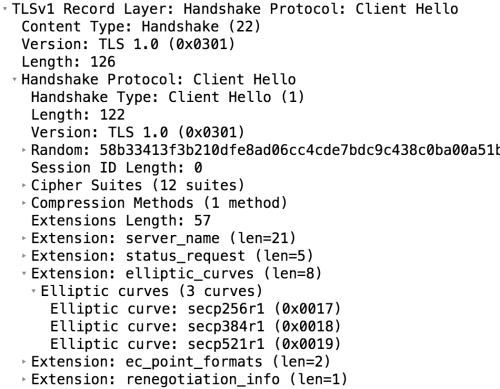
Extensions à base de courbes elliptiques dans un client hello

L'intérêt de l'ECC est tel qu'il a souvent été intégré dans des composants par ailleurs limités à TLS 1.0 comme ici IE sur Windows Vista mais également les anciennes versions d'Android et les systèmes d'Apple.

TLS 1.2 (2008, RFC 5246)

TLS 1.2 apporte une évolution importante : AEAD —Authenticated Encryption with Associated Data— le chiffrement authentifié (défini en propre dans la RFC 5116) sous la forme des modes GCM et CCM. Malheureusement TLS 1.2 autorise l'usage de vieilles suites cryptographiques ce qui permet de réaliser des mélanges de modernité et d'archaïsme potentiellement dangereux.

Le simple fait activer TLS 1.2 côté serveur ne garantit pas d'avoir une configuration de qualité, c'est nécessaire mais pas suffisant. Le choix et l'ordre des suites cryptographiques utilisables ainsi que, dans une moindre mesure, le certificat employé vont également jouer un rôle déterminant.

AES-GCM (2008, RFC 5288)

GCM —Galois Counter Mode— est le premier mode de chiffrement authentifié défini et le plus utilisé de nos jours…

HMAC SHA2, ECC et AES-GCM (2008, RFC 5289)

…mais l'échange de clé ECDHE étant à privilégier, les suites cryptographiques considérées comme étant les plus sûres proviennent de cette seconde RFC, qui définit également les HMAC en SHA-2 pour les modes CBC.

AES-CCM (2012, RFC 6655)

L'autre mode de chiffrement authentifié n'a été ajouté que quelques années après sous la forme de CCM —Counter with CBC-MAC— ce qui a comme effet qu'aucun navigateur web ne l'utilise actuellement, il est disponible dans OpenSSL depuis la version 1.1.0.

ALPN —Application-Layer Protocol Negotiation— (2014, RFC 7301)

Cette extension permet d'indiquer dès la négociation TLS que le client web est disposé à faire transiter autre chose que HTTP, c'est-à-dire HTTP/2 (h2) ou éventuellement son ancêtre SPDY (spdy/3), si le serveur en est capable il va donc basculer vers le nouveau protocole. Il est à noter que pour assurer un niveau de sécurité minimal HTTP/2 prohibe une grande quantité de suites cryptographiques dont la liste d'exclusion figure dans l'annexe A : TLS 1.2 Cipher Suite Black List de la RFC 7540.
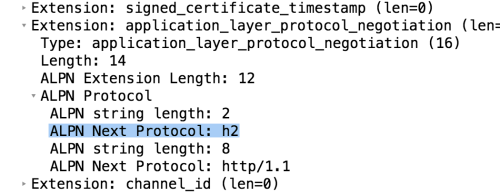
Protocole ALPN dans un client hello

Encrypt then MAC (2014, RFC 7366)

Les opérations disjointes de chiffrement et de contrôle d'intégrité opérées lors de l'utilisation du mode CBC se font dans un ordre qui n'est plus considéré comme le plus sûr. Cette RFC introduit une subtile modification pour remettre ces opérations dans le bon ordre à l'aide d'une énième extension… mais ceci arrive quelque peu tardivement car les clients et serveurs susceptibles de la mettre en œuvre disposent déjà du chiffrement authentifié sous la forme du mode GCM qui n'est pas confronté à ce problème. En définitive il semble qu'aucun client web n'intègre cette modification et TLS 1.3 réserve un sort tout particulier au mode CBC…

TLS Fallback SCSV (2015, RFC 7507)

Comme les versions les plus anciennes de TLS/SSL sont également les moins sûres, pour perpétrer une attaque un assaillant pouvant s'interposer entre le client et le serveur (on parle de MITM —Man In The Middle— en anglais) pourrait procéder à une attaque par repli qui consiste à proprement éliminer les demandes de négociations pour TLS 1.2 et TLS 1.0 et ne laisser passer que celle pour SSLv3.

Le serveur ne voyant arriver que cette dernière il négocierait donc cette version sans avoir la moindre notion qu'il s'est passé quelque chose sur le réseau. Mais si le client insère la SCSV —Signaling Cipher Suite Value— à la fin de la liste des suites cryptographiques qu'il souhaite utiliser lors de ses tentatives en mode dégradé, le serveur aura la possibilité que se rendre compte qu'il n'a pas affaire à un vieux client mais au contraire à un client récent dont les précédentes demandes ne lui sont pas parvenues, il pourra donc l'alerter en retour.

Extended Master Secret (2015, RFC 7627)

Pour lutter contre une forme d'attaque par interposition dite Triple Handshake cette RFC propose d'améliorer le calcul du secret partagé en y incorporant une empreinte portant sur l'ensemble des données échangées lors de l'établissement de la liaison.

Curve25519 et Curve448 (2016, RFC 7748)

Une pierre d'achoppement qui a retardé l'adoption de la cryptographie à base de courbes elliptiques est le choix des courbes en question, en effet certains redoutaient que les courbes proposées par le NIST —National Institute of Standards and Technology— comme P-256, P-384 et P-521 ne présentent des propriétés douteuses mais de prime abord bien cachées. Les nouvelles courbes 25519 et 448 issues des travaux de Daniel J. Bernstein devraient soulever bien moins d'objections.
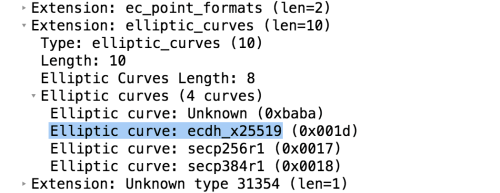
Courbe 25519 dans un client hello

Chrome et Firefox proposent déjà d'utiliser la fonction x25519 pour les échanges de clé ECDHE. Au passage : tout ce qui apparaît ici comme « Unknown » ne reflète pas une lacune de Wireshark, mais correspond à des valeurs fictives de type GREASE —Generate Random Extensions And Sustain Extensibility— dont le but est de stresser en permanence les implémentations TLS côté serveur pour voir si elles résistent a des données inattendues, ce système n'est qu'un brouillon à l'heure actuelle, voir draft-ietf-tls-grease.

ChaCha20-Poly1305 (2016, RFC 7905)

ChaCha20 est un nouvel algorithme de chiffrement par flux assez simple et rapide dérivé des travaux de Daniel J. Bernstein. Comme il est particulièrement adapté aux processeurs ARM (ceux qu'on trouve communément dans les téléphones et autres tablettes), il s'est très vite retrouvé dans Chrome et sur les serveurs de Google. Firefox n'est pas en reste, de même pour Safari depuis macOS High Sierra, mais il faut OpenSSL 1.1.0 ou une version récente de LibreSSL pour en disposer côté serveur.

EdDSA —Edwards-curve Digital Signature Algorithm— (2017, RFC 8032)

EdDSA est un algorithme de signature que l'on doit à… Daniel J. Bernstein et son équipe, il est relativement similaire à ECDSA mais est plus rapide et fait exclusivement usage des courbes Ed25519 et Ed448.

TLS 1.3 (2018, RFC 8446)

TLS 1.3 est une évolution très importante, elle apporte :

  • une vitesse accrue (en accélérant la négociation en réduisant les allers-retours entre le client et le serveur) ;
  • une sécurité renforcée (en désactivant ou améliorant tout ce qui pouvait être abusé dans TLS 1.2 et en incluant de nouveaux algorithmes).
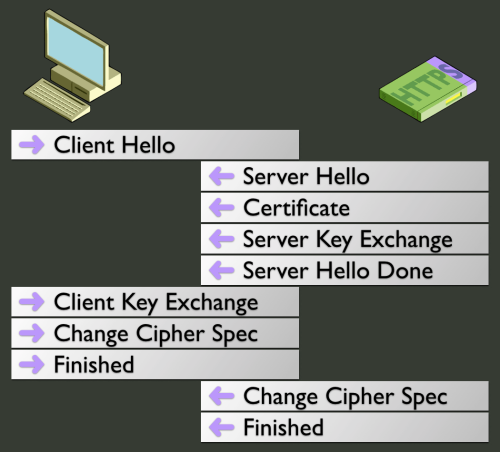
Processus complet d'établissement de la liaison sécurisée sous TLS 1.2

Le processus complet d'établissement de la liaison sécurisée ressemble le plus souvent à ces deux vagues d'aller-retour avec TLS 1.2.
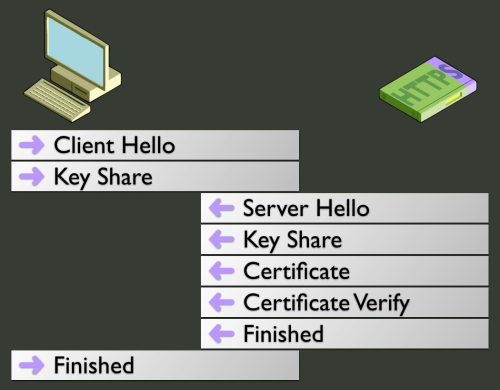
Processus complet d'établissement de la liaison sécurisée sous TLS 1.3

Avec TLS 1.3 l'ordre change, des anticipations ont lieu pour réduire les échanges au minimum, comme le client à encore la main après le « Finished » il peut transmettre une requête HTTP GET dans la foulée, réduisant en pratique l'échange complet à un seul aller-retour (1 RTT), ce qui devrait produire un gain conséquent lorsque le client et le serveur sont très éloignés ou lorsque le client passe par un réseau de communication mobile, la latence étant dans ces deux cas importante.

Il est à noter que le mécanisme de reprise de session a également été complètement remanié pour être plus rapide. L'implication de Google dans le développement et la promotion de HTTP/2 et TLS 1.3 et la large diffusion de HTTPS est considérable. Il n'est donc pas impossible qu'à l'avenir ils cherchent à accélérer l'adoption de TLS 1.3 en lui donnant un petit coup de pouce au niveau du classement des résultats de recherche, pour l'instant il n'y a rien de tel mais « plus sûr et plus rapide » est un bon facteur de différentiation qui peut être associé à TLS 1.3.

TLS 1.3 a la particularité d'être la première version à largement s'affranchir des recommandations du NIST et de ce fait d'une éventuelle influence de la NSA (dont certaines pratiques visant à affaiblir les systèmes cryptographiques ont été mises en lumière). Cela se traduit par l'adoption d'algorithmes dérivés des travaux de Daniel J. Bernstein (x25519, EdDSA, ChaCha20…), de ce fait on pourra à l'avenir basculer du tout NIST vers du tout DJB. Il est toujours possible d'utiliser les courbes NIST, ECDSA et AES avec TLS 1.3, mais il existe désormais une alternative pour chacun.

Par ailleurs un sacré coup de balai a été donné dans les vieilles suites cryptographiques, le mécanisme d'échange de clé le plus simple (celui chiffrant le secret partagé avec la clé RSA publique du serveur et qui n'offrait donc pas de confidentialité persistante) n'est plus utilisable, le mode CBC disparait de même que les vieux algorithmes de chiffrement comme Triple DES. L'élimination de tout ce qui n'a pas fait preuve de robustesse contribue à rendre TLS 1.3 sûr par défaut (contrairement à TLS 1.2 qui restait tourné vers le passé) et simplifie grandement sa configuration. Le seul point sensible, a priori, est la possibilité de faire du 0 RTT mais qui ne devrait pas être activé par défaut.

Mettre fin aux erreurs du passés

Le fait que l'on trouve encore autant de serveurs configurés avec une rétrocompatibilité bien trop étendue ou des suites cryptographiques dépassées a probablement plusieurs origines, configurer SSL/TLS n'a pas toujours été simple et clairement documenté (encore moins en français) et, une fois que cela fonctionne (les clients arrivent à se connecter), il peut être tentant de ne plus y toucher pendant quelques années… c'était d'autant plus facile lorsqu'il existait des certificats valables quatre ou même cinq ans. Les outils comme SSL Server Test de SSL Labs ou le redoutable CryptCheck d'Aeris qui attribuent des notes et proposent des améliorations ou le générateur de configuration de Mozilla qui s'efforce de simplifier la configuration de différents serveurs sont encore trop méconnus.
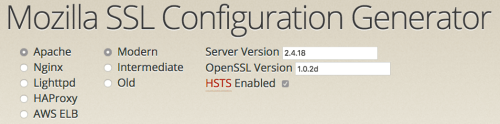
générateur de configuration de Mozilla

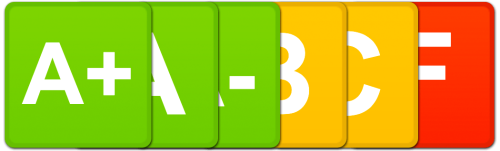
Notes SSL Labs

Le système de notation de SSL Labs évolue régulièrement pour s'adapter aux nouvelles failles ou bonnes pratiques. Le A obtenu aujourd'hui pourrait fort bien ne plus être qu'un B dans quelques mois.

En se fixant pour règle de n'utiliser que deux ou trois configurations TLS types (les configurations « moderne » et « intermédiaire » proposées par Mozilla sont un bon début), il est bien plus simple de s'assurer régulièrement que tous les sites que l'on contrôle restent dans les clous.

La sécurité informatique est un processus qui implique de remettre l'ouvrage sur le métier fréquemment et d'assurer un minimum de veille, sur ce sujet je ne peux que conseiller de s'abonner à la lettre mensuelle « Bulletproof TLS Newsletter » compilée par l'éditeur du livre qui fait office de référence dans le domaine : « Bulletproof SSL and TLS » d'Ivan Ristić.

Seuls des électrochocs comme BEAST, POODLE ou Heartbleed et certaines des révélations d'Edward Snowden ont eu pour effet d'accélérer l'adoption de technologies plus récentes. Le fait que la crypto sur le web n'évolue qu'en réaction à des incidents majeurs est plutôt inquiétant, on est loin d'une situation d'amélioration continue.

Le lancement de TLS 1.3 se fait dans un contexte totalement différent de celui de TLS 1.2, car TLS 1.3 a vocation à accompagner le passage au tout HTTPS lié aux craintes de piratages et de collectes massives d'informations sur le réseau. Cette nouvelle version est de plus soutenue par des acteurs de tout premier plan (des éditeurs de navigateurs et des opérateurs de CDN —Content Delivery Network—) qui ont produit le code nécessaire pour tester les versions préliminaires, ce qui promet une adoption très rapide par quelques acteurs qui génèrent un trafic conséquent.

Il faudra cependant de longues années avant que TLS 1.3 ne devienne la version la plus répandue sur l'ensemble des serveurs web (il faudra entre autres attendre une large diffusion d'OpenSSL 1.1.1 disponible depuis septembre 2018 et qui dispose d'un support à long terme). Il est cependant possible de s'inspirer des recommandations et des changements qui accompagnent TLS 1.3 pour mieux configurer TLS 1.2, se qui se traduit souvent par la désactivation de suites cryptographiques qui datent de SSLv3 et TLS 1.0 et un peu d'audace pour adopter plus de cryptographie basée sur les courbes elliptiques, y compris dans les certificats.


[1] Écrire le code informatique qui gère la cryptographie est une affaire de spécialistes, de ce fait les logiciels qui en ont l'usage (y compris les clients et les serveurs web) utilisent des bibliothèques spécialisées comme : OpenSSL (souvent utilisé par Apache via mod_ssl), LibreSSL (fork d'OpenSSL par l'équipe d'OpenBSD, facilement utilisable avec Nginx), BoringSSL (fork d'OpenSSL par Google se trouve dans Chrome et sur les serveurs de Google), Network Security Services / NSS (de Netscape puis Mozilla se trouve dans Firefox, peut être utilisé par Apache via mod_nss), Secure Channel / SChannel (de Microsoft, se trouve dans Windows et est utilisé par IE/Edge et IIS) ou encore Secure Transport (d'Apple, se trouve dans macOS et iOS et est utilisé par Safari). Ceci entraîne parfois des imprécisions, c'est notamment le cas avec Internet Explorer pour lequel il faudrait distinguer IE 8 sur XP d'IE 8 sur Vista car les versions de Secure Channel qui équipent ces deux systèmes n'ont pas exactement les mêmes capacités.

  •  

SubResource Integrity

Le Web devient une plateforme de plus en plus complète, et sa globalisation ou certains aspects de sa distribution (notamment via des CDNs) posent de nouvelles questions de sécurité. Qu'à cela ne tienne, de nouvelles spécifications offrent de nouvelles réponses à ces questions. Celle qui va être présentée dans cet article se nomme SubResource Integrity.

Introduction

Utiliser un CDN pour distribuer des contenus est dans certains cas une très bonne pratique, cela permet :

  • de mutualiser des ressources utilisées sur plusieurs sites ;
  • de permettre de les distribuer « au plus près » des visiteurs de vos sites ;
  • et également d'économiser de la bande passante pour tous les sites concernés.

Toutefois, cela comporte un risque. Si un attaquant prenait le contrôle du CDN et en profitait pour insérer du code malveillant dans certaines bibliothèques… instantanément, des centaines voire des milliers de sites pourraient :

  • être soit eux-mêmes attaqués par ce code malveillant ;
  • ou contribuer malgré eux à « infecter » leurs visiteurs.

Certaines bibliothèques ou frameworks sont massivement utilisées sur les sites web [1], ce risque est donc bien réel : la question de la confiance en un CDN externe est légitime [2].

Ce risque peut toutefois être bien atténué grâce à une spécification du W3c.

SubResource Integrity

C'est là qu'entre en jeu SRI, pour SubResource Integrity, en bon français le « contrôle d'intégrité des sous-ressources ». L'idée – comme son nom l'indique – est de vérifier l'intégrité de ressources, et ce, qu'elles soient sur un CDN ou ailleurs. L'objectif est de veiller à ce qu'aucun tiers n'injecte de contenu ou n'effectue aucune modification sur les ressources en question.

Historiquement, les discussions sur SRI ont commencé début 2014, le premier brouillon public de travail est sorti le 6 octobre 2015, et la spécification est devenue une recommandation officielle du W3c le 23 juin 2016.

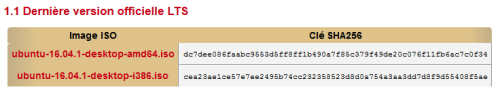
Le concept de vérifier l'intégrité de ressources n'est vraiment pas nouveau dans le milieu de l'informatique, les personnes habituées des téléchargements des distributions Linux voient depuis très longtemps ce genre d'informations lors d'un téléchargement d'une image ISO :

Intégrité d'une image ISO de la distribution Ubuntu

Voyons donc comment mettre cela en œuvre maintenant sur nos sites.

Mise en œuvre de SRI

Mettre en place SRI est très simple : il suffit d'indiquer un attribut integrity sur les balises script et/ou link – les seules supportées pour le moment – qui contiendra la valeur de contrôle d'intégrité du fichier (via une « fonction de hachage cryptographique », que nous appellerons un hash pour simplifier).

Cette valeur commence par au moins une chaîne (il peut y avoir plusieurs valeurs d'intégrité spécifiées, séparées par des espaces), chaque chaîne comprenant :

  • un préfixe indiquant l'algorithme utilisé (actuellement, les préfixes autorisés sont sha256, sha384 et sha512) ;
  • suivi d'un tiret…
  • …et se terminant par le hash proprement dit (encodé en base64).

Par exemple, cela nous donnerait :

integrity="sha384-yC7kyQdHbdC5s22r6nKzQXwcHKCLKBeg/XRG6mPMTyAUyT8f3htNhtQdFQnhBld5"

et cela s'intègrerait donc ainsi :

Cette valeur peut se calculer de plusieurs manières. Soit à la ligne de commande :

cat FILENAME.js | openssl dgst -sha384 -binary | openssl enc -base64 -A

Ou par exemple en PHP en supposant que $input soit le contenu du fichier :

echo base64_encode(hash('sha384', $input, true));

Note : pour calculer l'intégrité avec d'autres langages, Generating Subresource Integrity Checksums liste quelques exemples. Des outils permettent également de le calculer comme SRI hash ou de tester leur présence, comme SRI test, Mozilla Observatory ou encore Hardenize.

Note : si vous êtes familier de Content Security Policy, c'est sensiblement le même principe pour les hash.

Exemples simples en pratique

Voici deux exemples volontairement très simples :

En détail, voila ce qu'il s'est passé :

  • le navigateur télécharge les ressources ;
  • il détecte l'utilisation de SRI sur la feuille de style ;
  • il calcule donc l'intégrité du fichier en question, et la compare aux valeurs proposées dans les deux exemples :
  • dans le premier cas, la valeur correspond, la feuille de styles est appliquée…
  • …et dans le second la valeur ne correspond pas, la feuille de style est purement et simplement ignorée.

Quelques exemples de bibliothèques proposant SRI

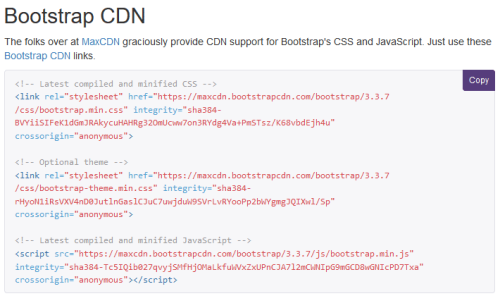
Si vous utilisez par exemple Bootstrap via un CDN, vous utilisez peut-être SRI sans même le savoir :

Intégration de Bootstrap via un CDN, avec SRI

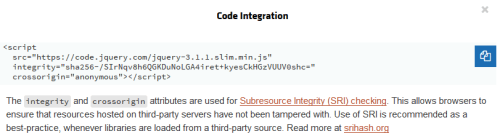
JQuery propose aussi SRI sur son CDN :

Intégration de jQuery via un CDN, avec SRI

Vous noterez sur ces exemples l'utilisation de l'attribut crossorigin="anonymous". Cet attribut permet d'indiquer que les requêtes CORS pour cet élément auront la balise de certificat vide [3]. De son côté, le CDN pourra indiquer avec un en-tête HTTP Access-Control-Allow-Origin: * que la ressource peut être accédée de n'importe quel domaine de manière croisée (cross-site).

Support

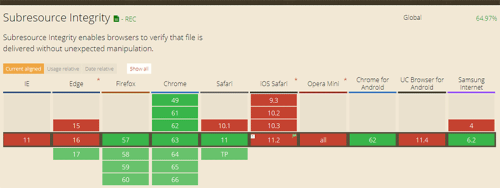
Au moment de la mise à jour de cet article (soit le 11 Janvier 2018), le support de SRI selon « Can I use » est le suivant :

Support de SRI sur Can I Use

Chrome, Opera, Safari et Firefox le supportent pleinement, cela arrive dans la prochaine version d'Edge et certains Webkits sont en train de le prendre en considération (sous iOS cela peut être activé, sans toutefois l'être par défaut). Toujours selon Can I use, SRI est donc supporté par environ 65% du parc des navigateurs, et son emploi ne gênera pas les navigateurs qui ne le supportent pas.

Il n'y a donc aucun souci pour le déployer massivement.

Avenir de SRI

Comme indiqué dans la spécification :

A future revision of this specification is likely to include integrity support for all possible subresources, i.e., a, audio, embed, iframe, img, link, object, script, source, track, and video elements.

Traduit en français, cela donne :

Une prochaine révision de cette spécification est susceptible d'inclure le support du contrôle d'intégrité pour toutes les sous-ressources possibles, c'est-à-dire pour les éléments a, audio, embed, iframe, img, link, object, script, source, track, et video.

Ajoutons à cela que CSP va bientôt proposer dans son niveau 3 de définir explicitement votre politique de sécurité concernant les ressources, par exemple, il sera possible d'indiquer au navigateur :

Content-Security-Policy: require-sri-for script style; 

Autrement dit, il sera possible de dire au navigateur de refuser l'exécution de scripts ou de styles qui n'ont pas de contrôle d'intégrité des ressources ! Même si l'idée de SRI est à la base destinée aux contenus chargés via CDNs, pourquoi ne pas étendre cette idée ? Une fois la page envoyée chez l'agent utilisateur, on ne contrôle pas nécessairement ce qu'il peut s'y passer [4], dans des cas avancés de besoins de sécurité, SRI et CSP pourraient être utilisés conjointement pour garantir que ce qui va s'exécuter chez l'agent utilisateur n'ait pas été modifié.

Bien entendu, cela suppose que la page en question fonctionne en amélioration progressive avec JavaScript désactivé, et que le processus de hash soit exécuté de manière indépendante de l'affichage de la page… à bon entendeur !

Conclusion

SubResource Integrity apporte une sécurité non négligeable, ce n'est pas un hasard si des outils comme Mozilla Observatory ou Hardenize recommandent son utilisation. Comme les navigateurs ne le supportant pas n'en auront cure, et que bon nombre de projets le proposent sur divers CDNs, vous n'avez plus d'excuse pour ne pas l'adopter, l'utiliser et/ou même le déployer vous-mêmes.

Ressources, compléments


[2] Imaginez simplement votre site mis sur de nombreuses listes noires et le temps (et donc le coût) pour l'en désinscrire…

[3] Vous pouvez lire à ce sujet Attributs de réglage du CORS.

  •  

Content Security Policy

De nombreuses initiatives tendent à amener plus de sécurité sur les sites Internet. La généralisation de HTTPS avec des initiatives comme Let's Encrypt, la restriction de l'utilisation de certaines API avec HTTPS, de nombreux outils permettant de tester et d'améliorer la sécurité des sites, etc.

Parmi ce vaste effort de sécurisation des sites, une technologie offre de nouvelles possibilités surprenantes sur le front-end. Son petit nom est « Content Security Policy ».

Introduction

Actuellement, quand un navigateur reçoit des contenus (images, CSS, JavaScript, etc.), son travail est de rendre la page le plus vite et le mieux possible. Hormis quelques mécanismes de sécurité qui seront abordés ici-même dans un futur proche, à aucun moment, ce dernier ne se pose ce genre de questions :

  • Est-ce que les concepteurs du site considèrent tel élément comme légitime ?
  • Dois-je bien exécuter ou prendre en compte tel élément ?

Ajoutons à cela que le front-end est souvent considéré comme un milieu extrêmement hostile :

  • il est de bon usage dans le back-end de ne jamais faire confiance à ce qui peut venir du front-end (formulaire, etc.) ;
  • l'agent utilisateur a toujours le dernier mot vis-à-vis d'un site qu'il consulte (styles utilisateurs, etc.), les concepteurs d'un site n'ont que peu de garanties de ce qu'il sera fait des pages qu'ils envoient ;
  • et une fois la page envoyée chez l'agent utilisateur, on ne contrôle pas nécessairement ce qu'il peut s'y passer [1].

Et pourtant, il existe bien des moyens de sécuriser certains aspects du front-end, et notamment via une technologie nommée CSP.

Des directives de sécurité front-end

CSP signifie « Content Security Policy », en bon français « Politique de Sécurité des Contenus ». L'idée est simple : en envoyant un en-tête HTTP, des directives de sécurité sont données au navigateur, et ce dernier les appliquera à la lettre. En clair, ces directives vont dire au navigateur ce qu'il est autorisé à exécuter… ou non.

Historiquement, CSP a été pensé pour réduire la surface d'attaque sur le front-end vis-à-vis des attaques dites de Cross-Site-Scripting (en anglais : mitigate XSS). En pratique, CSP permet d'aller beaucoup plus loin et offre de nombreux outils.

Fonctionnement et possibilités

Principes

Le principe est très simple : un en-tête HTTP est envoyé au navigateur contenant des directives de sécurité front-end. En voici un exemple via PHP :

header("Content-Security-Policy: ");

Voici quelques exemples de directives :

default-src 'self' ;

default-src sera la directive appliquée si aucune directive n'est définie pour un élément. Le mot-clé 'self' indique que tout ce qui sera sur le même port, même protocole et même nom de domaine sera autorisé.

script-src 'self' www.piwik.com ;

Dans cet exemple, la directive script-src indique donc 'self', et également que tous les fichiers JavaScript provenant de www.piwik.com seront autorisés à s'exécuter.

img-src 'self' data: ;

Cette directive img-src indique également 'self', le mot-clé data: autorise quant à lui les contenus dit embarqués (via data-uri).

Liste des directives

CSP niveau 1 permet de spécifier des directives pour les éléments suivants :

  • script-src : les sources autorisées pour les scripts JS
  • styles-src : les sources autorisées pour les styles CSS
  • img-src : les sources autorisées pour les images
  • connect-src : s'applique pour XMLHttpRequest (AJAX), WebSocket ou EventSource
  • font-src : les sources pour les web fonts
  • object-src : les sources des plug-ins (par exemple : , , )
  • media-src : les sources pour les balises et
  • etc.

CSP niveau 2 ajoute de nouvelles directives :

  • child-src : les sources valides pour les web workers et les éléments comme et (remplace frame-src déprécié de CSP niveau 1)
  • base-uri : les sources valides pour l'élément base qui indique l'adresse à utiliser pour recomposer toutes les adresses relatives contenues dans la page ()
  • form-action : les sources autorisées utilisées dans l'attribut action d'un formulaire
  • frame-ancestors : les sources autorisées à embarquer la ressource dans , , , ou
  • upgrade-insecure-requests : indique à l'agent utilisateur de réécrire l'URL en changeant HTTP en HTTPS (pour les sites avec beaucoup d'anciennes URLs qui ont besoin d'être réécrites).
  • etc.

Pour une meilleur rétro-compatibilité avec les directives dépréciées, il suffit de copier le contenu d'une directive dans la version dépréciée. Par exemple, il est possible de copier le contenu de child-src et de le coller dans frame-src.

Exemple

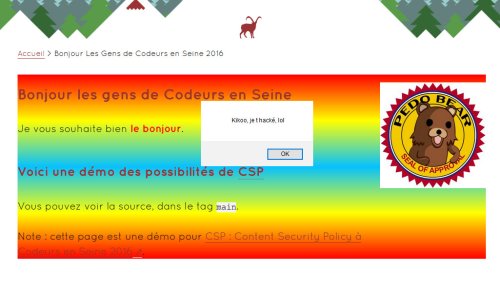
Voici un exemple présenté lors de la conférence « Codeurs en Seine » de cette année, cette page contient des éléments indésirables. Sans CSP, voici le résultat :

exemple de page sans CSP (page défacée)

Pas terrible. Envoyons des directives CSP au navigateur, voici un résumé des directives complètes.

content-security-policy: default-src 'none' ; script-src 'self' www.google-analytics.com ; style-src 'self' ; img-src 'self' www.google-analytics.com data: ; font-src 'self'; frame-ancestors 'none' ;

Que va-t-il se passer ? Le navigateur les reçoit et va les appliquer à la lettre selon la règle suivante : tout ce qui n'est expressément autorisé dans les directives CSP sera interdit. Par interdit, comprenez : bloqué, non exécuté, non affiché.

Point important : par défaut, le JavaScript en ligne n'est pas autorisé. Autrement dit, les balises script, attributs onclick, etc. dans le HTML ne seront pas autorisés. Cela peut se faire avec script-src 'unsafe-inline' et via script-src 'unsafe-eval', toutefois, c'est déconseillé (n'oublions pas que le but de CSP est de limiter les failles XSS).

Et il en va de même pour la fonction eval de JavaScript, ainsi que pour les styles en ligne. Autrement dit, ces directives qui semblaient être gentilles sont en fait plutôt strictes et autorisent le minimum nécessaire.

Le navigateur reçoit donc des éléments, les fichiers JavaScript/CSS sur le même nom de domaine/port/protocole seront donc autorisés, et un script dont la provenance n'a pas été autorisée sera bloqué. Idem pour le JavaScript et les CSS en ligne.

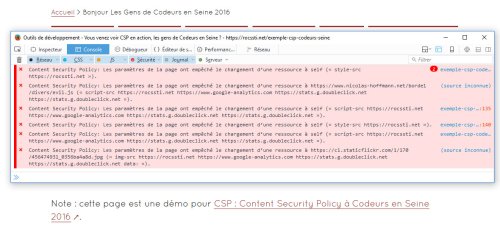
Le navigateur va indiquer dans la console les éléments bloqués et le pourquoi de ce blocage, exemple :

Notifications CSP dans la console du navigateur

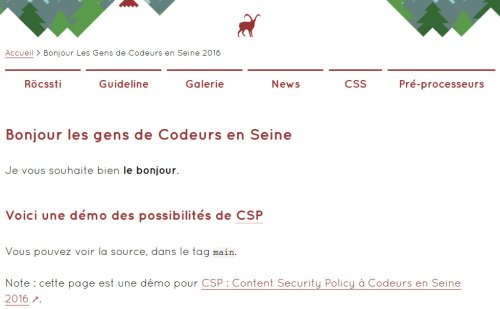
Et voici le résultat de la même page protégée par CSP :

exemple de la même page avec CSP (page normale)

Mieux, n'est-ce pas ?

Note : CSP ne « désinfectera » pas vos pages, il évitera juste l'exécution des contenus non autorisés.

Déployer CSP

Un premier conseil : ne foncez pas tête baissée pour déployer CSP sur un site en production en vous disant que cela sera facile. C'est probablement la meilleure façon si vous souhaitez… vous dégoûter de CSP. Ne faites pas ainsi sur un site en production, vous avez de grandes chances d'y laisser des plumes, vous êtes prévenus !

Comme vu précédemment, vous êtes entre des directives très précises et le navigateur, qui les appliquera de manière stricte et disciplinée. Le point faible sera donc très souvent… vous ! Il est très facile d'oublier une source de contenu, qu'un script a besoin de JavaScript en ligne pour fonctionner, etc. Et il n'est clairement pas dans la nature de CSP d'être indulgent.

Selon votre situation, cela peut être plus ou moins aisé, néanmoins il convient de prendre des précautions. Heureusement, plusieurs outils de CSP permettent de s'y préparer sans risque.

Report-URI

Les notifications envoyées dans la console du navigateur peuvent être envoyées sur une adresse, et donc traitées. Cela s'indique dans les directives via :

report-uri /csp-parser.php ;

Sur cette adresse, le navigateur enverra les notifications au format JSON. Voici un exemple volontairement minimaliste de script en PHP pouvant le traiter :

$data = file_get_contents('php://input');
if ($data = json_decode($data, true)) { $data = json_encode( $data, JSON_PRETTY_PRINT | JSON_UNESCAPED_SLASHES ); mail(EMAIL, SUBJECT, $data);
}

En clair :

  • le script reçoit les données ;
  • il vérifie que le format est bien du JSON ;
  • il aplatit les informations au format JSON en texte…
  • …et envoie par mail ce texte.

Ce genre de script est parfait pour un développement avec peu de fréquentation, où CSP est pris en compte depuis le début.

Important : attention sur une production beaucoup plus visitée ! Pour prendre un exemple, si une page génère 100 erreurs CSP, et que cette page est visitée 100 fois par jour, rien que cette page vous enverra 10 000 notifications par jour ! Pensez à filtrer sur votre adresse de report [2], ou le cas échéant à utiliser un service dédié à cette tâche, comme Report-URI.

Report-only

Comme vu précédemment, un des soucis de CSP est son côté binaire : on l'active… ou non. Une possibilité vient résoudre ce problème : Report-only.

Comme son nom l'indique, on va indiquer au navigateur de seulement rapporter les erreurs générées par les directives spécifiées, sans bloquer quoi que ce soit côté navigateur.

header("Content-Security-Policy-Report-Only: ");

Cela permet de tester des directives sans danger : soit en cas de premier déploiement de directives CSP, soit dans le cadre d'un renforcement de vos directives. Si par exemple des directives fonctionnent en production et que l'on souhaite les rendre plus strictes, on peut garder les directives et tester les directives plus dures sans risquer de bloquer quoi que ce soit.

En résumé, avec Report-URI et Report-only, vous pouvez tester des directives sans danger, et monitorer tout ce qu'il se passe d'un point de vue CSP.

Dans notre exemple donné plus haut, il est donc tout à fait possible d'être prévenu de suite que quelque chose d'anormal se passe sur la page.

Hashes et Nonces

Souvent le problème qui se pose vient des scripts en ligne : l'idéal est de ne pas les autoriser, mais les aléas d'un projet peuvent le nécessiter. C'est là qu'entrent en scène les hashes et les nonces. Même si ces deux possibilités sont amenées par CSP niveau 2 (et donc pour le moment pas supportées partout), en voici une présentation rapide.

Hashes

Sans autoriser tous les scripts en ligne, il est possible d'en autoriser certains, via un contrôle sur leur intégrité (via une « fonction de hachage cryptographique », que nous appellerons un hash pour simplifier). En pratique, cela se précise dans les directives :

script-src 'sha256-d08VMHuG2SHhy9Tk5IX7cA6bYafas7GiX/Fo9/hzDsY=' ;

Ce calcul d'intégrité correspond à ce script : . Il s'obtient ainsi : (exemple en PHP)

echo base64_encode(hash('sha256', "alert('bonjour le monde.');", true));
// donne : d08VMHuG2SHhy9Tk5IX7cA6bYafas7GiX/Fo9/hzDsY= 

Attention : le moindre espace change le résultat du calcul !

Nonces

Nonce signifie : Number used Once (« numéro utilisé une seule fois »). Encore une fois, cela se définit dans les directives :

script-src 'nonce-12345666789' ; 

Et cela s'utilisera ainsi :

Cela revient à dire au navigateur de ne rien bloquer pour ce qui correspond à ce nonce.

Attention : comme son nom l'indique, un nonce doit être unique, re-généré à chaque fois, et bien entendu doit être non trivial et non devinable !

Des spécifications plutôt bien stabilisées

Un point important à mentionner : CSP n'est pas une technologie qui fonctionne uniquement sur certains navigateurs en version alpha avec 5 flags à activer. CSP niveau 1 et 2 sont des Candidate Recommendations au W3c, les travaux sur la standardisation de CSP sont donc raisonnablement avancés.

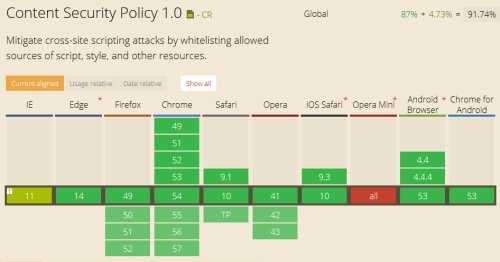
Côté support, le support du niveau 1 est excellent, comme le confirme le site « Can I Use » :

Support de CSP niveau 1 selon Can I Use

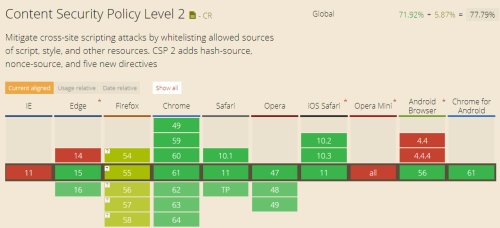
Le niveau 2 est plus récent, au moment de la mise à jour de cet article, le support en est plutôt bon sur les navigateurs récents :

Support de CSP niveau 2 selon Can I Use

Quoi qu'il en soit, le niveau 1 est tout à fait utilisable en production, le 2 aussi peut être envisagé pour des navigateurs récents. Le seul défaut de CSP consiste en de petits défauts d'implémentation chez les navigateurs : les soucis sont souvent des faux-positifs dans les notifications. On peut aussi noter que CSP est parfois trop efficace : par exemple les bookmarklets peuvent être bloqués par les directives CSP d'un site, alors qu'ils ne devraient pas l'être. Les divers navigateurs travaillent activement à régler ces soucis.

Pourquoi utiliser CSP ?

Il ne vous aura pas échappé que de nombreuses initiatives incitent à amener plus de sécurité en standard sur les sites internet. CSP en est un maillon particulièrement intéressant, ce n'est pas un hasard si des outils comme Mozilla Observatory, Dareboost, Hardenize, Security headers, etc. testent précisément son utilisation et vous incitent à le déployer.

La priorité : CSP est là avant tout pour la sécurité des utilisateurs. CSP aide à limiter les dégâts potentiels des failles de type XSS, et même plus largement sur les contenus que l'on peut qualifier d'indésirables. Un point important : toute la mécanique de CSP qui a été décrite ici… est totalement transparente pour l'utilisateur. Vous naviguez probablement quotidiennement sur des sites qui utilisent CSP (Twitter, Github, Facebook, etc.), et vous ne vous en êtes probablement pas rendu compte avant de lire cette phrase.

Ensuite, CSP est un outil extrêmement puissant pour les concepteurs/gestionnaires de sites, c'est à ce titre qu'on le qualifie souvent « de couteau suisse du front-end » [3]. De par la nature de CSP, pour faire fonctionner quelque chose sur votre front-end, vous devez savoir ce dont cela a besoin comme sources de contenus et comment cela va fonctionner (styles/JavaScript en ligne, fonction eval, etc.) [4].

De facto, l'activation de CSP vous invite à respecter de bonnes pratiques :

  • éviter les fonctions posées à la va-vite en inline, qui seront déportées vers des fichiers externes ;
  • connaître le fonctionnement intrinsèque d'un script ou d'un plugin ;
  • maîtriser vos sources de contenus et pouvoir poser une politique stricte en la matière ;
  • etc.

Si vous appréciez le concept de l'orthogonalité abordé dans L'orthogonalité en CSS, avec CSP, vous avez trouvé le meilleur allié pour le respecter !

Ce principe est d'ailleurs évoqué en tant que bonne pratique Opquast : les scripts manipulent des classes plutôt que les styles en ligne.

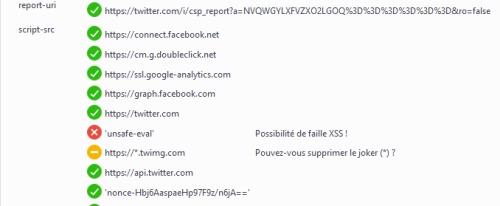
On peut même parler d'éco-conception : on ne s'autorise que le nécessaire, ce qui n'est pas un mal en soi. C'est extrêmement bien illustré par exemple dans Firefox si vous faites Maj + F2 et si vous tapez security CSP, on vous encourage à réduire la surface d'attaque autant que possible sur vos directives : (exemple sur Twitter)

Affichage des directives CSP de Twitter sous Firefox

De plus, constatant que le poids moyen des pages ne fait qu'augmenter ces dernières années, s'appliquer un peu de frugalité ne fera de mal à personne !

Le futur de CSP

En l'état actuel des choses, le niveau 1 est tout à fait utilisable en production. Le niveau 2 peut être plus délicat à déployer, du fait du support moins large de ses possibilités (seulement les navigateurs les plus récents).

Les travaux ont commencé sur le niveau 3, qui devrait amener de nouvelles directives. Toutefois, comme ce niveau est actuellement à l'état de brouillon de travail, il n'est pas nécessaire d'aller plus avant. Si le sujet vous intéresse, vous pouvez consulter des ressources sur le sujet en bas de cet article.

Conclusion

CSP est un outil absolument fantastique pour le front-end qui permet :

  • de limiter les effets d'attaques XSS et de contenus indésirables ;
  • de servir de trousse à outils pour des opérations importantes (migration HTTPS, etc.) ;
  • d'organiser une maîtrise globale de votre front-end tout en servant de garde-fou pour des bonnes pratiques ;
  • mais en plus de surveiller et de monitorer ce qu'il se passe sur le front-end.

Cette technologie a tout pour retenir votre attention, et vaut la peine d'être essayée et déployée à grande échelle.

Ressources, compléments


[4] Et cela va parfois vous surprendre lors de l'utilisation de scripts tiers…

  •  

HTTPS : introduction

Disposer d'un web intégralement sécurisé par défaut, avec HTTPS utilisé en lieu et place de HTTP, est le souhait de certains acteurs majeurs du net depuis quelques années. Cette nouvelle série d'articles traite différents aspects du fonctionnement de TLS (anciennement SSL) pour mieux comprendre les enjeux associés et aborder sereinement la configuration de ce protocole.

Cet article d'introduction explique le rôle et le fonctionnement global de HTTPS, les articles spécifiques se focalisent plus en profondeur sur un point précis.

  1. De SSL à TLS 1.3
  2. Le certificat PKIX (parution à venir)
  3. Les suites cryptographiques (parution à venir)
  4. À double tour (parution à venir)

En raison de la diversité des hébergeurs, serveurs, autorités de certification et besoins de compatibilité avec des clients web plus ou moins anciens, ces articles ne sont toutefois que des guides et non des tutoriels pour configurer un logiciel particulier.

Bien au-delà du cadenas

Pour le grand public HTTPS est souvent associé à la présence rassurante du petit cadenas verrouillé à proximité de la barre d'URL et malheureusement également à quelques clics rapides sur des boutons OK lorsqu'une alerte relative à un problème de certificat surgit.

URL sécurisée par HTTPS

Le S qui signifie sécurisé dans HTTPS provient de TLS —Transport Layer Security— qui est un protocole supplémentaire et indépendant qui se positionne entre TCP et HTTP qui demeurent pratiquement inchangés.
La sécurisation de la connexion répond à trois besoins principaux : authentifier le serveur, garantir la confidentialité et l'intégrité des données échangées.
Cela ne concerne donc que les données en transit et n'améliore que marginalement la sécurisation du serveur lui-même, mais rendre bien plus difficile la récupération de cookies ou d'identifiants de connexion peut éviter quelques mauvaises surprises.

L'annonce de Google de signaler, dès le début 2017, comme non sécurisée toute page web qui propose un formulaire de saisie de mot de passe ou de carte bancaire hors HTTPS devrait encore accélérer le mouvement de migration de HTTP vers HTTPS, de nombreux sites ayant déjà fait le saut suite aux révélations d'Edward Snowden en 2013.
Par ailleurs HTTP/2 (ou h2), la nouvelle version de HTTP, nécessite en pratique la présence de TLS. Pour mettre en place HTTP/2 et bénéficier de ses accélérations une étape préliminaire est donc de passer intégralement en HTTPS.
Il y a toujours plus de raisons techniques d'utiliser HTTPS, comme accéder à l'API de géolocalisation avec les navigateurs modernes, mais la première raison devrait être le respect de l'utilisateur et de ses données.

Premier contact

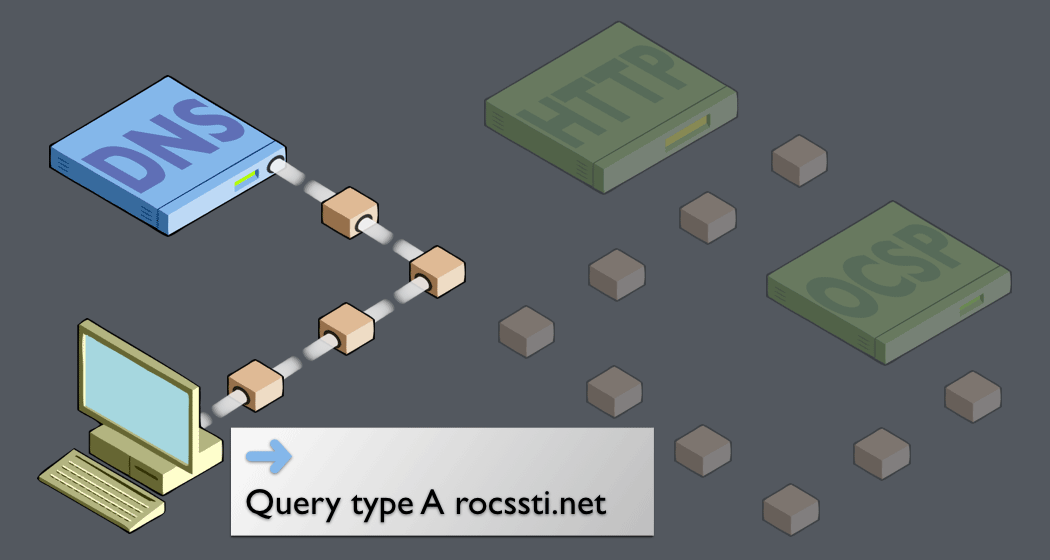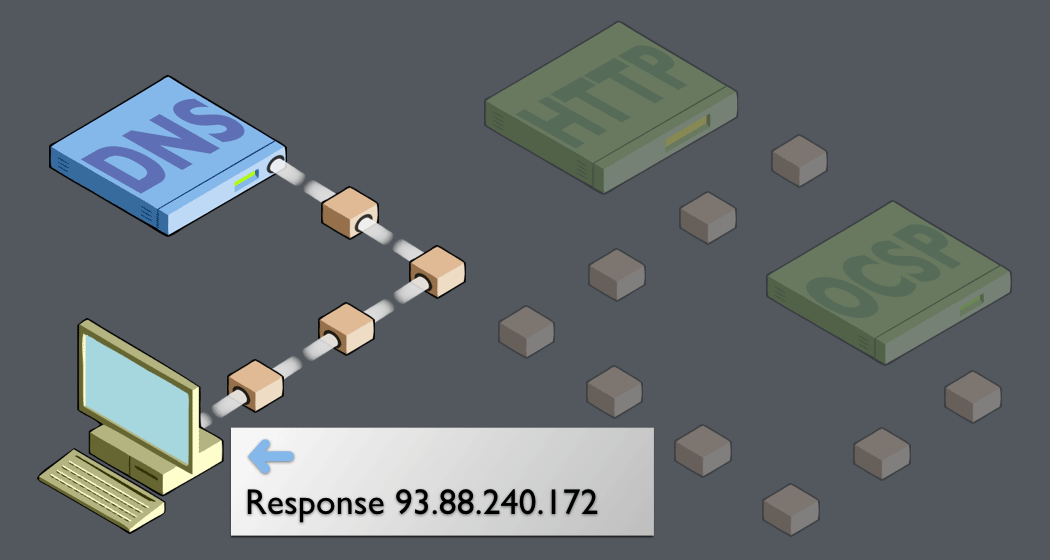
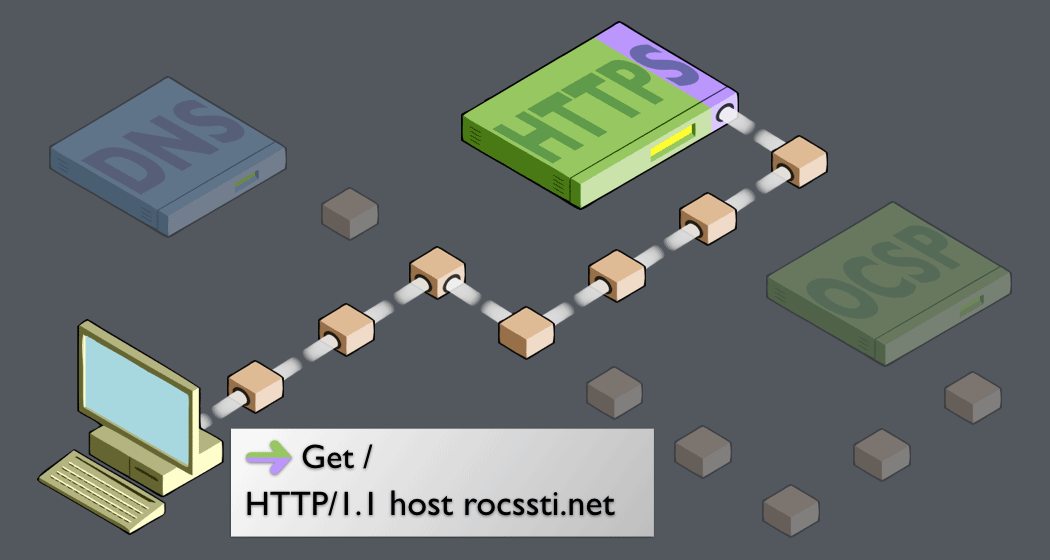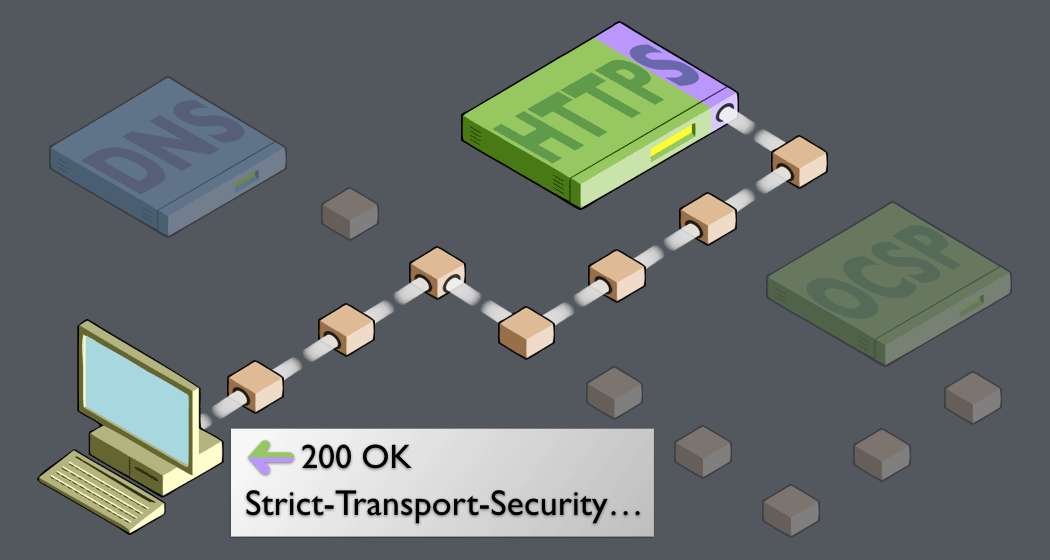
Voici comment se déroule typiquement l'établissement d'une connexion HTTPS lors d'une première visite d'un site.
Le client a tout d'abord besoin de déterminer l'adresse IP associée au nom de domaine du site web, si cette information n'est pas disponible dans une mémoire cache locale (suite à une requête antérieure) une demande de résolution est émise vers un serveur DNS.

Malheureusement les données locales du client pourraient avoir été altérées, le résolveur DNS pourrait avoir été empoisonné par des informations erronées ou tout simplement mentir et, pour finir, un élément actif du réseau pourrait intercepter la demande et retourner une réponse falsifiée… Cela tromperait le client et l'orienterait en direction d'un serveur probablement malveillant, d'où la nécessité pour un serveur HTTPS légitime de pouvoir s'authentifier en prouvant qu'il a été préalablement reconnu par un tiers de confiance comme étant bien celui attendu.

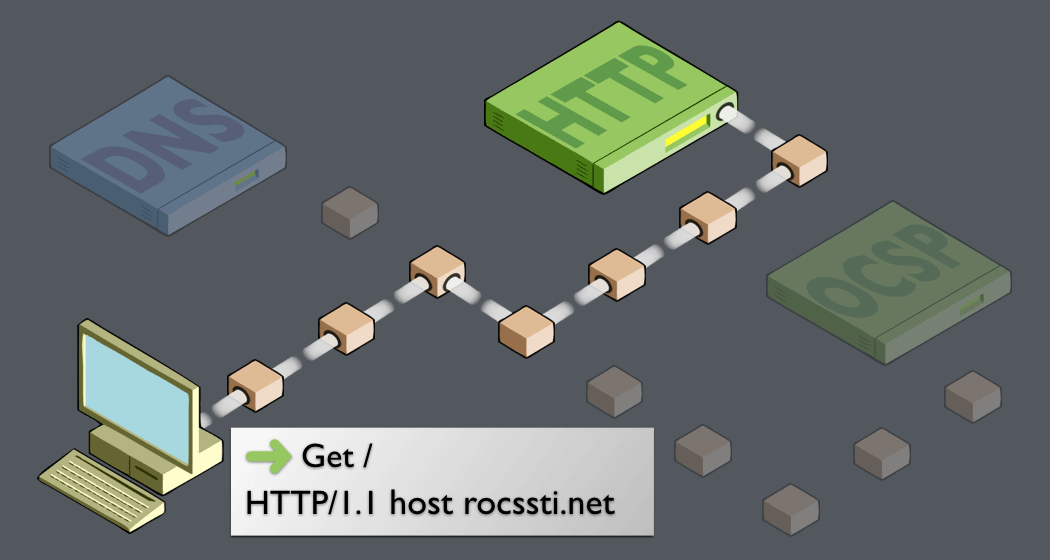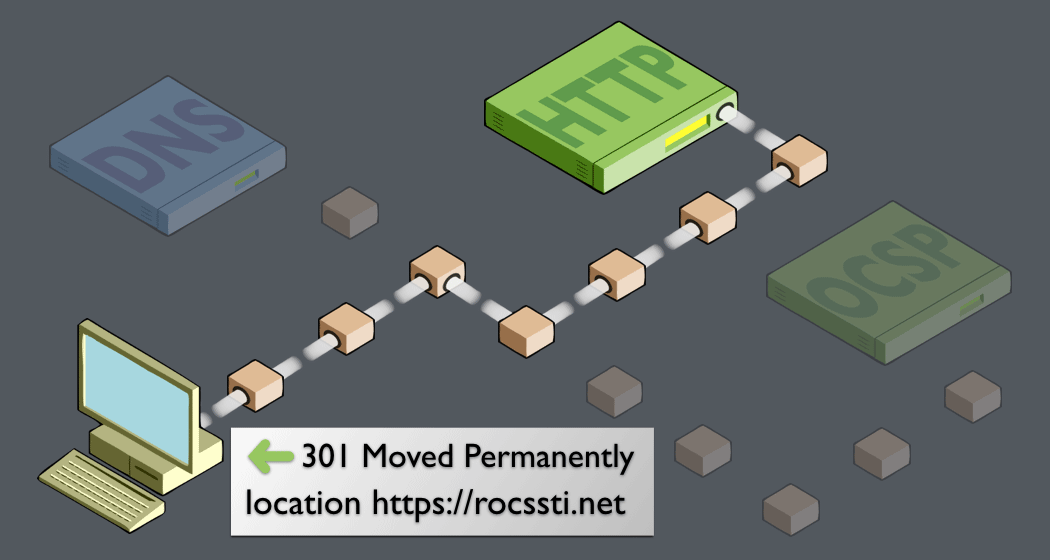
Une fois en possession de l'IP du serveur le client peut le contacter avec le protocole HTTP sur le port 80. Dans le cas présent le client demande simplement l'élément du site situé à sa racine, celle-ci est symbolisée par un simple caractère /.

Le serveur ne renvoie pas au client les données qu'il attendait mais lui indique avec une redirection HTTP 301 que ce qu'il cherche est désormais disponible à un autre emplacement accessible en HTTPS (techniquement parlant le protocole fait partie de l'URL, la redirection correspond donc à un déplacement de site). Le site HTTP ne sert donc plus qu'à rediriger automatiquement ses visiteurs vers la version HTTPS. Ceci constitue également une bonne pratique SEO pour éviter que les moteurs de recherche ne détectent du contenu dupliqué et donc dévalorisé.

Il existe toutefois deux cas qui pousseraient le client à communiquer directement en HTTPS lors d'une première visite :
  • l'URL précise explicitement le protocole sécurisé et commence donc par https://
  • le domaine est inscrit sur la liste de préchargement HSTS

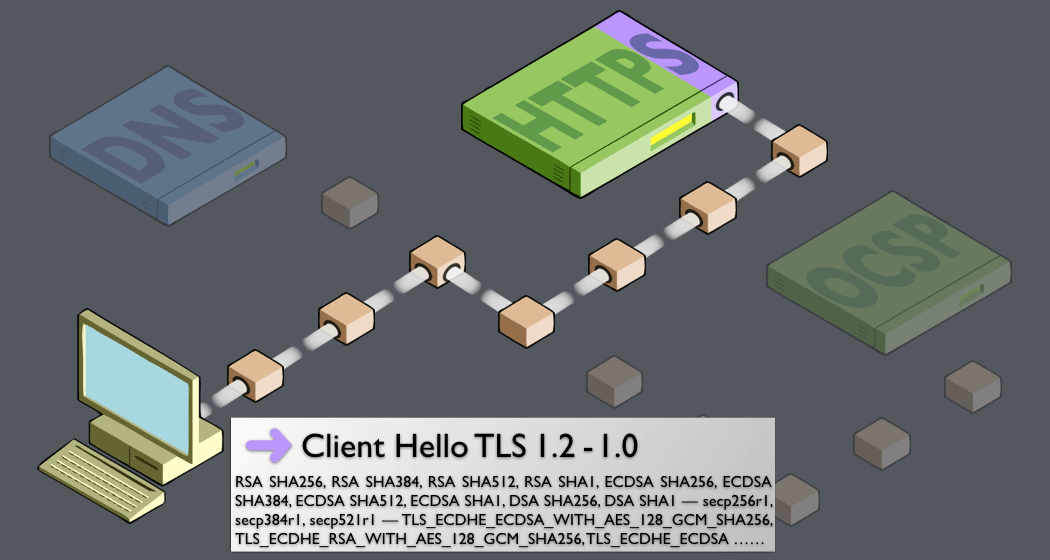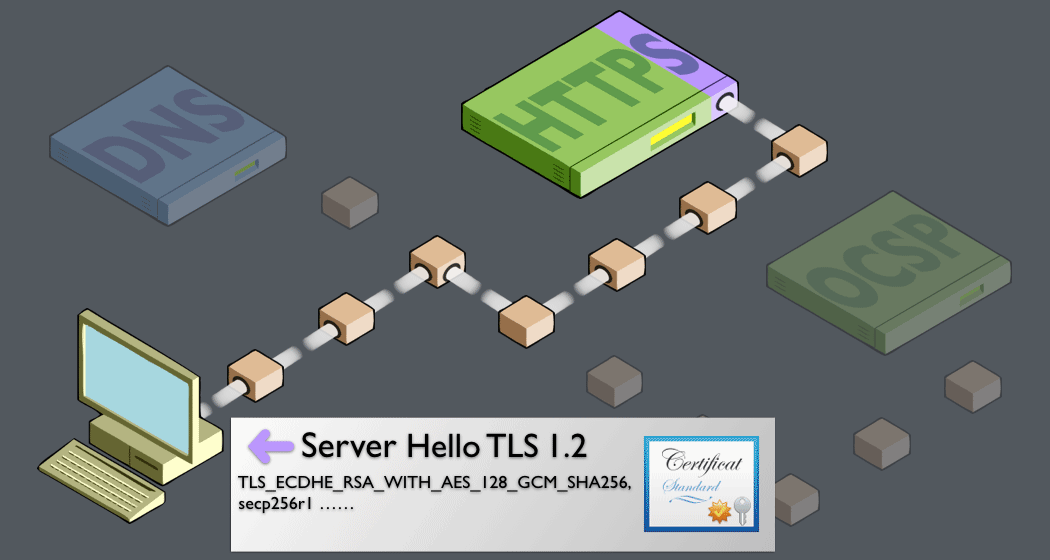
Le client délaisse temporairement le protocole HTTP car il a en premier lieu besoin d'établir la connexion sécurisée. Pour ce faire il s'adresse au port 443, qui est communément dédié à TLS, il énumère alors tout un inventaire de ses capacités relatives à ce protocole (algorithmes de signature acceptés, courbes elliptiques connues, suites cryptographiques préférées…).

En fonction des desiderata du client le serveur va retourner un certificat contenant une clé publique qui permettront de l'authentifier, il indique également quelle suite cryptographique il a retenu pour chiffrer les données. Celle-ci va déterminer le mécanisme d'échange de la clé de chiffrement, ainsi que l'algorithme de chiffrement symétrique et la méthode de vérification d'intégrité qui seront mis en œuvre par la suite.

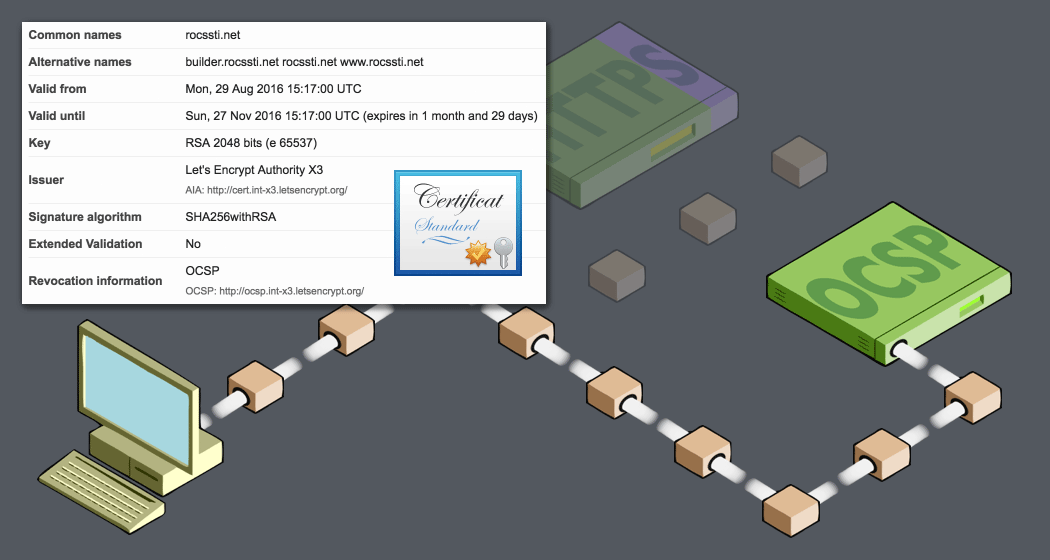
Une fois le client en possession du certificat il va s'assurer de sa conformité en vérifiant plusieurs points dont les principaux sont :

  • la présence du nom du domaine visité parmi ceux présents sur le certificat
  • la période de validité
  • la signature apposée par l'AC —Autorité de Certification— qui a émis le certificat
  • la possibilité de remonter la chaîne de confiance d'AC en AC jusqu'à une AC racine reconnue
  • l'absence de publication sur des listes de révocation de type CRL et/ou OCSP.

Les raisons pour déclencher une alerte de sécurité relative au certificat sont donc nombreuses et parfois obscures. Le grand public ayant tendance à vouloir passer outre, les navigateurs ont commencé à modifier la présentation des alertes pour rendre l'accès au contournement moins facile, de plus certains en-têtes HTTP peuvent désormais inhiber cette possibilité.

Une fois l'échange (ou construction) de la clé de chiffrement symétrique réalisé, un canal de communication chiffré est établi, le client et le serveur ne communiqueront désormais plus qu'à travers celui-ci, rendant de ce fait leurs échanges inintelligibles au reste du monde.

Le client transmet alors une nouvelle requête HTTP GET mais en passant cette fois par le canal chiffré, le serveur lui répond désormais pleinement par cette même voie, couramment le serveur précise via un en-tête HTTP STS —Strict Transport Security— qu'il exige d'être contacté en HTTPS à l'avenir.

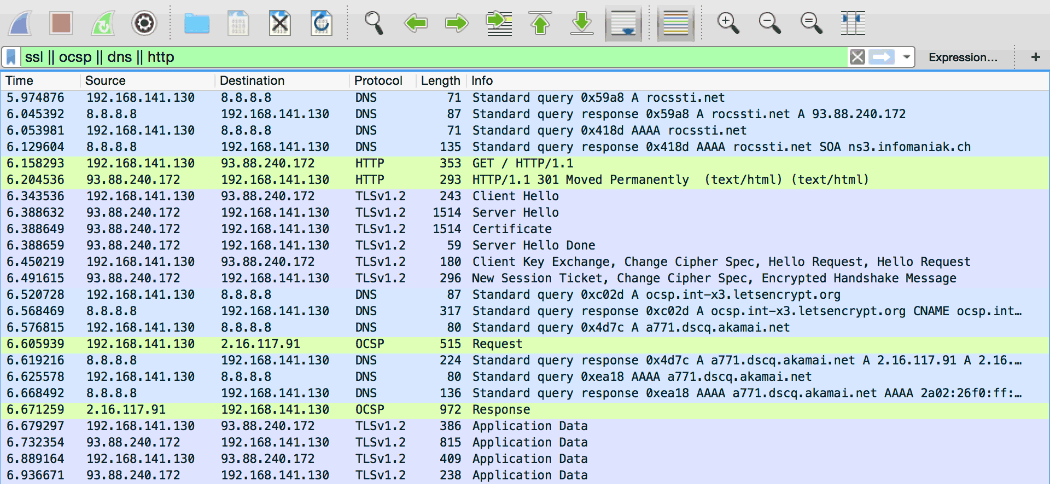
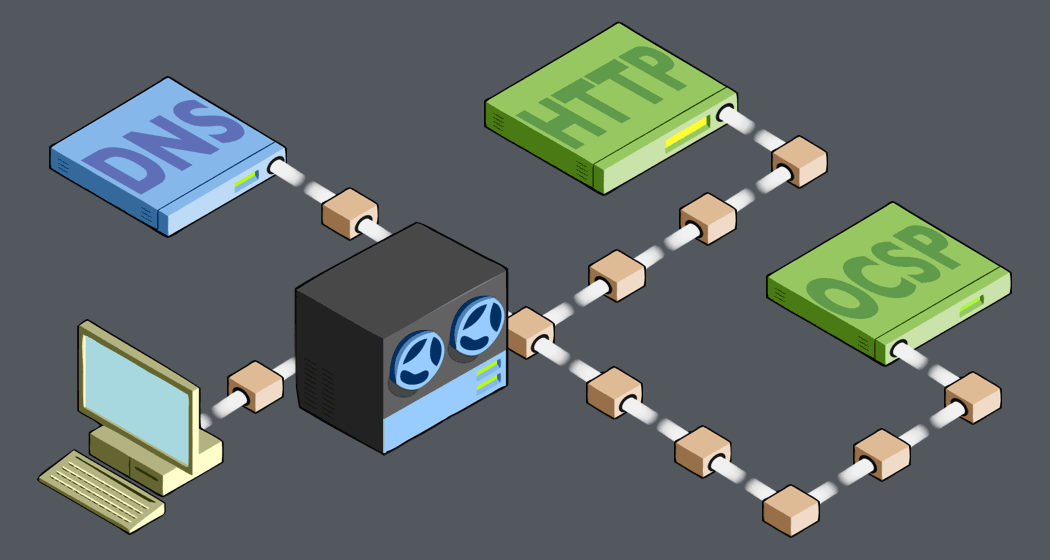
Il est parfaitement possible de capturer et décortiquer ces premiers échanges avec un analyseur de paquets réseau comme Wireshark, une fois la connexion chiffrée le résultat est bien sûr un peu plus opaque…

En l'absence de connexion sécurisée le contenu des échanges peut être consulté et même modifié en tout point du réseau, cependant les points d'accès WiFi gratuits sont particulièrement sensibles, car n'importe qui peut en monter un et il est très facile de les écouter.

La NSA —National Security Agency— (et très probablement d'autres agences gouvernementales tout autour de la planète) collecte massivement et sans distinction toutes sortes de données sur le net. Certains des documents divulgués par Edward Snowden ont été mis en relation avec des recherches universitaires qui laissent peu de doutes quant aux capacités dont dispose la NSA pour casser le chiffrement d'une partie du trafic Internet mal protégé, en particulier en raison de l'utilisation de clés asymétriques trop petites ou basées sur des primitives trop communes. Il est donc devenu crucial de veiller sur ces points car ce qui aujourd'hui encore n'est qu'à la portée d'agences gouvernementales pourrait devenir le business quotidien d'organisations criminelles d'ici quelques années.

2016 année de transition

Extérieurement on pourrait croire que rien n'a changé en 20 ans, en fait c'est en partie vrai, avec des certificats régulièrement renouvelés un serveur correctement configuré à la fin des années 90 aurait pu fonctionner sans problème visible jusqu'en novembre 2014… c'est-à-dire jusqu'au moment où les navigateurs ont commencé à désactiver SSLv3 en leur sein pour contrer l'attaque POODLE. En pratique depuis 2011 et plus encore suite aux révélations d'Edward Snowden en 2013 le petit monde de la crypto sur le web est en ébullition et tente de rattraper des années de retard et d'immobilisme.

2016 est clairement une année charnière, Let's Encrypt a distribué de manière automatisée plus de 10 millions de « certificats SSL » gratuits depuis son lancement fin 2015, ce qui contribue très concrètement à l'adoption généralisée de HTTPS. Cela permet à un nombre croissant d'hébergeurs de proposer HTTPS au même coût qu'un hébergement classique et sans nécessairement avoir besoin d'une IP en propre pour chaque domaine grâce au support de l'extension TLS nommée SNI —Server Name Indication— qui est très largement répandue, ce qui tombe à pic avec la pénurie d'IPv4 qui est devenue une réalité.

Depuis le 1er janvier 2016 les autorités de certifications n'ont plus le droit d'émettre de certificats dont la signature repose sur un condensat SHA-1, SHA-256 s'est donc largement généralisé et les navigateurs vont commencer à rejeter les vieux certificats encore en SHA-1 début 2017.

Depuis le début de l'année la méthode de chiffrement RC4 (le fleuron des années 90) est progressivement retirée des navigateurs modernes et à la place Chrome, Firefox et Opera acceptent désormais ChaCha20 ; de son côté le chiffrement AES est couramment accéléré matériellement y compris sur les processeurs d'entrée de gamme chez Intel et AMD.

HTTP/2 qui impose de nombreuses restrictions quant à la configuration TLS sous-jacente est désormais activable avec Apache 2.4.17, Nginx 1.10.0 et IIS 10 sur Windows Server 2016.

Les spécifications finales de TLS 1.3 devraient être publiées d'ici quelques mois, mais il faudra de toute façons de longues années avant que cette version ne devienne prédominante (pour autant une importante part du trafic web mondial devrait en bénéficier très rapidement du fait de son adoption quasiment acquise sur les serveurs de Google et Cloudflare d'une part et dans Chrome et Firefox de l'autre). Mais on peut d'ores et déjà s'inspirer de TLS 1.3 pour mieux configurer TLS 1.2.

De plus la large diffusion d'OpenSSL 1.0.2 au sein des dernières distributions GNU/Linux et l'ancrage de LibreSSL à sa place dans certains systèmes *BSD devraient également faciliter l'obtention de configurations TLS correctes, sans parler d'OpenSSL 1.1.0 qui vient de faire ses premiers pas avec quelques nouveautés très intéressantes.

HTTPS partout, sécurité NULL(part)

HTTPS partout c'est bien, mais avec un S de qualité c'est encore mieux. Les navigateurs affichent toujours le même cadenas (parfois affublé d'un petit complément pour signaler un soucis comme du contenu mixte) mais il faut bien comprendre que les différents mécanismes en œuvre pour établir la liaison sécurisée vont produire une connexion plus ou moins robuste en fonction des capacités respectives du client et du serveur. Il est possible d'avoir une estimation de cette robustesse avec des extensions comme Calomel SSL Validation ou SSleuth pour Firefox, le premier est quelque peu plus simple d'accès avec un simple code couleur visible dans un premier temps et des indications plus détaillées disponibles au besoin, je vous conseille de l'installer car il permet d'accéder rapidement à des informations précieuses pendant la phase de configuration et plus généralement au quotidien voir du jaune ou du rouge à son niveau devrait vous alerter.

Sur cette page du site de test badssl.com on voit que le blason est bleu alors que c'est la couleur verte qui est associée aux meilleures notes, ici la note globale n'est que de 89%.

Les navigateurs peuvent éventuellement indiquer les paramètres TLS en cours d'utilisations mais ces informations ne sont pas toujours accessibles facilement et souvent incomplètes.

Google Chrome donne les informations les plus détaillées et qualifie individuellement le protocole, l'échange de clé ainsi que la méthode de chiffrement soit de robuste soit d'obsolète. Sur la même page de test on voit que Chrome considère le chiffrement AES 256 bits en mode CBC avec un HMAC SHA-1 comme étant obsolète… Il y a de quoi froncer un sourcil car AES 256 bits est considéré comme étant ce qui se fait de mieux en matière de chiffrement, mais comme souvent en sécurité le diable est dans les détails et pour Chrome ce sont le mode CBC et le HMAC SHA-1 qui posent problème. Pour autant le cadenas est tout ce qu'il y a de plus normal et en apparence tout va bien, mais il n'est pas inenvisageable que d'ici 3 ou 4 ans certains navigateurs refusent de se connecter sur un site configuré de la sorte car techniquement on peut d'ores et déjà faire mieux et à l'avenir l'usage du mode CBC pourrait être découragé.
Les phrases précédentes contiennent quelques acronymes qui ne sont pas détaillés dans cette introduction. Il y a beaucoup d'acronymes en cryptographie, ce qui ne facilite pas vraiment la compréhension du sujet lorsqu'on l'aborde en néophyte. Il y a une vingtaine d'années Netscape 4 proposait à ses utilisateurs d'activer ou non certaines suites cryptographiques (y compris une sans chiffrement, également connue sous le nom de chiffrement NULL), le grand public était alors directement exposé à de tels acronymes.

Aujourd'hui Safari ne restitue strictement aucune information concernant le protocole ou la suite cryptographique en service, on voit le cadenas et on peut consulter le certificat c'est tout. Toute la « culture » cryptographique est occultée, a posteriori on sait que la majorité des utilisateurs de Netscape et leurs descendants n'ont retenu que deux vagues notions : SSL ça crypte (sic) et plus il y a de bits mieux c'est crypté (sic), traumatisme très certainement lié à la première « crypto war » et ses restrictions à l'export hors US.
Les articles spécifiques font le tour d'une bonne partie des concepts et des acronymes liés à cette culture cryptographique bien au-delà du cadenas donc, leur parution devrait avoir lieu progressivement dans les prochains mois. En attendant si vous souhaitez commencer à creuser le sujet et décortiquer la configuration SSL/TLS d'un site déjà existant l'incontournable SSL Labs devrait se révéler très précieux.

  •  

Comment le Web est devenu illisible…

Il y a de cela quelques années, nous avions publié un article sur les contrastes de texte.

Malheureusement, force est de constater que le temps ne fait rien à l'affaire. Kevin Marks le déplore dans son billet intitulé How the Web Became Unreadable. Selon lui, les dernières modes en design poussent à l'adoption de contrastes de plus en plus faibles. Si cela ne pose pas (trop) de problème sur les excellents écrans high-tech que les designers, n'ayant par ailleurs pas besoin de lunettes, utilisent pour concevoir leurs interfaces, il n'en est pas de même dans le monde réel, où les conditions de consultation et les situations de chacun varient énormément.

When you build a site and ignore what happens afterwards — when the values entered in code are translated into brightness and contrast depending on the settings of a physical screen — you're avoiding the experience that you create. And when you design in perfect settings, with big, contrast-rich monitors, you blind yourself to users. To arbitrarily throw away contrast based on a fashion that “looks good on my perfect screen in my perfectly lit office” is abdicating designers' responsibilities to the very people for whom they are designing.

En guise de complément, et en plus de ceux que nous avons indiqués dans notre billet de 2012 mentionné plus haut, voici quelques outils :

  •  

Paris Web 2016

L'édition 2016 de Paris Web approche à pas de géant (« Paris Web is coming, you know nothing » disait ce cher Tim Berners Snow) : c'est dans moins d'un mois !

Cette onzième édition se déroulera du 29 septembre au 1er octobre et explorera selon le célèbre motto « les thèmes de l'accessibilité Web, du design numérique et des standards ouverts ».

En fait, des sujets extrêmement divers et variés vous attendent : internationalisation, CSS, surveillance du Web, UX, crypto-parties, sécurité, éthique, JavaScript, retour d'expérience, accessibilité, qualité, bonnes pratiques, etc. sans compter les informelles qui s'improviseront durant les journées des conférences, et probablement aussi durant les ateliers.

Pour ceux qui étaient là aux éditions précédentes, le lieu vous est désormais connu : le magnifique Beffroi de Montrouge. Les ateliers seront quant à eux à la Web School Factory.

Le thème de cette année est : nous avons tous et toutes un rôle à jouer.

Plus que jamais, la propre veille technologique est une question importante dans nos métiers, parfois délicate, et Paris Web est manifestement le lieu idéal pour cela, notamment grâce à la richesse des échanges sur place, qui nous donne toujours l'impression d'en savoir plus qu'hier, et moins que demain.

Si vous venez pour la première fois, n'hésitez pas à nous contacter, nous nous ferons un plaisir de discuter avec vous. Dites-vous bien que cet événement est tout sauf impersonnel.

Encore une fois, un effort remarquable est fait pour l'accessibilité de l'événement : vélotypie, LSF, lieux accessibles, doublage francophone pour les conférences en anglais, etc. Autant le dire clairement, Paris Web est sûrement l'un des événements en pointe sur ce sujet (si ce n'est le meilleur).

Bref, dépêchez-vous de vous inscrire, vous auriez à notre humble avis tort de manquer cela !

Post-scriptum : peut-être votre(vos) sujet(s) n'a(n'ont) pas été retenu(s) ? Si nous n'avions qu'un conseil à donner : ne vous arrêtez pas là, et parlez de vos sujets. Lors d'autres événements, à Paris Web, sur d'autres sites, sur le vôtre, sur votre blog, etc. ou pourquoi pas ici-même : qui sait où cela pourra vous mener ? ;)

  •  

Humeur : chers services tiers, et si vous vous associez à nous ?

Ou : de l'importance de ne « pas trop déconner ». Explications.

Il existe une offre pléthorique de services web : hébergement, analyses diverses, polices de caractères, modules divers et variés de réseaux sociaux, zones de chaleur (heatmaps) sur nos pages, publicité (si si !), services de vidéo, services de commentaires, etc.

Ces services – permettez-moi ce truisme – nous rendent bien service dans notre relation avec nos clients, en tant que prestataires de sites Web, nous devons sans cesse conseiller et orienter pour offrir des informations à nos clients, répondre à leurs besoins, et ce toujours dans le but d'améliorer nos prestations, et par extension d'améliorer l'efficacité, la performance, etc. de leurs sites.

Un fait récent nous a particulièrement marqué : l'IAB (Interactive Advertising Bureau) écrit un mea culpa franc et massif à propos des abus de la publicité en ligne intitulé We messed up (littéralement, « on a déconné »). Certes, au point que les utilisateurs, ulcérés de nombreux abus, se mettent à utiliser des contre-mesures (bloqueurs de pubs ou de trackers) ou tout simplement à ignorer des sites devenus impraticables. Certes, « ils ont vraiment déconné ».

Mais si l'on regarde en perspective, ils n'ont pas été les premiers à déconner, et ils ne seront sûrement pas les derniers. Élargissons notre regard sur le domaine. Exemples :

La guerre des navigateurs entre Netscape et Microsoft, qui rivalisaient d'implémentations non-standards et non interopérables, parfois en dépit du bon sens : à l'époque, IE4 proposait comme une évolution de permettre par exemple de jouer des fichiers de musique MP3 en arrière-plan. (quoi qu'on en dise, lancer de la musique non-sollicitée n'a jamais été une bonne pratique, et ce n'est pas près de le devenir)

Suite directe de cette guerre des navigateurs, IE6 en position d'ultra-dominance qui n'a pas évolué entre 2001 et 2006 : les problèmes de sécurité s'amoncelaient, les besoins de standards et des nouvelles normes qui mirent encore des années pour arriver.
Encore dans cette période, les mythiques popups : à priori, une possibilité pratique, mais dont nombre de sites ont tellement abusé… que les utilisateurs ulcérés ont fini par tuer totalement à grands coups de bloqueurs de popups.

Toujours dans cette période, l'explosion de la bulle internet : l'effet « nouvelle économie » qui déborde sur tous les secteurs, des investissements/endettements qui atteignent des niveaux records et des perspectives largement sur-évaluées.

Plus proche de nous, le poids moyen des pages qui continue de grimper : les pages s'alourdissent régulièrement.

Etc.

Bref, nous pourrions énoncer une loi empirique : tout système qui « déconne » un peu trop finit par se prendre un sévère retour de bâton. Plus gênant, souvent le retour de bâton est tel… qu'on va vers un autre extrême. C'est exactement ce qu'il se passe avec la publicité actuellement. Néanmoins, hors de tout manichéisme anti ou pro-publicité, certains sites ont réellement besoin de la publicité en ligne.

Revenons à nos clients. Comme vous pouvez l'imaginer sans problème, ils sont toujours plus exigeants, et l'exigence de qualité de nos clients nous invite à leur proposer des services qui répondent à ces souhaits. Nous ne ménageons pas nos efforts pour trouver les meilleurs services, lorsqu'ils existent.

Et malheureusement, si un service a une qualité globale plutôt mauvaise, nous pouvons être amenés à le retoquer et à ne même pas le proposer. Pour rester dans le sujet de la publicité, si le client a ce que l'on appelle un budget de performance, vous vous doutez bien qu'il ne va accepter qu'une publicité ruine ses efforts à ce sujet.

Nous en arrivons au titre de ce billet, cette invitation à nous associer. Nous avons besoin de vous, et vous avez besoin de nous. Nous testons la performance, l'accessibilité, la sécurité, l'empreinte écologique, etc. bref, des tas de points de qualité, car nous voulons bichonner les sites de nos clients.

Suivez-nous dans cette démarche.

  • testez vos propres services intégrés sur un site ;
  • observez les résultats ;
  • améliorez vos services ;
  • le cas échéant écoutez et répondez aux demandes de vos utilisateurs, qui peuvent être de bon conseil.

Certains le font très bien, et nous en sommes ravis. Continuez :)

À bon entendeur !

  •  

La troisième guerre des navigateurs est terminée et c'est un bain de sang

Daniel Glazman, que nous avions déjà eu le plaisir d'interviewer ici-même, a récemment présenté une conférence à Web2Day sobrement intitulée « La troisième guerre des navigateurs est terminée et c'est un bain de sang ».

Autant ne pas tourner autour du pot, vous devez voir cette vidéo.

Morceaux choisis :

On est tous là (au W3C) pour faire avancer le Web dans une direction générale, mais avec beaucoup de petites directions particulières qui sont les intérêts stratégiques de chacun des industriels présents.

Quand on a 58,7% (à propos de Chrome), on a un poids majeur dans la standardisation, on fait ce qu'on veut.

Les standards sont un acquis dans le paysage du Web (…), et pourtant, (Google) ils continuent de faire des daubes, vu que c'est pour eux-mêmes, et les autres n'ont qu'à suivre et implémenter.

On est revenus à un monopole d'un vendeur de navigateur… qui en profite.

Non seulement, vous ferez un impressionnant tour sur l'histoire du Web, le fonctionnement du W3C, les navigateurs… mais en plus ce tour sera certifié sans langue de bois, grâce à la verve désormais légendaire de l'orateur.

La vidéo est ici : La troisième guerre des navigateurs est terminée et c'est un bain de sang

(Bien que le titre soit en anglais, la vidéo est en français)

  •  

D-Day : ending or milestone?

So you've been working for months on the new version of your Website? I guess you're pretty sure that the day this new version will go online will be a very important date for the users, for your customers, or for the Web, maybe. But it won't. The day your new version goes online is not an ending but the beginning of a story with your users.

(Note: this article was previously published in French –if you have any feedback on the translation made by Nicolas Hoffmann and Coralie Mercier, please let us know.)

Today, I'm going to address one of the most significant challenges in managing a web project. A common error is to consider the official date of release of the site as the end date of the project. This perception is wrong, and it has major consequences not only on the quality of the site, but also on the motivation of the teams. This is why I speak of this matter to you today.

Considering the release date of a site as the end of a web project is a quite natural mistake. The teams responsible for the production of the site are indeed judged by their hierarchy at this time and not necessarily on the next phase, that is to say, when the site takes life and evolves. Moreover, focusing on creating the site is much more attractive, as it's a very varied step, often exciting, than focusing on the life phase of the site, which is much less rewarding. And yet.

The official release date of a site, always long awaited, is often disappointing for the teams of the Web project. Certainly for project teams and their managers who are waiting for a new version, whose production takes several months, this date actually marks a completion.

However, for the site itself and its users, it is a date that marks the beginning of an even more important phase. In fact, the release date of the website marks the beginning of the life phase, of adjustments and production of new contents and services.

Whatever your efforts, your rigor and competence during the site creation phase, nothing will replace the feedback of real users of the site that will come during the life of the site. Sure, you can anticipate a lot of things, but if you choose to offer at the official release date a complete and perfect site, you make a beeline for failure and disappointment.

The success of an online service comes in the long run. Whatever your skills, the volume and quality of your content, the feedback and congratulations that you may have when releasing the site will only be temporary, and bear very little importance after years following the release date.

It is indeed in the months and years that follow the release date of the site you can show that your site is not a set of content and services introduced one time at a particular date, but a set of content and services in constant evolution.

Operationally, this vision can lead to apply major rules to drive your Web project. And since nothing beats a recipe, here are seven ;-)

  • Accept imperfection: As I have often written, it is the first fundamental step in the Web business. This acceptance is a required step to adopt a continuous improvement process and not perpetually suffer the inherent imperfections of Web business.
  • Do not dream: If you do not want to be disappointed, do not expect too much out of your site release, and get ready to work for a long time.
  • Anticipate updates: separate fundamental contents from those that can be published later on. The impression that will be left by a large amount of information will never be as good for your site as a regular publication of new content.
  • Limit your ambitions: plan changes after the site release, and if the project seems too heavy, move optional components intended for the first version to future publications.
  • Plan ahead: allocate the budget of your site on the long term and integrate costs related to its further development. Do not bury your head in the sand. Right from the design of the functional specifications, it is possible to detect items and identify human resources necessary to maintain the site.
  • Be careful: remember that each feature, each section, each content mentioned in the specifications of your future site implies costs. Those costs will be spent much later.
  • Standards are for you, not for the others: compliance with web standards, best quality practices, accessibility rules are not just constraints, they will lead you to improve the scalability of your site. You will make mistakes. You will! Standards should especially be used to ensure that these mistakes are easy to correct and do not cost you too much.

There you go! Good luck for the release of your site. If you can grasp the D-day as a milestone and not as the end, you will not be disappointed ;-)

  •  
❌