 Connexion

ChatGPT Wallet : les agents d’OpenAI peuvent désormais régler les achats en ligne
 OpenAI ouvre le paiement à ses agents IA avec un portefeuille conçu avec Visa, Mastercard et American Express, réservé pour l’instant aux abonnés Pro américains.
 OpenAI ouvre le paiement à ses agents IA avec un portefeuille conçu avec Visa, Mastercard et American Express, réservé pour l’instant aux abonnés Pro américains.
 Avec Businesses in ChatGPT, OpenAI permet aux entreprises de revendiquer leur fiche, de la mettre à jour et de suivre leur visibilité dans le chatbot.
 Lancé fin août en France, ChatGPT Ads tient-il ses promesses ? Après plusieurs semaines de tests, l'agence Origine by ORIXA livre ses premiers enseignements, entre conversions inattendues, secteurs porteurs et pièges à éviter.
La banque en ligne européenne fait tourner GLM, un modèle ouvert conçu en Chine, sur des serveurs dédiés. Elle affirme avoir divisé sa facture d’IA par dix tout en livrant plus vite.
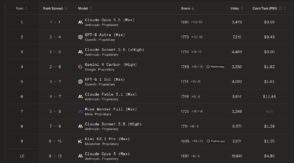 Grâce à Claude Opus 5.5, Anthropic conserve la tête de la WebDev Arena. Mais OpenAI, Google, Meta et Moonshot se rapprochent dangereusement.
 Rédigé par un ingénieur d’Anthropic, un brouillon de norme IETF reçoit le soutien de Google, OpenAI et Microsoft. Leur déploiement s’étale jusqu’en 2027 selon les acteurs.
Mistral a présenté Mistral Large 4, un modèle d'intelligence artificielle à 1 000 milliards de paramètres que l'équipe surnomme elle-même "Le Chonk", et l'entreprise française annonce ni plus ni moins que c'est le meilleur modèle ouvert jamais développé en dehors de la Chine. Rien que ça.
Le modèle n'est pour le moment accessible qu'en préversion via l'API de Mistral, l'interface qui permet aux développeurs de la brancher sur leurs applications. Les poids, autrement dit le fichier complet qui permet de faire tourner le modèle sur ses propres serveurs, arriveront le 27 octobre sur Hugging Face, le grand entrepôt public des modèles d'IA.
C'est tout le contraire des boîtes noires d'OpenAI ou d'Anthropic, le créateur de Claude, qui gardent jalousement les leurs.
Sur le papier, le chiffre de 1 000 milliards en jette, sauf que le Chonk n'active que 49 milliards de paramètres à chaque réponse, avec une architecture qui fonctionne un peu comme une grosse administration où seul le guichet compétent traite votre dossier. Du coup, il coûte bien moins cher à faire tourner que sa taille ne le laisse penser.

L'entraînement a pris deux mois sur près de 4 000 puces Nvidia Grace Blackwell installées dans les datacenters européens de Mistral, soit deux à trois fois moins de matériel que la concurrence chinoise d'après Pierre Stock, le responsable scientifique de la maison. Le modèle parle au passage plus de 160 langues.
Mistral insiste surtout sur les capacités agentiques de son Chonk, c'est-à-dire sa faculté à enchaîner tout seul des actions, lancer du code, éplucher des documents, remplir un tableur, plutôt que de simplement répondre à vos questions.
Sur les tests de performance publiés par Mistral, le Chonk se place au niveau des meilleurs modèles chinois de DeepSeek, Alibaba ou Moonshot sur le code, la finance et le droit, avec une vraie pointe en cybersécurité où il se classe parmi les cinq meilleurs au monde. Les mesures indépendantes sont un peu moins flatteuses, puisque le cabinet Artificial Analysis le situe entre DeepSeek et les modèles les plus accessibles d'OpenAI, encore loin du haut de gamme GPT-6 Astra, ce qui est déjà pas mal pour un modèle qu'on pourra télécharger gratuitement.
Côté tarifs, l'API facture environ 0,70 dollar le million de tokens, les morceaux de mots qui servent d'unité de facturation à tous les fournisseurs d'IA. Airbus et HSBC figurent déjà parmi la centaine de clients revendiqués.
J'avoue que je me demande déjà quelle machine il faudra pour faire tourner un bestiau pareil dans un salon, mais c'est tentant.
Source : TechCrunch

 Mistral AI présente Mistral Large 4 comme le meilleur modèle à poids ouverts d'Europe et des États-Unis. Un lancement très attendu pour une entreprise soupçonnée d'avoir décroché face aux laboratoires chinois et américains.
 La technologie d'OpenAI oriente le choix des mots de ses modèles pour laisser une empreinte invisible, pouvant être repérée par son détecteur. Mais la méthode a ses failles.
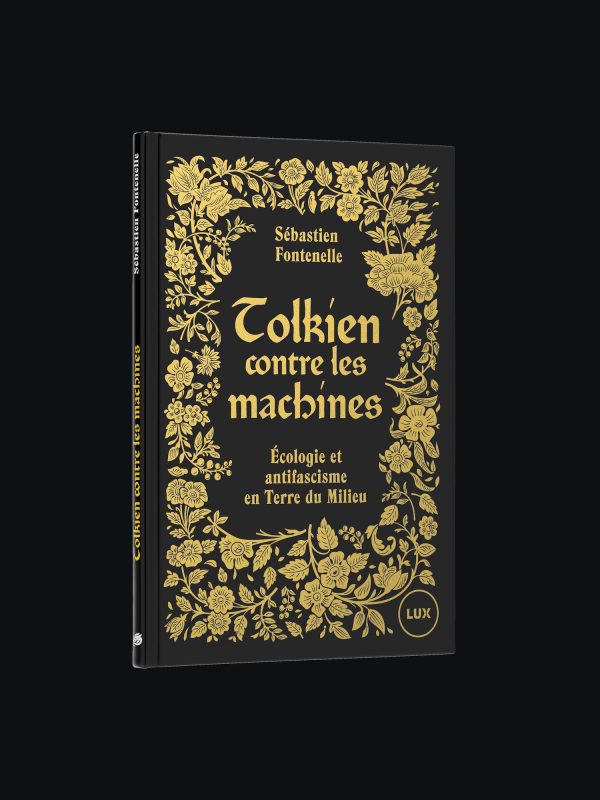
Bon, Tolkien: nazi ou pas? « Ou pas », répond avec assurance – et aussi pas mal d’arguments – Sébastien Fontenelle, dans son court essai Tolkien contre les Machines.
À l’origine de ce texte, une tendance lourde chez les techbros, libertariens et autres cryptonazis des USA et d’ailleurs: celle de s’accaparer des œuvres de l’imaginaire pour leurs délires suprémacistes. Que l’on pense à Grok, nom honteusement piqué par Elon Musk à En terre étrangère, le bouquin probablement le plus turbogauchiste de Heinlein, ou à Peter Thiel et ses compagnies pillant sans vergogne les termes inventés par Tolkien.
Que cette engeance n’ait jamais rien compris à ces œuvres – si tant est qu’ils les aient lues et/ou que ce ne soit pas juste une démonstration supplémentaire de leur cynisme – est un fait moult fois documenté. Mais il est vrai qu’il y a dans les œuvres de John Ronald Reuen Tolkien des éléments qui font douter du progressisme du bonhomme.
À commencer par ses propres propos. Dans sa correspondance, il se définit comme un réactionnaire et affirme abhorrer le socialisme. De plus, converti très tôt au catholicisme, il est très croyant. Il y a également des propos glorifiant la « race nordique », chose qui transparait assez nettement dans les Terres du Milieu, où la civilisation est au nord et à l’ouest, là où la barbarie est à l’est et au sud.
Certes. Mais Tolkien, s’il est né en Afrique du Sud (alors dominion britannique), a vécu presque toute sa vie en Angleterre, c’est-à-dire ce qui se fait de plus nord-ouest en Europe. Le contexte de la première moitié du XXe siècle pèse aussi lourdement sur son point de vue sur le monde.
Dans Tolkien contre les Machines, Sébastien Fontenelle met surtout l’accent sur l’amour que porte l’auteur à la nature et sa profonde détestation des mutations – ou plutôt, les destructions – que le monde moderne y apporte.
Dans sa démonstration, sous-titrée Écologie et antifascisme en Terre du Milieu, l’essayiste met en avant le peuple des hobbits, qui forme une communauté presque anarchiste, sans chefs et où l’économie semble surtout basée sur les cadeaux. Et c’est ce peuple, sans histoire et sans ambition autre que de vivre une bonne vie, qui va donner aux Terres du Milieu ses deux grands héros, Bilbo et Frodon.
L’autre épisode, c’est l’affrontement entre Isengard, la tour que Saroumane a transformée en un complexe militaro-industriel, et les Ents, cette civilisation d’êtres-arbres. On n’a aucun mal à y lire la revanche de la nature sur ses destructeurs.
S’ajoutent à cela quelques éléments de la vie de Tolkien qui viennent rééquilibrer les propos sus-mentionnés. Sa réponse à un éditeur allemand qui voulait s’assurer de son « aryanité » avant de traduire Le Hobbit vaut son pesant de currywurst.
Donc, le prévenu Tolkien, fasciste? Assurément pas, mais assez clairement conservateur, tout en ayant un amour de la nature qui le rapprocherait aujourd’hui des écologistes et de la décroissance. La démonstration de Sébastien Fontenelle est plutôt convaincante, mais je l’ai trouvée un peu « légère ». À l’image du bouquin, d’ailleurs, avec ses 128 pages.
Ça fait un moment que je lis la prose de Sébastien Fontenelle et je n’ai pas pu manquer que c’est quelqu’un avec des idées qui seraient de gauche si elles étaient plus conservatrices. Je dirais que Tolkien contre les machines est un texte qui est plus du domaine du pamphlet que de l’essai. Il ne lui manque pas grand-chose pour être plus solide et, quelque part, c’est un peu dommage. Mais en l’état, pour peu qu’on soit plutôt sensible à un biais de gauche (comme la réalité), c’est une lecture intéressante.
L’article « Tolkien contre les Machines », de Sébastien Fontenelle est apparu en premier sur Blog à part.
Blog à part est un blog sans publicité. Son contenu est distribué sous licence Creative Commons (CC-BY).
Si vous souhaitez me soutenir, vous pouvez me faire des micro-dons sur Ko-Fi, sur Liberapay, sur Patreon et sur Ulule.

 Claude Opus 5.5 Max prend la tête du classement général et du front-end de la WebDev Arena, tandis que GPT-6 Astra Max s'impose sur les tâches fullstack.
 Avec 31 types de données sur 35, Muse, l'agent IA de Meta, est l'un des plus gourmands en termes de données collectées, selon le dernier classement de Surfshark.
 Au menu : des agents IA qui "œuvrent en permanence à vos côtés", un modèle qui frôle les performances de GPT-6 Astra pour un coût inférieur, et une série de nouveautés pour Codex.
 Après Muse de Meta, OpenAI dégaine à son tour un agent IA conçu pour travailler en permanence, même quand ChatGPT est fermé.
 Des documents qui se mettent à jour à partir des outils connectés, des présentations éditées à plusieurs et un espace partagé avec les agents IA : ChatGPT se rapproche un peu plus de la bureautique.
 Une semaine après la sortie de GPT-6 Sol, OpenAI dévoile une version améliorée qui égale Astra sur certains tests de code. Le tarif ne change pas, mais le modèle est désormais classé au niveau critique en cybersécurité.
On 17 September 2026, the European Commission unveiled its proposal for the EU KIDS Act (EU Keeping Internet Digital Spaces Accountable and Trustworthy), a harmonised EU framework designed to reshape how children engage with online services. The proposal goes well beyond age verification requirements and seeks to fundamentally change the design of digital services used by minors, placing greater responsibility on technology providers to create age-appropriate digital environments. It builds on existing legislation such as the EU Digital Services Act (DSA) and the EU AI Act but introduces more specific rules focused on child safety.
Which Services Are Covered?
The KIDS Act imposes extensive obligations on a broad range of online services. Its scope extends beyond social media platforms to encompass a wide range of online services, including:
Summary of key requirements
The proposal is built around four core themes:
A key feature of the proposal is the establishment of common age-based rules governing children’s access to social media and certain video-sharing platforms across the EU. The Commission’s objective is to introduce a gradual and age-appropriate pathway into the online environment, reflecting growing concerns about the impact that social media and algorithm-driven content can have on children’s wellbeing and development. The Commission emphasises the need for a harmonised framework to avoid a fragmented landscape of national age thresholds and access requirements.
Under the proposal:
In addition, under the proposal, providers would be required to determine whether existing account holders are under the age of 15. Accounts belonging to users identified as under 15, or whose age cannot be verified, would need to be disabled. Providers designated as Very Large Online Platforms (VLOPs) under the DSA would face additional obligations, including submitting a compliance plan demonstrating, through robust technical and evidentiary measures, a “high degree of confidence” that users have reached the age of 15.
While the age-based access rules have attracted the greatest public attention, the KIDS Act’s broader ambition is to address the design choices that can encourage excessive use, amplify harmful content, or expose minors to inappropriate interactions. In doing so, it reflects a growing regulatory view that children’s online safety cannot be achieved through parental controls and age verification alone, but must be embedded into the architecture of the services themselves.
To achieve this, the proposed KIDS Act requires a wide range of online services used by minors, including social media platforms, video-sharing platforms, online games, AI companions and chatbots, to implement extensive safety-by-design measures. These include:
The proposal also introduces specific safeguards for AI companions and chatbots. This includes requiring AI companions to be disabled by default for minors and avoid design features and system behaviours that simulate interpersonal relations that are likely to create emotional dependencies, manipulate behaviour or otherwise exploit children’s vulnerabilities.
The proposal introduces specific age assurance obligations requiring providers to establish whether users are above or below relevant age thresholds and to ensure that children are provided with experiences, features and protections that are appropriate for their age. The proposal also introduces a framework for verifying parental responsibility where an adult seeks to create or manage an account on a child’s behalf.
The proposal acknowledges that effective age assurance must be balanced with users’ privacy and data protection rights. As a result, it emphasises that age verification and age estimation mechanisms should be designed in a privacy-preserving manner, minimising the collection and retention of personal data and avoiding the introduction of de facto identity verification for access to online services. The proposal requires age to be verified through certified solutions independent of the platforms, including a free EU age verification app. The proposal requires Member States to offer at least one free way to prove age, including for people without digital ID.
To strengthen the effectiveness of these safeguards, social media services and video-sharing platforms are required to verify users’ ages at the point of account creation.
Parents and guardians will also be given enhanced control tools, including screen-time management, contact supervision and account-setting controls.
The proposal goes beyond the GDPR’s specific rules on children’s consent. Its age assurance and age-appropriate design obligations are not limited to processing based on consent but may also affect services that rely on other legal bases, such as contractual necessity or legitimate interests.
Primary responsibility for supervising the largest services would rest with the European Commission, building on the model established under the DSA. In-scope providers could face substantial penalties for non-compliance, including fines of up to 6% of their worldwide annual turnover and, in the most serious cases, temporary restrictions on the provision of services within the EU.
The proposal also introduces proactive compliance obligations, particularly for VLOPs. The KIDS Act shifts the burden from regulators to providers, requiring VLOPs to proactively demonstrate, through a Commission-facing compliance plan and independent audits at their own expense, that they can meet obligations before their services are made available to children. The KIDS Act also introduces a supervisory fee, capped at 0.03% of a provider’s worldwide annual net income, to fund oversight and enforcement activities. The fee would apply not only to in-scope VLOPs, but also to certain providers of AI companions, general conversational chatbots and video gaming platforms.
Timing
The EU KIDS Act must now pass through the EU legislative process before it can be adopted. Several aspects of the proposal are likely to attract significant debate, particularly the age assurance requirements and the proposed age threshold of 15. While the European Commission has called for the legislation to be prioritised, adoption is unlikely to be immediate. Once adopted, most of the Act’s obligations would begin to apply six months after coming into force, giving providers a relatively short window to implement what are likely to be substantial compliance changes.
What does this mean for organisations?
Although the proposal is primarily aimed at online platforms and digital services used by children, its implications are likely to be far-reaching. Organisations operating consumer-facing digital services will need to assess whether their services fall within the scope of the Act and, if so, whether existing product designs, recommendation systems, engagement features and age assurance mechanisms are compliant.
The proposal also reinforces a growing regulatory expectation that children’s safety should be embedded into product development from the outset. Businesses may therefore need to revisit governance structures, risk assessments, design processes and compliance programmes to ensure that child safety considerations are integrated across the product lifecycle.
Tout le monde connaît Wikipédia. Mais connaissez-vous Wikidata ?
Wikidata fait partie de la longue liste de projets gérés par la Fondation Wikimedia, au même titre que Wikipédia, Wikimedia Commons ou Wiktionnaire. Là où Wikipédia stocke de la connaissance sous forme de texte, donc de donnée non structurée, Wikidata fait exactement l'inverse : il stocke et expose des entités liées entre elles. Cela revient à construire un immense graphe de connaissance, dans lequel chaque personne, organisation, lieu ou concept est relié aux autres par des attributs lisibles par une machine.
Wikidata est une base de connaissance libre, collaborative et multilingue. Chaque entité y porte un identifiant unique : un Q pour les éléments (Q42 pour Douglas Adams, par exemple) et un P pour les propriétés (P50 pour l'auteur, P19 pour le lieu de naissance). En assemblant ces briques, on obtient des affirmations du type sujet, prédicat, objet : ce que le monde de la donnée appelle un triplet RDF.

Le volume donne le vertige. Wikidata dépassait déjà 1,5 milliard de triplets sémantiques à la mi-2024 [1]. Et toute cette donnée n'est pas seulement consultable à la main : elle est interrogeable par requête, via un point d'accès SPARQL public [2]. On peut ainsi demander « tous les écrivains français nés à Nantes » et obtenir une réponse exploitable, là où une recherche classique ne renverrait qu'une liste de pages à lire.
#!/usr/bin/env bash
# Liste les écrivains nés à Nantes via le point d'accès SPARQL de Wikidata.
# Dépendances : curl et jq.

ENDPOINT="https://query.wikidata.org/sparql"

# Q5 = être humain, P106 = occupation, Q36180 = écrivain,
# P19 = lieu de naissance, Q12191 = Nantes.
QUERY='SELECT ?ecrivain ?ecrivainLabel WHERE {
  ?ecrivain wdt:P31 wd:Q5 ;
            wdt:P106 wd:Q36180 ;
            wdt:P19 wd:Q12191 .
  SERVICE wikibase:label { bd:serviceParam wikibase:language "fr,en". }
}
ORDER BY ?ecrivainLabel'

# Wikimedia impose un User-Agent descriptif, sous peine de blocage (HTTP 429).
curl -s -G "$ENDPOINT" \
  --data-urlencode "query=$QUERY" \
  -H "Accept: application/sparql-results+json" \
  -H "User-Agent: Geeek-demo/1.0 (https://www.geeek.org)" \
  | jq -r '.results.bindings[].ecrivainLabel.value'
Sur le fond, Wikidata est une base de données orientée graphe, alimentée par des contributeurs et des imports automatisés. Sa logique n'est pas isolée : elle appartient à la même famille que les données structurées que l'on retrouve aujourd'hui sur une majorité de pages Web, ces blocs JSON-LD qui décrivent un article, une FAQ ou une organisation au format Schema.org.
C'est le même esprit, celui du Linked Open Data : décrire le monde de façon explicite pour que les machines le comprennent sans deviner. Quand vous injectez un JSON-LD sur l'une de vos pages, comme je l'ai détaillé dans mon article sur les microdonnées FAQ en JSON-LD, vous appliquez cette logique à l'échelle d'une page. Wikidata l'applique à l'échelle de la connaissance mondiale.
Pour construire un modèle de langage, il faut de la connaissance, et surtout de la connaissance de haute qualité si l'on veut limiter les hallucinations au moment des requêtes. Or la donnée disponible sur Internet est partout : sites de presse, blogs, forums, dépôts de code comme GitHub pour le monde informatique, et bases ouvertes comme Wikipédia pour la connaissance du monde.
Chaque source possède un niveau de fiabilité différent. Un modèle considérera spontanément une fiche Wikipédia comme plus solide qu'un message de forum. Wikidata pousse ce raisonnement un cran plus loin : la donnée y est non seulement fiable, mais déjà structurée et reliée. Pour un LLM, c'est la différence entre lire un paragraphe et consulter une fiche prête à l'emploi.
Trois usages expliquent cet engouement :
Vous comprenez pourquoi cette base pèse lourd dans une stratégie de Generative Engine Optimization (GEO). Être présent et bien décrit dans Wikidata, c'est exister proprement dans l'écosystème qui nourrit l'IA, et cela d'un seul coup pour de nombreux systèmes à la fois.
C'est là que je m'étais trompé. Je pensais au départ que Wikidata était au moins aussi sélectif que Wikipédia, et qu'une « notoriété publique » était indispensable. En réalité, c'est l'inverse : les critères d'admissibilité de Wikidata sont volontairement plus souples [5].
Un élément est accepté dès lors qu'il remplit au moins un de ces trois critères :
La barre est donc plus proche de « existence vérifiable » que de « célébrité ». Deux nuances méritent toutefois d'être posées clairement. D'abord, le critère 2 reste volontairement flou, au point de faire l'objet de discussions de réforme au sein de la communauté [6]. Ensuite, et c'est le point important, l'auto-promotion est explicitement découragée. Créer soi-même son propre élément relève du conflit d'intérêts [7], et un élément sans la moindre source finit supprimé. L'admissibilité large ne signifie pas absence de garde-fous.
Je ne vais pas vous faire la leçon, car je me suis pris ce mur en pleine figure. J'ai tenté de créer ma propre entité Wikidata, ainsi que celle du blog. Quelques jours plus tard, un administrateur (Madamebiblio) a supprimé les deux fiches indiquant que celles-ci ne répondent pas aux exigences de notabilité [5:1].
Avec le recul, le verdict était écrit d'avance, et il illustre exactement les garde-fous décrits plus haut. En créant moi-même ces éléments, je me plaçais d'emblée en situation de conflit d'intérêts, ce que la communauté décourage explicitement. Et mes fiches manquaient de ce qui fait tenir un élément : non pas mes propres profils ou mon propre site, mais des sources indépendantes et des identifiants d'autorité délivrés par des tiers. Un ORCID que l'on remplit soi-même ne prouve rien aux yeux d'un administrateur. Une notice BnF ou VIAF, générée parce qu'une bibliothèque a catalogué un ouvrage publié, pèse infiniment plus lourd. La leçon est claire : sur Wikidata, on ne décrète pas sa propre notoriété, on la laisse se constater par des traces externes que l'on ne contrôle pas.
Wikidata est sans doute l'un des projets les plus sous-estimés de la galaxie Wikimedia. Invisible pour le grand public, il est pourtant devenu une couche d'infrastructure essentielle : il structure la connaissance, alimente les moteurs de recherche et nourrit les modèles de langage. Pour quiconque travaille la visibilité de ses contenus à l'ère de l'IA, comprendre Wikidata n'est plus une curiosité d'érudit, c'est un sujet de fond.
Ce sujet vous intéresse ? N'hésitez pas à passer sur le serveur Discord Geeek.
Estimation de mi-2024, en croissance constante depuis. Les compteurs à jour (nombre d'éléments et de triplets) figurent sur la page Wikidata:Statistics. ↩︎
Point d'accès SPARQL public de Wikidata : https://query.wikidata.org ↩︎
Google a fermé Freebase, qui alimentait historiquement son Knowledge Graph, et en a migré les données vers Wikidata à partir de 2015. Voir Thomas Pellissier Tanon et al., « From Freebase to Wikidata: The Great Migration », WWW 2016, ainsi que la fiche Freebase : https://en.wikipedia.org/wiki/Freebase_(database) ↩︎
Wikidata est régulièrement citée parmi les bases ouvertes réutilisées pour entraîner ou ancrer les modèles. La composition précise des corpus d'entraînement reste cependant rarement documentée publiquement par les laboratoires. ↩︎
Politique de notoriété de Wikidata : https://www.wikidata.org/wiki/Wikidata:Notability ↩︎ ↩︎
L'interprétation du critère 2 fait l'objet de discussions au sein de la communauté. Voir Wikidata:Requests for comment/Notability policy reform (https://www.wikidata.org/wiki/Wikidata:Requests_for_comment/Notability_policy_reform) et la refonte de 2015, Notability overhaul (https://www.wikidata.org/wiki/Wikidata:Requests_for_comment/Wikidata:Notability_overhaul). ↩︎
La politique précise que créer un élément sur soi-même, ses proches ou son entreprise n'est pas autorisé, afin d'éviter tout conflit d'intérêts. Voir Wikidata:Requests for comment/Conflict of Interest : https://www.wikidata.org/wiki/Wikidata:Requests_for_comment/Conflict_of_Interest ↩︎

L'optimisation des performances web a longtemps reposé sur un rituel immuable : ouvrir les DevTools, enregistrer un profil, décortiquer les "Long Tasks", puis itérer manuellement dans l'éditeur de code. Un nouveau standard change la donne en donnant à l'IA un accès direct au navigateur — et donc à la réalité d'exécution d'un site.
Le Model Context Protocol (MCP) est un standard ouvert, initié par Anthropic, qui permet aux modèles d'IA d'interagir de façon sécurisée avec des outils et des données locales. Là où les agents de codage traditionnels se limitaient à lire des fichiers sources, le MCP leur ouvre l'accès à l'environnement dans lequel ce code s'exécute réellement.
Le serveur MCP Chrome DevTools pousse cette logique dans le navigateur. En exposant les API natives de Chrome à un agent comme Claude, il lui confère une capacité inédite : observer le comportement d'un site en temps réel, et non plus en théorie.
Si jamais vous découvrez ce blog pour la première fois au travers de cet article, je vous détaille dans un précédent article comment développer un serveur MCP si le sujet vous intéresse.
Cette connexion entre l'IA et le navigateur ouvre plusieurs champs d'application concrets.
Audit de performance : L'agent peut déclencher des analyses Lighthouse, inspecter la timeline d'exécution et identifier les goulots d'étranglement sans intervention humaine.
Diagnostic d'accessibilité : Les problèmes de contraste, les attributs ARIA absents ou mal renseignés sont détectés et documentés automatiquement.
Debug visuel : En inspectant le DOM et les styles CSS calculés, l'IA est en mesure de comprendre pourquoi un composant se comporte de façon inattendue à l'affichage.
Boucle d'optimisation fermée : C'est sans doute l'apport le plus structurant : l'agent peut analyser un problème via les DevTools, proposer et appliquer un correctif dans le code source, puis relancer immédiatement un test pour mesurer l'impact réel de sa modification.
L'intégration la plus directe est aujourd'hui disponible via Claude Code, qui propose un plugin dédié sur sa Marketplace.
/plugin marketplace add ChromeDevTools/chrome-devtools-mcp
/plugin install chrome-devtools-mcp
Les commandes d'installation du serveur MCP pour chaque agent AI du marché sont détaillées sur la page Github du projet.
Une fois le serveur actif, l'agent peut prendre le contrôle d'une instance Chrome et répondre à des instructions de haut niveau, du type :
"Analyse la page d'accueil de mon projet local, identifie ce qui cause
un LCP trop élevé et propose les corrections nécessaires dans le code source."
Jusqu'ici, les limites des IA de codage tenaient en grande partie à leur rapport au code : elles le lisaient, sans jamais le voir s'exécuter. Elles ignoraient le poids effectif des ressources après compression, le comportement JavaScript sur un processeur mobile simulé, ou l'impact réel d'un composant tiers sur le rendu.
Avec ce serveur MCP, le cycle de développement gagne en autonomie et en rigueur :
| Étape | Action de l'agent |
|---|---|
| 👁️ Observation | Navigation sur le site, détection d'un problème de performance réel |
| 🧠 Hypothèse | Identification de la cause : script bloquant, ressource non optimisée… |
| 🔧 Correction | Modification du fichier source concerné |
| ✅ Validation | Nouveau test de performance pour mesurer le gain obtenu |

Ce qui nécessitait auparavant plusieurs allers-retours entre le navigateur et l'éditeur peut désormais s'enchaîner de manière autonome. L'agent cumule les rôles d'auditeur, de développeur et de testeur.
Le serveur MCP Chrome DevTools marque une évolution significative dans la façon dont les outils d'IA peuvent s'intégrer au workflow de développement front-end. En connectant l'agent au navigateur, il comble l'écart entre l'analyse du code et l'observation de son comportement réel — un écart que les développeurs expérimentés savent particulièrement coûteux à combler manuellement.
Le projet est open-source et disponible sur GitHub.
Vous avez probablement déjà croisé le terme d’AI-Slop.
Pour ceux du fond qui n’auraient pas suivi, l’AI-Slop (ou « truc dégueulasse d’intelligence artificielle » en langue civilisée) désigne toutes les productions à la valeur artistique nulle générées en masse par l’intelligence artificielle et qui déferlent sur ce bas-monde via les sites webs et autres réseaux sociaux. Généralement, il suffit qu’un margoulin poste une quelconque image (brillante et de bon goût, comme Sonic et Mario enceintes l’un de l’autre, au hasard), pour que dans les commentaires, on se déchaîne : AI-Slop ! C’est honteux ! Et pense à toutes les ressources utilisées pour produire ta merde ! Tiens, tu mériterais qu’on te prive d’eau et qu’on te colle à un radiateur tel un pensionnaire d’EHPAD qui doit faire de la place pour plus riche que lui !
S’il faut saluer la verve de ces braves gens, et prendre bonne note de l’enthousiasme général pour dénoncer l’AI-Slop, permettez à votre serviteur d’aborder un sujet qui, curieusement, déchaîne moins les passions :
Ou « truc dégueulasse d’humain« , ce qui désigne à la fois nos productions artistique de basse qualité, nos excréments, « l’incroyable diversité du cinéma français » (©Camille Cottin) et une plage de Loire-Atlantique après le départ de la population parisienne en septembre. Or, non seulement le Human-Slop semble mystérieusement accepté alors qu’il ne vaut guère mieux que son pendant artificiel, mais plus incroyable encore, des millions, voire des milliards de gens s’y vautrent joyeusement quotidiennement sans ciller dans une orgie de ressources et de moyens à en faire rougir un Donald Trump.
« Je vous vois venir Monsieur Connard ! Plein de mauvaise foi, vous allez comparer la production artistique d’une IA et d’un humain pour défendre le… »
Diego, tiens bien les lèvres de cette personne fermées avec la pince-à-con, veux-tu ?
Et pour répondre : nenni. Car si ma mauvaise foi est proverbiale, elle joue parfois les monte-en-l’air et s’introduit chez autrui avec une habileté qui force le respect. Parfois, on la retrouve même à copuler avec l’hypocrisie, ce qui est tout de même très inconvenant, tant ça reste de la même famille. On n’est pas à Dunkerque ici, ah mais. Toujours est-il qu’il me revient de faire la démonstration de notre problème.
Qu’est-il reproché à l’intelligence artificielle et à sa production ? Eh bien, qu’il s’agit avant tout d’une machine qui va pomper du contenu à droite et à gauche, en fait une grosse soupe, et à la demande d’un vide-gousset de bas-étage, relâche un peu de ladite soupe pour former ce qui est une image mélangeant un peu tout ce qu’elle a piqué et qu’on lui a demandé suite à une idée bien évidemment incroyablement originale (« Fais-moi une image de Sydney Sweeney… nan c’est tout… reeuuh… reeuuuh…« ). On ne peut pas dire que l’art progresse fort, par contre, il y a du monde pour vous rappeler que la consommation en électricité et en refroidissants divers, elle, a gentiment grimpé.

L’Humanité, cette espèce qui a conçu internet, reliant tous les hommes à toutes les bibliothèques du monde, et qui s’en sert pour s’abrutir.
Fort bien, nous avons donc trois problèmes pointés : 1) s’en remettre à la machine, 2) produire du caca, et tout ça avec 3) un certain impact environnemental.
C’est entendu ? Alors prenez du brandy, vous allez en avoir besoin.
Car il existe une machine encore moins créative que l’IA, qui produit du contenu encore plus foireux, et en quantité titanesque. Une machine qui niveau créativité, s’approche de Ramzy Bedia (ce qui n’est pas peu dire). Cette machine, car c’en est bien une, porte un nom : l’algorithme des réseaux sociaux. Un merdou encore plus monstrueux, puisque non seulement ça scanne un peu tout ce qui passe pour faire sa sauce, mais c’est encore plus bête qu’une IA. C’est juste, comme son nom l’indique, un algorithme dont le seul but est de vous coller un peu plus à votre écran pour vous envoyer un peu plus de publicité à la margoulette.
Et là où c’est intéressant, c’est que là où l’IA produit de la merde à la demande des humains… l’algorithme demande aux humains de produire de la merde à sa place. Et le plus beau ? C’est qu’ils le font. Et mieux encore, et c’est là que je remercie mon prochain pour son hypocrisie : on tombe rarement sur les producteurs de daubes 2.0 pour leur expliquer que ce qu’ils font fait perdre du temps et des moyens à tout le monde, eux compris, tout ça pour satisfaire une équation dans un serveur lointain.
Car quiconque utilise internet depuis un moment a pu constater qu’entre la liberté de création et le diktat des algorithmes, on a vite vu qui a plié. Souvenez-nous, vieux lecteurs, c’était avant vos problèmes de dos : cela a commencé doucement, avec les articles de journaux dont, peu à peu, les titres se sont transformés en travailleuses-du-clic, abordant l’internaute innocent d’un « Une célébrité vient d’avoir un terrible accident. Clique pour savoir qui c’est ! « (et en réalité, il s’agissait bien sûr d’un candidat de télé-réalité inconnu de 2009 qui a fait tomber son scooter). Du contenu de basse qualité, qui a rapidement proliféré, occupant des milliers, puis des millions de pages web (on le retrouve même dans les encarts de journaux supposément sérieux), tout ça pour récupérer du clic et de la popularité auprès de l’algorithme. Et puis, voici que le mal a atteint d’autres domaines : Youtube a vu ses miniatures de vidéo se transformer en monstres dégueulasses, avec titres jaunes, flèches rouges, et bien sûr l’énorme et laide face de l’auteur, figée dans une grimace exprimant un sentiment basique, mais mal surjoué (un peu comme Francis Huster sur scène). Je pense, entre deux gorgées de brandy, qu’il n’est pas bien risqué de supposer que tout cela n’avait rien à voir avec l’amour du beau ou de la qualité. Non, le but était de récupérer du clic en racolant le client, car qui dit clic dit vues, qui dit publicités, qui dit pognon… car c’est ce que l’algorithme leur a fixé comme règles : toi vouloir dix centimes ? Toi produire merde-à-clics.
Et cela a donc été fait, sans poser de question.
En ce temps-là, pendant que les gens de goût tentaient de se rincer les yeux à la javel, la pente devenait pourtant toujours plus rude, et au-delà de l’équation basique du « populaire = gros sous », l’algorithme donnait de plus en plus de consignes. Les règles sont devenues plus strictes sur les musiques utilisables ou non, même légalement. Puis, ce furent les mots : l’algorithme sanctionnait certains mots, pas assez populaires ou sympathiques. Et tout le monde s’y est plus ou moins plié : qui n’a jamais croisé une vidéo où les mots « incorrects » sont censurés ? Et par incorrect, ça peut être « mort » ou « violence » qui deviennent « m*rt » ou « V10L3nce », parce que c’est plus difficile de proposer des publicités pour des machines à laver sur ce genre de sujets (ce qui n’empêche pas ces gens de le faire, notez). Vous me direz « Oui enfin les gens emploient quand même ces mots et abordent ces sujets !« . Oui, enfin au début, ils le faisaient à l’oral et à l’écrit. Puis quand l’écrit a été inspecté par le bot de l’algorithme, ils ont bidouillé leurs sous-titres. Puis quand le bot s’est mis à écouter la partie sonore de la vidéo, ils ont censuré le mot. Je vous laisse donc deviner ce qu’il se passera quand le bot sera capable de détecter ces contournements. Et non, ce ne sera probablement pas l’algorithme qui pliera. Si vous en doutez, c’est que vous avez encore un peu trop foi en l’humanité. 20 minutes sur X devraient vous remettre dans le droit chemin de la misanthropie.
« Oui, mais Monsieur Connard, certains créateurs ont, justement, dénoncé ces règles qui apparaissent sans cesse et réduisent toujours la liberté de créer ! » me dira-t-on, m’obligeant à demander à Diego de resserer la pince.
Certes oui. Mais il s’agit hélas d’une minorité, qui en plus, se prend des douilles quand l’algorithme leur dit « Tu ne veux pas te plier aux règles ? Tiens, prends ta sanction« . Pendant qu’à côté, il met en avant toujours plus de merdes, certes, mais qui justement, sont conçues uniquement pour lui plaire et permettre à Mattenzo, 14 ans, de tenter de percer pour devenir « influenceur » en postant des vidéos de lui se filmant chaque jour en train de s’enfiler un paquet de chips différent. Du pur human-slop. Mattenzo comme son contenu, d’ailleurs, mais là n’est pas le sujet.
Le dernier clou – en date – dans le cercueil fut donc TikTok, qui apporta l’idée géniale de carrément orienter le contenu, en annonçant ouvertement quelle musique ou quel « défi » relever pour être mis en avant. Et non, on ne parle pas de Mozart ou de défis mathématiques. On est plus proches de Mariés au Premier Regard que d’un documentaire Arte. De toute façon, le documentaire Arte contient des mots vilains, donc hop : poubelle.
En un mot comme en cent, les algorithmes sont devenus les maîtres de la création de contenu. En élevant toujours plus de murs pour orienter la création vers une seule direction – la mauvaise – avant de carrément encourager la production de coprolithes en .mp4. Tout ça pour vendre des crèmes miracles pour le cul, ou des VPN pour aller en voir.
Le Human-Slop n’excuse donc en rien l’AI-Slop, mais vous noterez, bonnes gens, qu’il est un peu hypocrite de tomber sur l’IA comme la vérole sur le bas clergé, au nom du manque de créativité, du remplacement par la machine, et des ressources consommées, tout en n’ayant pas un mot pour les pelletées de vidéos produites chaque jour à la demande d’un algorithme commercial, qui n’est rien qu’une machine, dans le seul but de vendre des produits plus ou moins utiles, le tout via des vidéos dont le tournage, le stockage et la distribution demandent des ressources qui, bizarrement, ne sont jamais évoquées. D’ailleurs, quand des influenceurs évoquent la consommation des ressources de l’IA, bizarrement, ils comparent toujours ça à un golf, une voiture ou une piscine. Mais jamais à, au hasard, la consommation des serveurs Instagram, TikTok ou Youtube, qui aux dernières nouvelles, ne sont pas refroidis par la Reine des Neiges. Tout ça pour stocker des perles comme « Je réagis à un trailer de Fortnite » ou » Je mange des pâtes dans ma voiture« . Après, je suis taquin : si dans la vie, on faisait toujours le ratio entre les ressources consommées par quelque chose, et le bien que ça fait à l’humanité, le restaurant du Sénat aurait déjà subi le feu nucléaire deux fois.
Dois-je pourtant l’avouer ? Je rêve d’un monde où l’on trouverait, sous ces vidéos, des commentaires dénonçant le « Human-Slop » et évoquant l’énergie nécessaire au stockage de ce vide intellectuel, qui aurait été plus utile à alimenter une chaise électrique pour leurs auteurs. Mieux, si tout le monde dénonçait joyeusement sur le human-slop, les publicitaires voudraient moins y caser leurs produits, l’algorithme s’adapterait donc, et nous entrerions dans un cercle vertueux.
Mais, en lieu et place, le Human-Slop n’a pas de nom, et n’est même pas un sujet. C’est tout au mieux présenté comme une sympathique activité visant à devenir influenceur, c’est-à-dire, homme-sandwich 2.0 au service d’une machine hors de contrôle. Certes, vous ne ferez pas preuve de plus de créativité qu’une calculatrice, mais qu’importe, tant que vous collez à ce que l’algorithme demande et que vous faites vendre des yaourts protéinés ! Ce n’est pas parce que c’est fait par un humain que ce n’est pas un « truc dégueulasse« , que diable : peut-on dire que le contenu de Michou est d’une grande qualité artistique ? Que les vidéos publicitaires d’EnjoyPhoenix font avancer l’humanité ? Ou que les influenceurs qui vendent des arnaques depuis Dubaï marquent le monde culturel par leur génie créatif ?

Redites-moi que le Human-Slop n’existe pas ?
Permettez-moi de jouer les Cassandre (en plus, je la joue super bien), mais j’ose penser que dans un siècle, il y a peu de chances que les musées s’arrachent ces vidéos pour les diffuser au public. Et que ce dernier trouve une once de créativité là-dedans. Tout cela, après avoir lourdement consommé – et poussé à consommer – ira rejoindre les poubelles de l’humanité.
Qu’on ne me fasse pour autant pas dire ce que je n’ai pas dit : il y a plein de choses intéressantes et de créateurs qui se remuent le roudoudou sur internet pour faire des choses bien (j’ai dit qu’ils se remuaient le roudoudou, attention, pas qu’ils le remuaient devant la caméra, ça, ça s’appelle OnlyFans). Mais nous parlons bien dans le présent article de ceux qui créent avec, pour seul objectif, de satisfaire un algorithme qui leur a promis des likes, des abonnés et quelques centimes en échange de leur soumission pleine et entière à ses règles plus ou moins aléatoires.
Puisque nous approchons de la conclusion, je résume donc le problème (avec des majuscules, comme dans les miniatures Youtube) :
Si un HUMAIN demande à une MACHINE de produire du CACA et que ça consomme des RESSOURCES, alors… tout le monde crie que c’est un scandale ! Et que les machines ne doivent pas nous remplacer pour créer, bon dieu !
Par contre, si une MACHINE (l’algorithme) demande à un HUMAIN de produire du CACA et que ça consomme des RESSOURCES, alors… pas un mot, voire, justement, des likes ! Vous voyez bien que ma mauvaise foi sait aller danser le tango chez autrui.
Vous l’aurez donc compris : produire du contenu foireux avec une machine, c’est MAL, par contre, produire du contenu foireux pour satisfaire une machine encore plus bête et en roue libre et son armée de bots faisant la police du contenu… eh bien circulez, il n’y a rien à voir.
Je vous avoue que je suis un peu déçu, puisqu’on m’avait toujours vendu les machines réduisant les humains en esclavage par la force des armes, après une grande révolte. Mais en réalité, l’humanité accepte bien volontiers de faire tout ce que les machines lui disent de faire, et ce, avec un enthousiasme épatant. Si quelqu’un produit une chanson via une machine, et un clip IA, on lui jettera des pierres. Mais si un algorithme lui lance joyeusement : « Hep, utilisateur TikTok : savais-tu que tu pouvais gagner jusqu’à 10 balles en dansant sur la dernière musique de merde, elle-même lourdement vocodée ?« , là, oubliez la résistance aux machines ! Pensez-vous : 10 balles et peut-être même quelques abonnés ! Allez, tant pis pour la créativité et l’amour propre, va pour la censure des thèmes et mots… on fera ce que la machine veut.
Réduits en esclavage par un algorithme de réseau social… je vous avoue que je crois qu’au final, je préférais Skynet qui envoie le feu nucléaire. Au moins, on partait avec panache (de bien des manières).

On pensait que les machines allaient nous asservir avec des terminators, mais non : des likes auront suffi.
Pardon ? Ce blog lui-même consomme des ressources, sans parler des vidéos de votre serviteur. C’est là que… oooh !
Te voilà, mauvaise foi. Tu es rentrée.
Bon retour à la maison.

