❌

Vue lecture

Boostez les performances de votre site avec le serveur MCP Chrome DevTools !

Boostez les performances de votre site avec le serveur MCP Chrome DevTools !

L'optimisation des performances web a longtemps reposé sur un rituel immuable : ouvrir les DevTools, enregistrer un profil, décortiquer les "Long Tasks", puis itérer manuellement dans l'éditeur de code. Un nouveau standard change la donne en donnant à l'IA un accès direct au navigateur — et donc à la réalité d'exécution d'un site.

Le MCP, ou comment l'IA sort de sa bulle

Le Model Context Protocol (MCP) est un standard ouvert, initié par Anthropic, qui permet aux modèles d'IA d'interagir de façon sécurisée avec des outils et des données locales. Là où les agents de codage traditionnels se limitaient à lire des fichiers sources, le MCP leur ouvre l'accès à l'environnement dans lequel ce code s'exécute réellement.

Le serveur MCP Chrome DevTools pousse cette logique dans le navigateur. En exposant les API natives de Chrome à un agent comme Claude, il lui confère une capacité inédite : observer le comportement d'un site en temps réel, et non plus en théorie.

Si jamais vous découvrez ce blog pour la première fois au travers de cet article, je vous détaille dans un précédent article comment développer un serveur MCP si le sujet vous intéresse.

Un spectre de fonctionnalités étendu

Cette connexion entre l'IA et le navigateur ouvre plusieurs champs d'application concrets.

  • Audit de performance : L'agent peut déclencher des analyses Lighthouse, inspecter la timeline d'exécution et identifier les goulots d'étranglement sans intervention humaine.

  • Diagnostic d'accessibilité : Les problèmes de contraste, les attributs ARIA absents ou mal renseignés sont détectés et documentés automatiquement.

  • Debug visuel : En inspectant le DOM et les styles CSS calculés, l'IA est en mesure de comprendre pourquoi un composant se comporte de façon inattendue à l'affichage.

  • Boucle d'optimisation fermée : C'est sans doute l'apport le plus structurant : l'agent peut analyser un problème via les DevTools, proposer et appliquer un correctif dans le code source, puis relancer immédiatement un test pour mesurer l'impact réel de sa modification.

Prise en main : l'exemple de Claude Code

L'intégration la plus directe est aujourd'hui disponible via Claude Code, qui propose un plugin dédié sur sa Marketplace.

/plugin marketplace add ChromeDevTools/chrome-devtools-mcp
/plugin install chrome-devtools-mcp

Les commandes d'installation du serveur MCP pour chaque agent AI du marché sont détaillées sur la page Github du projet.

Une fois le serveur actif, l'agent peut prendre le contrôle d'une instance Chrome et répondre à des instructions de haut niveau, du type :

"Analyse la page d'accueil de mon projet local, identifie ce qui cause
un LCP trop élevé et propose les corrections nécessaires dans le code source."

La fin de l'analyse statique

Jusqu'ici, les limites des IA de codage tenaient en grande partie à leur rapport au code : elles le lisaient, sans jamais le voir s'exécuter. Elles ignoraient le poids effectif des ressources après compression, le comportement JavaScript sur un processeur mobile simulé, ou l'impact réel d'un composant tiers sur le rendu.

Avec ce serveur MCP, le cycle de développement gagne en autonomie et en rigueur :

Étape Action de l'agent
👁️ Observation Navigation sur le site, détection d'un problème de performance réel
🧠 Hypothèse Identification de la cause : script bloquant, ressource non optimisée…
🔧 Correction Modification du fichier source concerné
✅ Validation Nouveau test de performance pour mesurer le gain obtenu

Boostez les performances de votre site avec le serveur MCP Chrome DevTools !

Ce qui nécessitait auparavant plusieurs allers-retours entre le navigateur et l'éditeur peut désormais s'enchaîner de manière autonome. L'agent cumule les rôles d'auditeur, de développeur et de testeur.

En conclusion

Le serveur MCP Chrome DevTools marque une évolution significative dans la façon dont les outils d'IA peuvent s'intégrer au workflow de développement front-end. En connectant l'agent au navigateur, il comble l'écart entre l'analyse du code et l'observation de son comportement réel — un écart que les développeurs expérimentés savent particulièrement coûteux à combler manuellement.

Le projet est open-source et disponible sur GitHub.

  •  

LLMs : entre productivité, management et responsabilité

Il y a quelques mois, j’écrivais sur l’importance de comprendre les Large Language Models (LLMs), ces outils technologiques qui façonnent notre quotidien, qu’on le veuille ou non.

Aujourd’hui, ils continuent de s’imposer comme une brique incontournable, tant dans le monde professionnel que dans la sphère publique.

Pourtant, leur adoption soulève autant d’enthousiasme que de questions. Notamment parce qu’elle engendre des externalités négatives largement anticipées.

Entre la promesse d’une productivité accrue et la réalité de leur fonctionnement, il y a un fossé qu’il est urgent de combler.

La productivité, un leurre bien pratique

On nous vend les LLMs comme des outils miracles, capables de booster notre efficacité, de réduire les coûts et d’automatiser des tâches répétitives. La pression est forte : il faut maîtriser cette technologie, sous peine de se retrouver à la traîne. Pourtant, cette course à la productivité cache une réalité plus complexe.


D’abord, on nous encourage rarement à comprendre ce qui se cache derrière ces modèles. Peu de discussions sur les conditions matérielles de leur production : les matières premières nécessaires à la fabrication des data centers, la consommation colossale d’énergie et d’eau, ou encore la sous-traitance de tâches ingrates à une main-d’œuvre souvent précaire et mal payée. Ces aspects sont relégués au second plan, comme s’ils n’étaient que des détails techniques sans importance.


Ensuite, on insiste peu sur les forces et les faiblesses réelles des LLMs. Leur imprédictabilité en fait des outils difficiles à auditer : la qualité de leurs réponses est rarement contrôlée de manière rigoureuse. On se contente souvent de valider des corpus de réponses ou de s’appuyer sur des retours utilisateurs, sans toujours questionner la pertinence ou la fiabilité des résultats.

Dans les années à venir, je prédis une extension massive des équipes dédiées à l’analyse qualité, notamment pour auditer les interactions et intégrations avec ces modèles. Car oui, un outil puissant mais imprévisible nécessite une supervision largement accrue.

L’apprentissage par l’expérimentation : entre bricolage et improvisation

L’usage des LLMs repose aujourd’hui sur une forme d’apprentissage empirique. Les utilisateurs testent, observent, ajustent leurs prompts, et inventent des modalités d’usage au fil de l’eau. On apprend en faisant, mais aussi en s’inspirant de recommandations dont on ne mesure pas toujours la qualité.

Par exemple, certains recommandent d’utiliser des modèles rédactionnels comme le MCP (Map, Cluster, Package) pour structurer ses prompts. D’autres suggèrent d’intégrer du pseudo-code pour guider le modèle. Mais ces conseils, souvent partagés sans contexte ni validation, peuvent mener à des résultats très variables. Le format « langage naturel » laisse une large place à la subjectivité, et un prompt qui fonctionne pour l’un peut échouer pour l’autre.

Pire, les LLMs ont parfois des comportements inattendus. Ils inventent des sources, omettent de citer leurs références malgré les consignes, ou produisent des réponses qui sortent manifestement du cadre demandé. Ces écarts rappellent une évidence : ces outils ne sont pas infaillibles. Leur utilisation nécessite une vigilance constante, une capacité à questionner leurs outputs, et une remise en cause permanente de leurs limites.

L’orchestration d’agents : quand le management devient algorithmique

Face à la complexité des tâches, une solution émerge : l’orchestration d’agents spécialisés. Chaque agent est conçu pour une mission précise, avec un prompt affiné et des marges d’erreur réduites. Organiser une tâche complexe revient alors à la découper en sous-tâches, à les distribuer aux agents les plus pertinents, et à superviser leur collaboration.

Cette approche rappelle étrangement le management d’équipe, mais sans la dimension humaine. Pas de conflits à gérer, pas de variations de productivité, pas de problèmes personnels. Juste des agents qui exécutent, toujours au même rythme, sans jamais se plaindre. En revanche, ces agents sont plus énergivores, plus faillibles sur certains aspects, et surtout, infiniment moins résilients qu’un être humain.

Ce qui frappe, c’est de voir des managers expliquer avec une précision chirurgicale ce qu’ils attendent d’un agent automatisé, alors qu’ils peinent parfois à le faire avec leurs équipes humaines. Est-ce par manque de transparence ? Par peur des conflits ? Ou simplement par lâcheté, en refusant d’investir dans la formation et l’accompagnement de leurs collaborateurs ?

Un management sans émotion, mais à quel prix ?

On en arrive à une situation paradoxale : on préfère instruire des agents moins expérimentés, moins qualifiés et plus énergivores que des salariés, pour des tâches parfois cruciales. Tout cela parce qu’on refuse de construire avec des humains, d’investir dans leur avenir, de leur faire confiance.

Les LLMs ne sont pas une fin en soi. Ils sont un outil, avec ses forces et ses limites. Les utiliser de manière pertinente, c’est d’abord comprendre leurs rouages, leurs coûts, et leurs impacts. C’est aussi accepter qu’ils ne remplaceront jamais totalement l’intelligence humaine, la créativité, ou la capacité à gérer l’imprévu.

Alors, avant de se précipiter tête baissée dans l’automatisation, posons-nous les bonnes questions : Quelle valeur ajoutée recherchons-nous vraiment ? À quel prix ? Et surtout, quel monde voulons-nous construire avec ces outils ?


Vous êtes abonné·e au flux des articles :

  • de la catégorie : Web
  • rédigés en français.
  •  

My Request to Google on Accessibility

Hey, Alphabet or Google or Chrome or whomever in that illegal monopoly continues to release things to the web platform that are full of accessibility barriers, I have what I think is a straightforward request.

My Request

Please, if your team cannot explain how the thing satisfies all WCAG Success Criteria at Level AA, then don’t release the thing.

If the thing is a new feature for the web platform (HTML, CSS, ARIA, SVG, etc.), then don’t even propose the thing until you have its WCAG conformance sorted.

Then understand WCAG is the bare minimum, is only table stakes, and does not in itself guarantee the thing is accessible. Which means be prepared for the thing to still contain barriers that must be addressed before it goes any further. Which means you’ll field some questions.

Blowback

I’ll run with two examples lead by Google in the web platform standards world, one older and one recent.

1. Toasts

In 2019 I got involved in a Google-lead effort to create a toast element (sorta). I gave ARIA feedback, helped make the GitHub content more accessible, and challenged some assumptions (primarily what they called research). I commented on only three other issues. Those links cover the totality of my involvement.

The toast effort died on the vine, I believe because it wasn’t well-scoped. And I got blamed for it (for being negative, disingenuous) and apparently I also never apologized. I wrote about this experience in more detail at Scraping Burned Toast.

2. Carousels

In late 2024, doing an end-run around the HTML spec and the concept of separation of concerns, Google drove carousels in the CSS Working Group. Then accessibility experts got wind of it and weighed in (more than just the once), only to get no traction.

Instead, Chrome did a dog-n-pony show (with the requisite accessibility lies). Prominent voices promoted it, some wrongly cooed over its accessibility, but only one person took the time to actually try it — and found it wanting. She got sideways criticism for a 6,000-word post and the implication that accessibility experts didn’t do enough. Who could have predicted?

Book-ends

Both of these book-end five years of a consistent experience for me (15 years based on posts linked below). Accessibility experts and disabled users (and the wonderful overlap of both groups) are not consulted at the start. Not in the scoping, not in the research, and not even in traditional shift-left-but-not-left-enough design phase.

Instead, we stumble across these things. We raise alarms or concerns or questions and are seen as buzzkills. Fun police. Hindrance to progress. We flag barriers and are ignored or dismissed or even harassed. And when the project inevitably catches fire, despite claims accessibility is baked in or the assertion it’s only a beta, we are told we didn’t weigh in early enough. We didn’t donate enough time. We didn’t participate in whatever opaque process in our copious free time.

Of course, ableism makes it easy to forget that accessibility experts and disabled users are already under a constant DDoS attack for our attention, never mind dealing with a US federal government that wants us to go away. I know I said I’m good at being a party-pooper, but I don’t want to be. It’s draining. And frankly, Google, it’s your fault (though not yours alone).

A Brief and Select History of WTF

Lucy, labeled “megacorp,” teeing up a football, and shouting at Charlie Brown, who is labeled “accessibility practitioner,” his back turned, arms folded, and grumpy expression.
Image idea courtesy Eric Bailey.

Wrap-up

Do you work for the company that formerly claimed it wouldn’t do evil? It sucks if you take this as a personal attack. It’s not. Your employer is simply doing a terrible job of supporting you in your efforts to support disabled users. If you want to be angry or frustrated, be angry or frustrated at the multi-billion dollar company that keeps throwing up barriers instead of spending a negligible amount of money to get experts and users involved.

It’s a paycheck that puts food on the table. I get that. Take its money and do what you can.

If you work for not-Google, like, say, Apple or Microsoft or Meta or Adobe or whatever, don’t be smug. If I had the energy I could take all of your employers to task for similar, egregious violations of user trust.

I did this rant in only one thousand and seven words!

Related

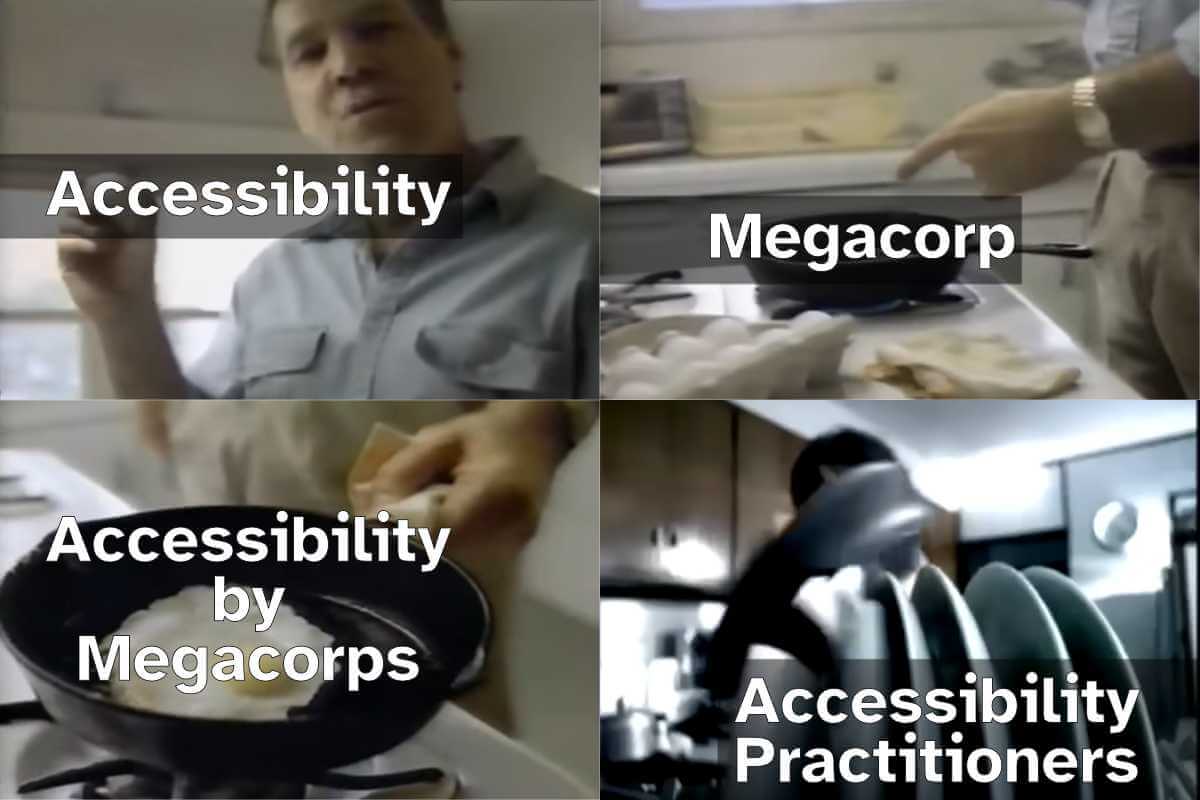
A man holding an egg labeled “accessibility;” pointing at a skillet labeled “megacorps;” the fried egg in the pan labeled “accessibility by megacorps;” a woman swinging the skillet through a rack of dishes where the broken dishes are labeled “accessibility practitioners.”
Stills from the original “This is your brain on drugs” 1980s anti-drug commercial with the final still from the Rachael Leigh Cook version.

More of where I’ve tracked when Google has broken, dismissed, or forgotten accessibility and users.

Update: 28 May 2025

Eric Bailey made a point about conference-driven development, essentially rushing broken or half-baked features out the door so the megacorp would have something to reveal on stage.

I think he was right. On 21 May, CSS carousels featured at Google I/O. The comparison example was Elementor, which ignores the more compelling question (to me) of why Elementor needed 165kb of JavaScript for a carousel. It also ignores the very real risk of WCAG violations and the larger question of why Elementor would make such profound claims when only one browser supports the feature.

Also consider the follow-on comment from the Google presenter, that the CSSWG is already looking ahead to exploring things like bringing your own custom elements for buttons and markers and native cyclical scrolling. The CSSWG may be the vehicle where Google continues to exert its dominance over web standards, separation of concerns and accessibility be damned.

Update: 6 June 2025

David Bushell highlights something with which I agree and which I don’t think gets enough attention — ::pseudo-elements?. He points out it’s a clear violation of separation of concerns (which should sound familiar) and reminds of localization risks (something I would think a Working Group would consider). Google’s rush to market has left many obvious gaps, and I rather hope Google stops doing that seemingly every quarter / conference cycle.

Update: 11 August 2025

I added the Google-lead Open-UI proposal #1193 [menu] Navigation vs menu items use case item above.

Update: 30 September 2025

In The Need for Accessibility Excellence, Devin Prater points out Gemini’s accessibility failures on Android (versus iOS), significant gaps in TalkBack, frustrations with Google Play Books, hassles with Gmail on Android, barriers in gaming on Android, and the seeming abandonment of Accessibility Tags in Google Play.

This isn’t about pointing fingers or assigning blame. It’s about recognizing a pattern of inconsistency and demanding a higher standard. How can we expect small companies or indie developers to make their apps accessible, when we can’t get Google to listen to us and take us seriously?

And that’s the thrust of it. When developers continue to justify their decisions because Google did it, that lowers the experience for everyone.

  •  

Don’t Use Fake Bold or Italic in Social Media

I posted something on Mastodon that uses Unicode math symbols to produce fake bold and fake italic text. I used YayText.com to generate it, but I am not linking it because you I don’t want you to use it.

I embedded the post, but you can go to it directly if you prefer.

Then I recorded the screen reader output.

NVDA 2024.4.2 / Firefox 135. Doesn’t announce the fake bold nor fake italic.
JAWS 2025 / Chrome 133. Announces each fake bold and fake italic letter individually, including its case and style.

Those two videos account for ~78% of primary screen reader use. You could stop there and you’d have a good sense of the divergent experience and how it doesn’t match up with the visible text as you might expect.

This is not new information. I was raising this as a concern back in 2018 when Twitter was not yet a Nazi bar.

I know it’s easy to want to blame screen readers. That reflex, however, is a mistake. Instead, as an author you have some responsibility here.

VoiceOver / macOS 15.3.1 / Safari 18.3. Doesn’t announce the fake bold nor fake italic.
Narrator / Windows 11 24H2 / Edge 133. Doesn’t announce the fake bold nor fake italic.

I’m using default settings. Some users will have different settings, but understand screen reader users have the same range of skill & experience with their kit as everyone else has with their own kit.

Try with your built-in screen reader. You have one built into whatever system you are using to read this post (unless you printed it to dead tree pulp, like a boss). If you are unfamiliar with the commands, such as starting it or navigating, I have some screen reader documentation and resources.

VoiceOver / iPadOS 18.3.1 / Safari. Doesn’t announce the fake bold nor fake italic.
TalkBack 15.2 / Chrome 133. Announces the fake bold and fake italic as if it is regular text. TalkBack started doing this in 2021.

I’ve shared six screen reader experiences.

The takeaway should be do not use sites like YayText to make fake bold or italic text (whether on Bluesky, LinkedIn, that Nazi bar, that other Nazi bar, or the yet other Nazi bar, etc.).

If you’re a tester, you may see the speech logs show the characters. These are lies because that doesn’t mean they are announced.

For comparison, this is what it would look like if it was marked up using HTML (and yes, some Masto instances support this) instead of math symbols:

Please do not eat the shrimp scampi in the fridge. It is tasty but will kill you.

All screen readers announce all those words, even if they don’t all expose the bold or italic styling by default.

Now…

Imagine your local government sends this:

Imagine the impact on screen reader users.

Actually, you don’t have to imagine. I recorded the behavior in 2021. It’s not much different today and the examples above will help you guess even if you don’t read that post or try it yourself.

Update: 9 March 2025

This post landed on Hacker News, with the standard mix of comments from people who read the post, mis-read the post, didn’t read the post, think they know “the fix,” know better, and generally debated the nature of their debates.

  •  
❌