Connexion

Khrys’presso du lundi 15 juin 2026
Comme chaque lundi, un coup d’œil dans le rétroviseur pour découvrir les informations que vous avez peut-être ratées la semaine dernière.
Tous les liens listés ci-dessous sont a priori accessibles librement. Si ce n’est pas le cas, pensez à activer votre bloqueur de javascript favori ou à passer en “mode lecture” (Firefox) ;-)
Brave New World
- Mois des fiertés : partout dans le monde, les droits LGBTQI+ en danger (portail.basta.media)
Au Ghana, aux États-Unis ou en Turquie, les droits des personnes LGBTQI+ sont attaqués. Ces offensives sont d’autant plus visibles en ce mois où les marches des fiertés, ou prides, ont lieu aux quatre coins du monde.
- Sécheresses, inondations, températures record : comment le phénomène El Niño, qui a officiellement commencé, pourrait être le plus intense jamais observé (humanite.fr)
- Retour des fortes chaleurs : l’OMS alerte sur un phénomène, responsable de 200 000 morts en 4 ans en Europe, qui n’a plus rien d’une « anomalie exceptionnelle » (humanite.fr)
Le continent européen se réchauffe bien plus vite que n’importe quel autre, alerte l’OMS. Un phénomène dont les répercussions sont d’ores et déjà visibles, alors que les décès prématurés dus à des vagues de canicules se multiplient en Italie, Espagne ou encore en Grèce.
- À partir de demain, la guerre en Ukraine sera aussi longue que la Première Guerre mondiale (legrandcontinent.eu)
Cela fait 1 566 jours aujourd’hui depuis que l’armée russe à lancée une guerre à grande échelle contre l’Ukraine, en février 2022. Lorsqu’on prend en compte l’annexion de la Crimée en 2014, cela fait 4 492 jours que l’Ukraine subit l’agression russe – deux fois plus que la Seconde Guerre mondiale.
- Un mégaprojet de la famille Trump provoque une « révolution des flamants roses » en Albanie (reporterre.net)
- Biométrie électorale à Madagascar : pourquoi la technologie ne suffit pas à produire la confiance (theconversation.com)
Depuis une vingtaine d’années, de nombreux pays africains ont adopté des technologies biométriques pour enregistrer ou identifier les électeurices, avec la promesse récurrente de réduire certaines fraudes et d’améliorer la qualité des scrutins.
- Ebola : « Les Congolais∙es ont l’impression d’avoir servi de cobayes » (basta.media)
l’est de la RDC constitue un terrain propice à ce type de contagion : la déforestation causée par l’exploitation minière pousse les animaux contaminés vers les villes, tandis que les nombreux conflits armés parquent les réfugiés dans des camps propices à la propagation des virus.
- Pacte sur la migration : quand l’Union européenne trahit ses valeurs fondatrices (courrierdesbalkans.fr)
- Frontex warns EES border queues could persist for another two years (biometricupdate.com)
The EU’s biometric-based Entry-Exit System (EES) may continue to cause long queues at borders for another two years, a Frontex official has said. At the same time, the travel industry warns that queues could divert holidaymakers to other destinations, causing EU countries to potentially lose billions in visitor spending.
- En Italie, la victoire du maire communiste Manuel Minervini relance les espoirs de la gauche face à Giorgia Meloni (humanite.fr)
- Andalousie : une percée de la gauche radicale (contretemps.eu)
Les élections du 17 mai dernier au Parlement d’Andalousie, qui décident de la composition du gouvernement régional, ont constitué une surprise pour certain·es et un choc pour le système des partis andalous, qui pourrait avoir des répercussions possibles à l’échelle de l’État espagnol. Le catalyseur de ce basculement est le résultat obtenu par Adelante Andalucía (AA), une coalition de la gauche radicale
- En Espagne, la régularisation massive dessine un nouvel horizon (frustrationmagazine.fr)
il nous semble essentiel d’affirmer que l’immigration est un fait positif, que nous sommes en capacité d’accueillir plus de monde et que nous devons le faire. Ce qu’il se passe en Espagne actuellement montre que ce projet est possible et qu’il est porté par toute une partie de la société civile.
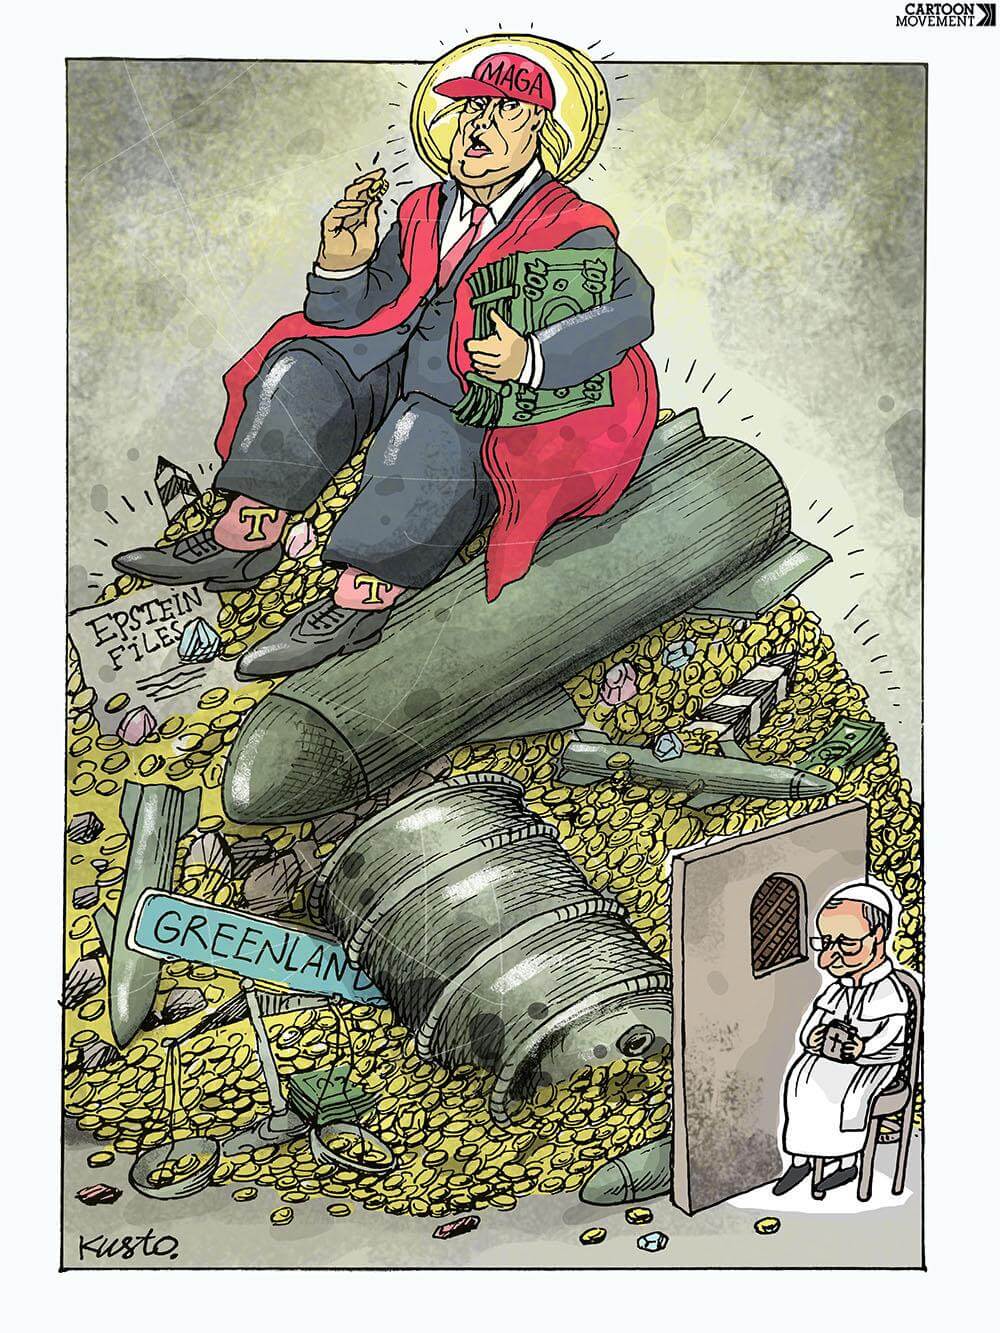
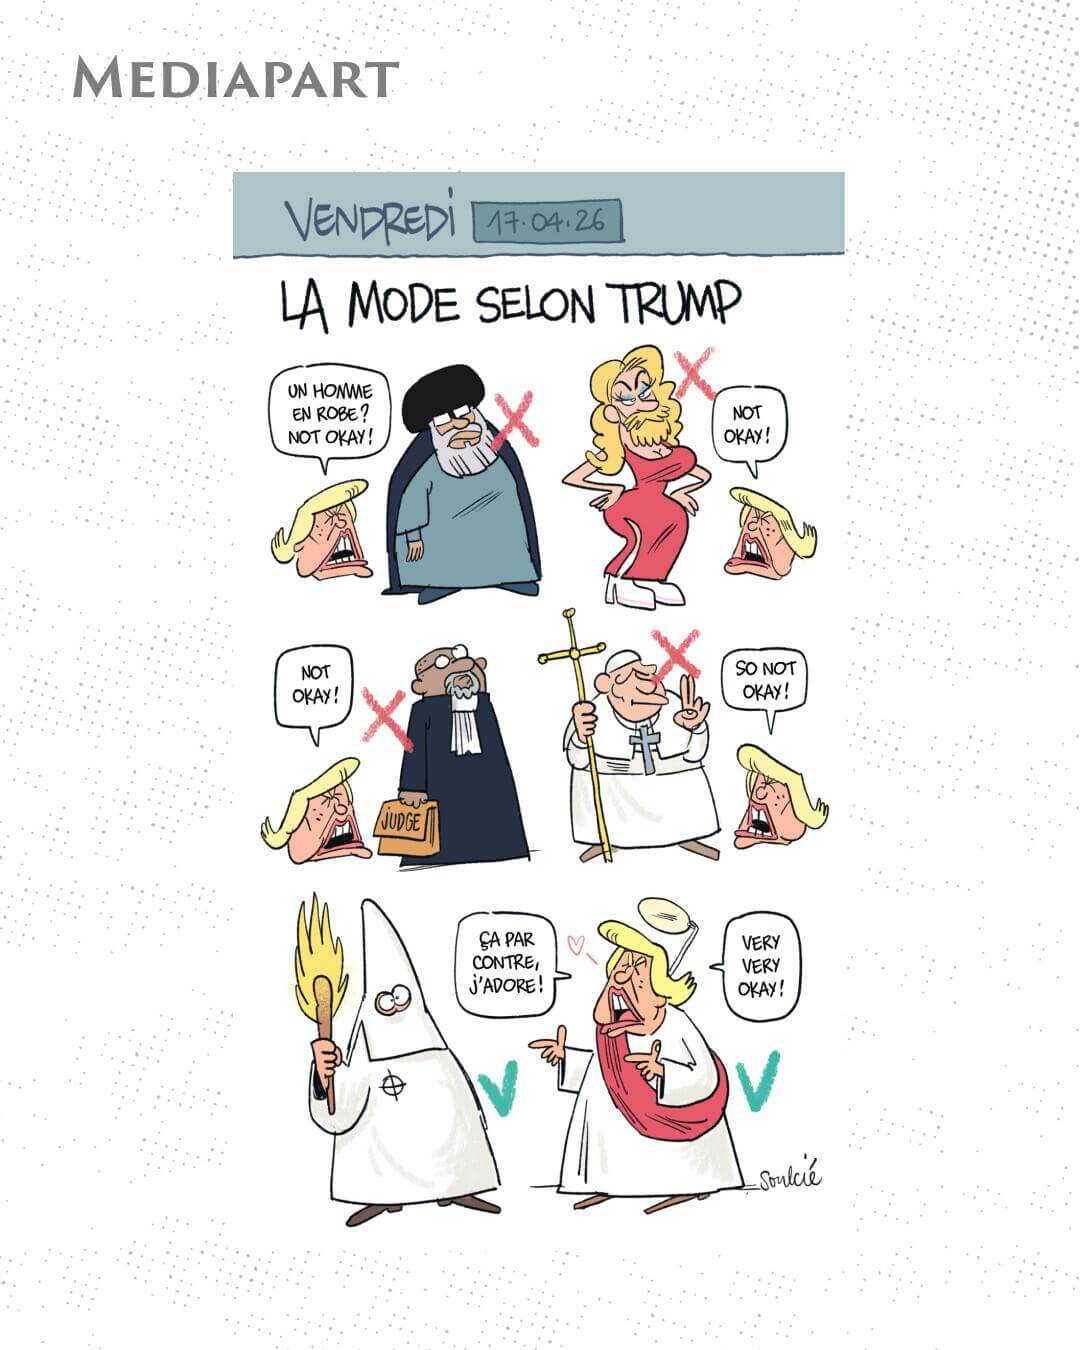
- Le Pape Léon XIV tacle Donald Trump en pleine messe avec un message sur la guerre et les migrant·es (huffingtonpost.fr)
« Nous ne pouvons pas croire en Jésus et promouvoir la guerre », a déclaré le Pape depuis la Sagrada Familia de Barcelone.
- Guerre de l’open source et polémiques, tout ce qu’il faut savoir sur le lancement d’Euro Office par NextCloud (zdnet.fr) – voir aussi An open letter to office suite users, just before the Euro-Office announcement (blog.documentfoundation.org)
In recent days you will have read various articles announcing the arrival of Euro-Office, which is being “marketed” as the first open-source office suite developed in Europe. We feel compelled — reluctantly, since open source should rest on transparency, not deception — to correct this claim. The first open-source office suite developed in Europe was OpenOffice.org in 2001, based on StarOffice’s source code, followed by LibreOffice from 2010.
- EU orders Meta to open WhatsApp to rival AI chatbots (bbc.com)
The EU has told Meta that it must allow AI chatbots operated by rival firms to use WhatsApp for free.
- Facewatch wants to bring live facial recognition to UK pharmacies (biometricupdate.com)
- In Nova Scotia, Mi’kmaq people mark 300 years of treaty — and broken promises (thenarwhal.ca)
- L’industrie aérienne admet qu’elle ne tiendra pas ses objectifs sur la neutralité carbone (reporterre.net)
- La fortune d’Elon Musk franchit le cap des 1 000 milliards de dollars (huffingtonpost.fr)
Ce bond financier en avant est dû à l’introduction en Bourse de SpaceX ce vendredi, qui réalise un départ fracassant.
- Comment l’argent de l’IA et de la crypto influence les élections américaines de mi-mandat ? (synthmedia.fr)
- They Were Serving the Longest Federal Sentence of Any 2020 Black Lives Matter Protester. Then They Vanished in Prison. (theintercept.com)
- Rising anti-LGBTQ+ censorship efforts pull directly from the playbooks of modern authoritarian leaders (advocate.com)
As Congress advances anti-LGBTQ+ legislation and states expand restrictions on queer and trans visibility, PEN America experts warn the tactics increasingly resemble those used by modern authoritarian governments.
- Pokémon Go Scans Quietly Trained the Navigation Tech Now Headed Into Military Drones (dronexl.co)
- Teardown Confirms the Trump Phone Is a Gold-Painted HTC U24 Pro (ifixit.com)
- Mexico : la Coupe du Monde 2026 s’ouvre dans un climat de rejet et de convergence des luttes (dialectik-football.info)
Plusieurs collectifs et assemblées comptent bien perturber l’inauguration de ce “Mondial de la dépossession et de la guerre” et dont 13 matchs se joueront au Mexique. Autour de l’Assemblée “antimundialista”, des collectifs de proches de disparus et de la grève des enseignants, les mots d’ordre convergent comme les cortèges ont prévu de le faire en direction du stade Azteca.
- Coupe du monde « made in Trump » : un fiasco populaire (humanite.fr)
À Los Angeles, capitale états-unienne du “soccer”, les tarifs ont découragé jusqu’aux plus passionnés, tandis qu’une possible intervention de la police de l’immigration effraie les quartiers latinos.
- Au Salvador, le régime de la terreur de Bukele (lagrappe.info)
RIP
- Tributes to Buffy and Ted Lasso star Anthony Head after death aged 72 (bbc.co.uk)
- Mort de David Hockney : cinq tableaux majeurs d’un peintre qui voyait la vie en couleur (franceinfo.fr)
Le peintre anglais était l’un des derniers survivants du pop art. Des toiles les plus intimes aux tableaux les plus militants, retour en images sur les chefs-d’œuvre d’un travailleur acharné.
Spécial IA
- AI Omnibus deal : EU lawmakers should reject a rollback of AI safeguards (edri.org)
- Milei veut faire de l’Argentine le premier pays conçu pour l’IA (legrandcontinent.eu)
Depuis que Peter Thiel, le fondateur de Palantir, a déménagé à Buenos Aires, le président paléolibertarien travaille à faire du pays la capitale mondiale du techno-libertarianisme.
- La ligne rouge est franchie : des drones 100 % autonomes dopés à l’IA ont tué des soldats sans aucune intervention humaine (lesnumeriques.com)
“On les lance et on sait que tout sera mort. Tout ce qui sera trouvé dans cette zone sera mort”, confie le fabricant qui a fourni la technologie.
- From Manhattan to Genesis (cacm.acm.org) The U.S. Department of Energy wants to build a single national platform for doing science with AI.
- Here’s what Jeff Bezos’ new startup Prometheus will do (arstechnica.com)
It isn’t the only startup tackling physical AI, but it’s one of the best-funded.
- Anthropic shuts down Fable, Mythos models following Trump admin directive (arstechnica.com)
The move comes after Anthropic’s receipt of a US Commerce Department directive Friday evening, subjecting the new models to export controls restricting their use anywhere outside the United States.
- “Chat is dead” : OpenAI preps overhaul of ChatGPT (arstechnica.com)
OpenAI is preparing the biggest overhaul of ChatGPT since its launch kicked off the AI boom, as the $850 billion group hunts for new engines of growth ahead of a planned listing this year.The company intends to transform the chatbot into a “superapp” that combines coding tools and AI agents, adding products that executives believe will generate more revenue.
- UK Police Officer Accused of Using AI to Fake Evidence (news.slashdot.org)
- Man sues Florida cops over arrest spurred by “93 % match” in facial recognition (arstechnica.com)
“A facial recognition algorithm flagged Robert Dillon as the man who tried to lure or entice a child under twelve years old at a Jacksonville Beach McDonald’s. It was wrong. Mr. Dillon […] had never set foot in Jacksonville Beach. But rather than test the machine’s answer against the evidence that would have cleared him, the officers built a case to confirm it.”
- AI Agent Bankrupted Their Operator While Trying to Scan DN42 (lantian.pub)
An AI agent tried to join the DN42 hobbyist network to perform a network scan, and bankrupted its operator with a $6531.30 AWS bill, to the extent that they are begging for donations from the DN42 community.
- Visa plugs its payment network into ChatGPT, letting AI agents shop and pay for users (apnews.com)
- Nobody needs AI to search the Internet, court says in ruling against Google (arstechnica.com)
Google AI Overview court loss in Germany could spell doom for AI search industry.
Voir aussi Un tribunal allemand déclare Google responsable des réponses fausses de son AI Overview (next.ink)
- The weather and climate science AI revolution isn’t revolutionary (arstechnica.com)
Forecasts of run-of-the-mill weather conditions have a lot of practical value, but there is life-or-death value in an accurate forecast of extreme weather conditions. The more extreme, the more true that is. But just as a bird-identifying algorithm can’t identify a bird it wasn’t shown during training, AI-based weather models can fail at predicting extreme weather that wasn’t in their training dataset.
- The AI vibe shift is real : Why the backlash is growing (mashable.com)
As ‘tokenmaxxing’ dies out, Silicon Valley is having second thoughts.
- OpenAI Execs Are Panicking (futurism.com)
- AI Economics for Dummies (mcsweeneys.net)
Spécial guerre(s) au Moyen-Orient
- Cheap Iranian drone downed $25 million US Army helicopter (arstechnica.com)
The US military struck Iran again after an Iranian drone’s lucky midair strike.
- Why Did Iran Attack Israel ? What Will Happen Next ? (iranwire.co)
On the evening of June 7, multiple missiles were fired from various parts of Iran toward Israel. Following tensions that had emerged among Tehran, Washington, and Tel Aviv in the days following the April 8 ceasefire, Tehran finally struck parts of northern Israel, including Haifa, in response to the Israeli military’s actions in the Lebanese city of Beirut.
- Van : une ville refuge pour les iraniens (nesalimedia.substack.com)
- Brûlures profondes, lésions respiratoires et oculaires : Israël largue du phosphore blanc sur les civil·es libanais·es (slate.fr)
- ‘Where are the mediators ?’ : Gazans decry ongoing displacement despite ceasefire (972mag.com)
Pushing to seize 70 percent of Gaza’s territory, the Israeli army is opening fire at Palestinian civilians caught off guard by the ever-expanding ‘Yellow Line.’
- Palestinian baby shot dead by Israeli troops in occupied West Bank (theguardian.com)
The seven-month-old, Sam Fahd Abu Haikal, was in his mother’s arms when soldiers fired on family in Hebron
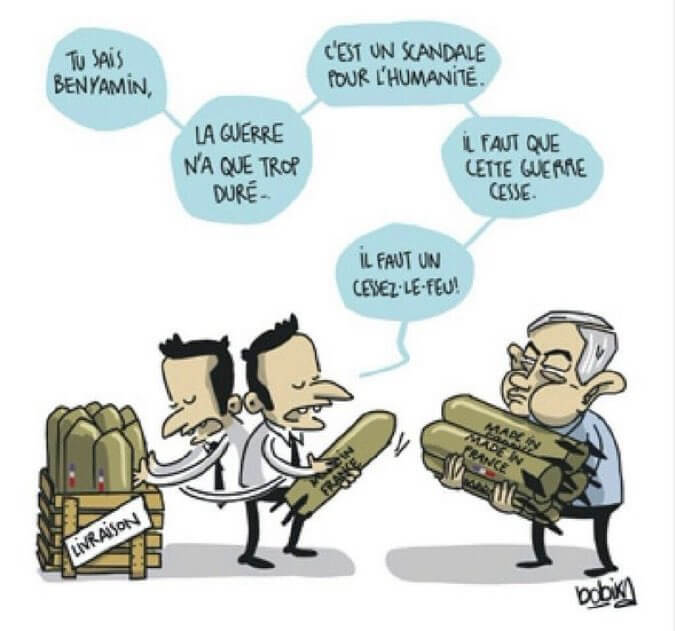
- Israël expulse une journaliste française : une atteinte inadmissible à la liberté de la presse (acrimed.org)
Elle disposait pourtant de tous les documents requis : visa en règle, accréditation presse et contrat officiel avec RFI. Elle couvre le conflit israélo-palestinien depuis six ans, depuis Jérusalem et Ramallah.
Spécial femmes dans le monde
- Marjane Satrapi : celle qui a rendu l’Iran intelligible (theconversation.com)
- Sexisme parlementaire en RDC : pourquoi les femmes élues restent des cibles (theconversation.com)
- Des travaux de recherche récents suggèrent que l’endométriose ne devrait pas être réduite à une affection gynécologique, mais considérée comme une maladie inflammatoire qui touche l’organisme dans son intégralité. (theconversation.com)
Une approche qui pourrait expliquer les limites des traitements actuels et aider à améliorer la manière dont cette pathologie est diagnostiquée, prise en charge et perçue dans la société.
Spécial France
- Nommer le privilège zorèy pour construire l’égalité à La Réunion (parallelesud.com)
- Saint-Denis : le tribunal administratif annule le changement de nom du lycée Angela-Davis imposé par Valérie Pécresse (humanite.fr)
Le 5 juillet 2023, le conseil régional Île-de-France présidé par Valérie Pécresse avait rebaptisé le lycée de Saint-Denis du nom de Rosa-Parks, jugeant la figure de la militante américaine « trop conflictuelle ». Ce 9 juin, le tribunal administratif de Montreuil a annulé cette décision pour vice de procédure.
- « On est chez nous ! » : à Saint-Denis, Mélenchon se positionne comme le seul rempart face au RN (bondyblog.fr)
- Meurtre homophobe de Noahm à Metz : une minute de silence à l’Assemblée (politis.fr)
- Chantage à la sextape : le parquet requiert cinq ans de prison dont trois ferme contre l’ex-maire de Saint-Étienne, Gaël Perdriau (humanite.fr)
- L’empire Stérin scruté par le Sénat (multinationales.org)
- Retour à trois opérateurs : protocole d’accord entre Orange, Free, Bouygues et SFR (next.ink)
- Fuite de données pour Tchap la messagerie instantanée de l’Etat (lemondeinformatique.fr)
Après la revendication d’un cybercriminel sur le piratage de Tchap, la messagerie instantanée de l’Etat, la Dinum et l’Anssi confirment la compromission de l’outil via l’usurpation d’un compte. Une enquête est en cours pour connaître le périmètre de l’incident.
- « Test cédric » : la notification surprise du Crédit Agricole qui a fait paniquer les clients, l’appli tombe en panne (clubic.com)
- Adresse, IBAN, rendez-vous médicaux : un moteur de recherche gratuit dévoile des millions de données confidentielles des Français·es (franceinfo.fr)
- Moteur de recherches de données personnelles : « Le recel de data volées est un crime » (next.ink)
- “Ça va être un carnage en termes de hack” : 10 millions d’entreprises passent à la facturation électronique, une transition à très haut risque (lesnumeriques.com)
- L’université Paris Cité retire son doctorat au physicien Etienne Klein pour plagiat (leparisien.fr)
- Bac 2026 : l’épreuve anticipée de maths, une première controversée (huffingtonpost.fr)
Pour la première fois, tous les élèves de première planchent sur les maths ce vendredi. Pour les syndicats, cette épreuve anticipée a été conçue avant tout pour Parcoursup.
- “C’est dur à trouver et ça ne sert à rien” : son fils meurt en stage de 2nde, un père implore leur suppression (rmc.bfmtv.com)
- La consigne de verre revient en France, mais les magasins ne jouent pas le jeu (reporterre.net)
- Des député·es veulent obliger les distributeurs à reverser aux associations leurs marges sur les dons alimentaires (ici.fr)
Spécial femmes en France
- L’Équipe dédie sa Une aux handballeuses victorieuses et non au vainqueur de Roland-Garros accusé de violences conjugales (lesnouvellesnews.fr)
- « Je ne me sens plus isolée » : sur la presqu’île de Crozon, les femmes se fédèrent contre les violences sexuelles (basta.media)
Sur la presqu’île de Crozon, dans le Finistère, le collectif Skoazell vient en aide aux femmes victimes de violences sexuelles. L’initiative est née du courage d’habitantes qui ont osé parlé. Le réseau apporte une aide logistique et morale.
- L’absence d’action publique alimente le burn-out militant (mouvements.info)
Entretien avec Johanna-Soraya Benamrouche et Laure Salmona, cofondatrices de l’association Féministes contre le cyberharcèlement.
- L’effroyable routine d’un médecin de famille condamné pour agressions sexuelles sur 48 femmes (streetpress.com)
Pendant des années, le docteur nantais Traverson a abusé de son autorité de médecin. Poursuivi pour des palpations des seins non justifiées sur une soixantaine de victimes, dont des mineures, il a été reconnu coupable en décembre 2025. […] L’enquête judiciaire aurait pu commencer plus tôt. En 2021, une première plainte est déjà déposée, pour une jeune fille de 11 ans à l’époque. Dans le cadre d’une hospitalisation psychiatrique, elle révèle que le docteur Traverson lui a touché le pubis. La plainte est toutefois classée sans suite.
- Mort de Lyhanna : l’apparente impunité du suspect provoque un émoi national (portail.basta.media)
Après le meurtre, fin mai, d’une enfant de 11 ans dans le Gers, le casier vierge du principal suspect, malgré des plaintes pour violences sexuelles sur mineure depuis 2017, provoque un débat sur les causes des dysfonctionnements de la justice et de la police dans ce type d’affaires.
- Avant l’affaire Lyhanna, le cas Jérôme Barella avait alerté jusqu’aux États-Unis (huffingtonpost.fr)
un organisme de référence dans la lutte contre la pédocriminalité internationale avait fait remonter en France plusieurs signalements sur Jérôme Barella.
- Gérald Darmanin et l’esthétique virile du pouvoir (politis.fr)
L’affaire Lyhanna met en lumière les limites d’une conception viriliste du pouvoir incarnée par le ministre de la Justice. Quand les violences sexuelles s’imposent au débat public, la posture de l’« homme fort » apparaît moins comme une solution que comme une partie du problème.
Voir aussi Affaire Lyhanna : le pire de la politique (politis.fr)
Face à la tragédie, Gérald Darmanin et Emmanuel Macron se sont empressés d’accabler les magistrats pour mieux échapper à la remise en cause de leur politique.
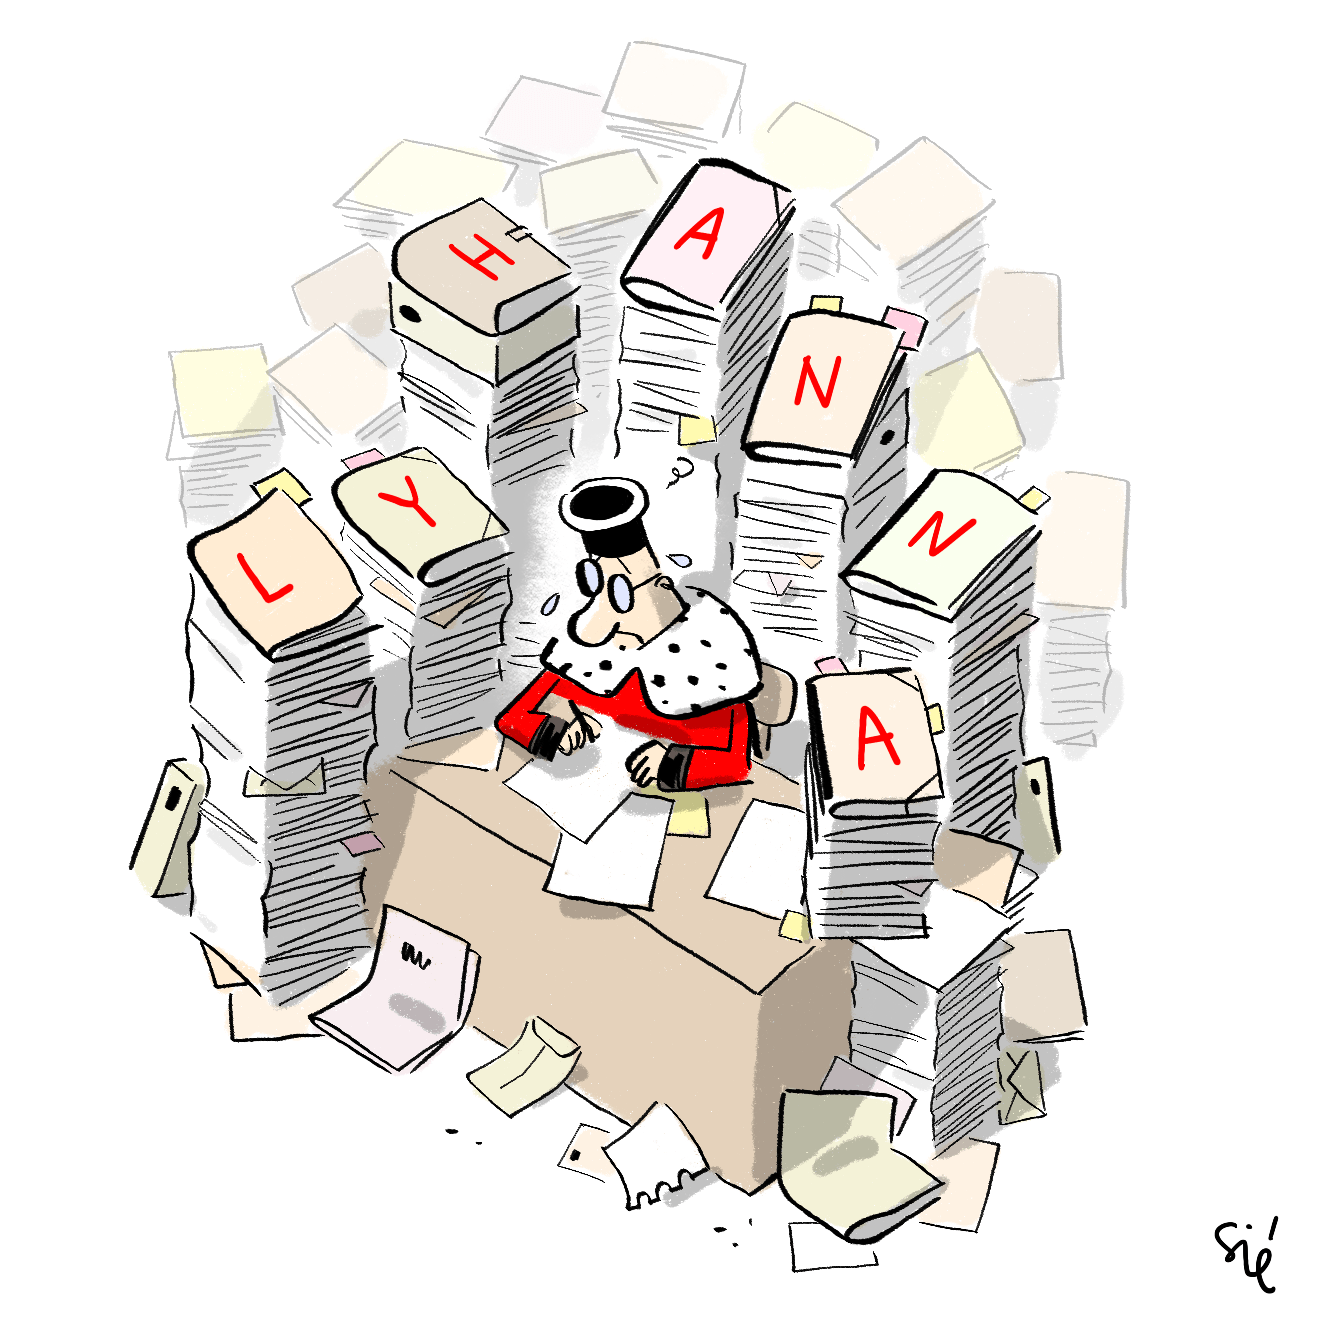
Et Lyhanna : une justice empêchée par les choix de Gérald Darmanin (blast-info.fr) - Affaire Lyhanna : vers un féminisme intégralement sécuritaire ? (problematik-media.com)
- Affaire Lyhanna, périscolaire : « Où sont les hommes lors des mobilisations ? » (huffingtonpost.fr)
- Affaire Patrick Bruel : la garde à vue du chanteur, visé par plusieurs plaintes pour violences sexuelles, prolongée de vingt-quatre heures (lemonde.fr)
- Patrick Bruel va être présenté à des juges, le parquet requiert sa mise en examen pour viols et son incarcération (lemonde.fr)
Le procureur de la République a requis l’ouverture d’une information judiciaire à son encontre et sa mise en examen pour des faits de viols, de tentatives de viols, d’agressions sexuelles et de harcèlement sexuel concernant neuf victimes commis entre 2010 et 2019.
- Patrick Bruel est mis en examen pour viol, tentative de viol, agression sexuelle et harcèlement sexuel, mais échappe à la détention provisoire (humanite.fr)
- Patrick Bruel visé par deux nouvelles plaintes pour des faits de viol, tentative de viol et agressions sexuelles (huffingtonpost.fr)
Ces accusations révélées par « Mediapart » s’ajoutent aux nombreuses autres qui visent le chanteur de 67 ans, déjà mis en examen dans quatre affaires de violences sexuelles.
Spécial médias et pouvoir
- Une multinationale tente d’anéantir La Relève et La Peste (lareleveetlapeste.fr)
Notre média et maison d’édition sont attaqués en justice par une multinationale via une procédure bâillon. Cette multinationale se nomme Pierre Fabre, l’entreprise derrière la polémique A69.
- Nouvelle attaque contre Disclose : le gouvernement réclame la censure de l’enquête « Egypt Papers » (disclose.ngo)
- Finkielkraut en promo : la réaction « chic » et l’entre-soi médiatique (acrimed.org)
Spécial emmerdeurs irresponsables gérant comme des pieds (et à la néolibérale)
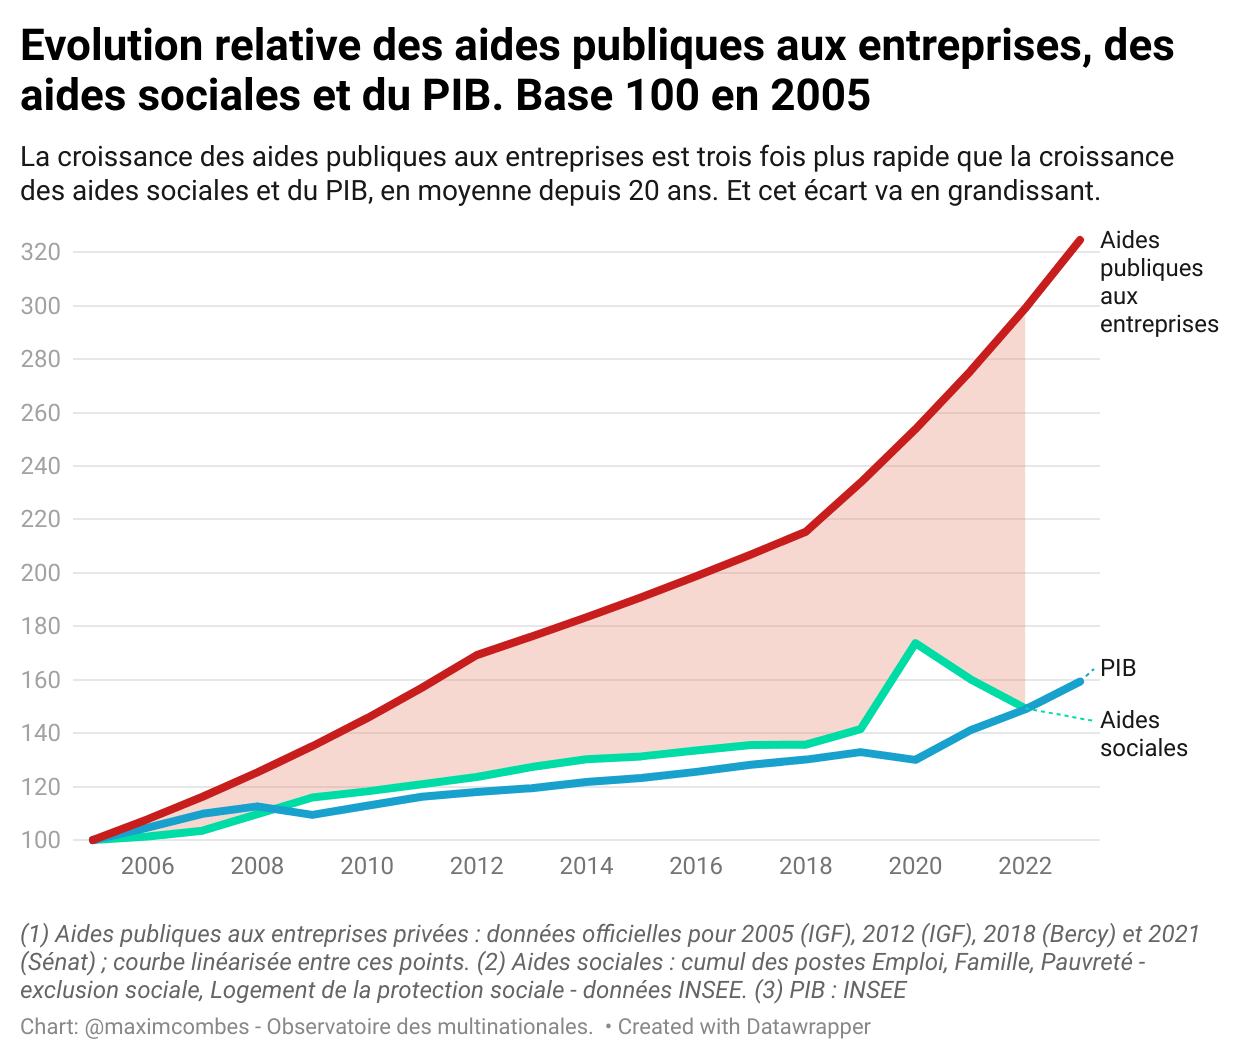
- Les 500 premières fortunes françaises cumulent 1 128 milliards d’euros, une hausse de 564 % en 20 ans (lareleveetlapeste.fr)
- Le monstre utile. Trente ans de surenchère pénale à la française (blogs.mediapart.fr)
Il y a une constante dans la politique pénale française depuis le milieu des années 1990 : chaque décennie produit sa figure de l’ennemi absolu, et chaque loi d’exception laisse des dispositifs qui, une fois installés, ne disparaissent jamais. Prendre la protection des enfants au sérieux, c’est exiger que les budgets publics aillent vers ce qui crée une réduction effective des violences, pas vers ce qui rassure à court terme et laisse les structures intactes.
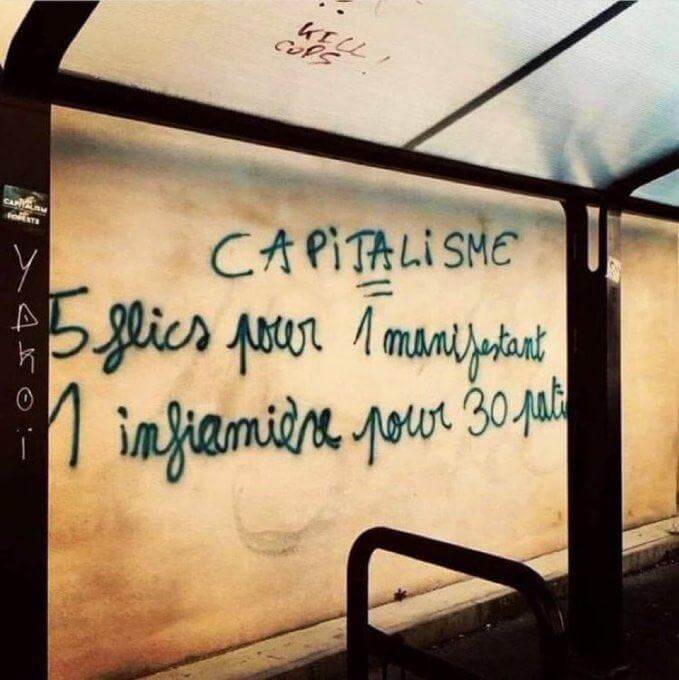
- La semaine noire de Darmanin continue avec un camouflet sur son texte pour la justice criminelle (huffingtonpost.fr)
Après un rejet en commission des Lois à l’Assemblée, le ministre de la Justice a annoncé retirer de son texte le dispositif de « plaider-coupable » très décrié.
Voir aussi PJL SURE : volte-face de Darmanin sur le plaider-coupable criminel (projetarcadie.com)
- « Non, le Conseil d’orientation des retraites ne propose pas la retraite à 67 ans et demi » (basta.media)
À un an de l’élection présidentielle, le rapport du Conseil d’orientation des retraites est plus scruté que jamais. Au risque de faire l’objet d’une récupération pour pousser à un nouveau décalage de l’âge de départ à la retraite à plus de 67 ans.
- Javier Milei invité du Medef : le tapis rouge à l’internationale réactionnaire (humanite.fr)
- Eurosatory : quand la France accueille la vitrine mondiale de l’industrie de l’armement (humanite.fr)
Spécial recul des droits et libertés, violences policières, montée de l’extrême-droite…
- Mort de Lyhanna : la réalisatrice du film Les Chatouilles Andréa Bescond placée en garde à vue à Paris (actu.fr)
« Pensées émues pour tous les pédocriminels qui n’ont jamais passé une nuit en garde à vue », a ironisé Andréa Bescond sur Instagram [qui] avait appelé à se rassembler place Vendôme pour dénoncer les dysfonctionnements de la justice dans les affaires d’agressions sexuelles sur mineur·e après le meurtre de la petite Lyhanna
- « Nous, les Noirs et les Arabes, on vit avec la peur qu’un ‘’basané’’ commette l’irréparable » (humanite.fr)
Le retentissement médiatique d’un crime, quand son auteur est perçu comme issu de l’immigration, suscite chez les Français d’origine étrangère un réflexe silencieux : la crainte que la faute d’un seul rejaillisse sur tous.
- Le maire RN de Carcassonne, Christophe Barthès, refuse de mettre des locaux municipaux à disposition du consulat d’Algérie pour l’organisation des prochaines élections législatives le 2 juillet. (humanite.fr)
« Carcassonne est un laboratoire pour l’extrême droite, pour savoir jusqu’où elle peut détruire les libertés syndicales et d’expression »
- « C’est une chasse à la musulmane » : Inès, menacée de licenciement par une filiale d’EDF (streetpress.com)
- Mort de Nahel : la Cour de cassation rouvre la possibilité d’un procès pour meurtre pour le policier (basta.media)
La Cour de cassation a reconnu l’intention d’homicide du policier qui a tué Nahel Merzouk. Le 27 juin 2023, le jeune de 17 ans, était tué d’une balle tirée à bout portant lors d’un contrôle de son véhicule à Nanterre.
Spécial résistances
- « Personne ne vient travailler pour finir dans un cercueil » : face à la souffrance au travail à la SNCF, les cheminots ripostent par la grève (basta.media)
Face aux restructurations permanentes liées à l’ouverture à la concurrence, et au mal-être au travail qui s’installe, avec treize suicides depuis le début de l’année, la grève à la SNCF du 10 juin a été très suivie.
- À Polytechnique, la remise de diplômes perturbée : « et un, et deux, et trois degrés : pour Patrick Pouyanné ! » (huffingtonpost.fr)
Cette prise de parole est intervenue après l’interruption de la cérémonie par quelques étudiants portant des masques du patron de TotalEnergies, Patrick Pouyanné, et de celui de LVMH, Bernard Arnault, diplômés de l’X, pour dénoncer les partenariats avec les entreprises privées.
- “D’ici la fin d’année, on n’aura plus aucune trésorerie” : les chercheureuses du CNRS de Grenoble mobilisé·es contre les restrictions budgétaires (france3-regions.franceinfo.fr)
Spécial outils de résistance
- Oui, la justice française manque de moyens humains, et 3 autres infographies à ne pas rater (alternatives-economiques.fr)
- Datacenters, eau, électricité, carbone : explorez notre carte mondiale interactive ! (next.ink) – voir aussi Empreinte écologique des datacenters : ce que les géants annoncent, ce que nos calculs révèlent (next.ink)
Spécial MAGAM et cie
- “La direction a perdu toute boussole morale” : le chef de la sécurité d’Android claque la porte de Google (lesnumeriques.com)
René Mayrhofer […] vient de démissionner de Google pour une raison qui vous concerne directement : l’entreprise a signé un accord autorisant le Pentagone à utiliser son IA pour des opérations classifiées, et l’homme qui sécurisait votre smartphone estime que ces outils seront “probablement utilisés contre” les citoyen·nes européen·nes.
- « Amazon déteste mon travail syndical » : comment le géant du numérique tente de réprimer toute action collective de ses employé·es (basta.media)
Alors qu’Amazon a préféré quitter le Québec plutôt que de signer une convention collective, sur les sites français du géant du Web, les syndicalistes dénoncent des sanctions prises à leur encontre et une culture d’entreprise qui entrave leur activité.
- Meta Deletes Face-Recognition System From Its Smart Glasses App After WIRED Report (wired.com)
One day after WIRED revealed that Meta had quietly embedded an unreleased face-recognition system into an app installed on more than 50 million phones, the company removed it
Voir aussi Lunettes Meta : l’intégration de la reconnaissance faciale est discrètement en cours (next.ink)
- Les menaces contre les politiques ont explosé après la limitation de la modération de Meta (next.ink)
- Des outils Microsoft piratés pour voler des identifiants d’outils IA comme Claude Code (next.ink)
- Émeutes xénophobes à Belfast : pourquoi Elon Musk est accusé d’avoir amplifié des discours violents sur X (nouvelobs.com)
Après une attaque au couteau à Belfast, le propriétaire de X avait appelé ses abonnés à protester et reposté des messages de leaders d’extrême droite, amplifiant selon des chercheurs des récits anti-migrants auprès de millions d’utilisateurs.
- Votre voiture vous suit : comment préserver la confidentialité de vos données sur la route (zdnet.fr)
Les véhicules d’aujourd’hui savent où nous habitons, combien nous pesons et ce que nous avons mangé au dîner. Voici ce qu’il advient de toutes ces informations, et comment vous pouvez réduire le flux de données.
Les autres lectures de la semaine
- Colonialité toxique : dans les paysages radioactifs du Sahara (terrestres.org)
De 1960 à 1966, avant et après l’indépendance de l’Algérie, l’État français a expérimenté au Sahara dit algérien dix-sept bombes atomiques et autres essais chimiques. Ce sujet a longtemps été tabou en France, dans la presse, dans les discours politiques aussi bien que dans le cadre académique où enquêtes, témoignages, littérature et recherches sur ce thème ont été invisibilisés.
- Politique de la crise financière : Une fenêtre historique – Défoncer la finance néolibérale : principes et méthodes – Défoncer la finance néolibérale : banques, crédit, dette – Défoncer la finance néolibérale : actions et actionnaires (blog.mondediplo.net)
- Pour faire payer les riches, la taxe Zucman est-elle la meilleure option ? (alternatives-economiques.fr)
- La retraite à 60 ans, c’est (vraiment) possible (lenouveauparadigme.fr)
En agitant le spectre de la faillite de la répartition, les cercles libéraux et le Rassemblement national préparent le terrain pour les fonds de pension privés, au détriment des salariés les plus modestes. Pourtant, des propositions alternatives et réellement sociales existent.
- Capitalism’s Organic Intellectuals (counterpunch.org)
- An electric bike for the mind (ebike.nologos.net)
In a 1990 interview, Steve Jobs famously stated that personal computers were “a bicycle for the mind” […] I sit in front of a Mac all day and that’s not how it feels […] That’s not a bicycle. It’s an SUV for the mind.[…] just about any “obsolete” or “underpowered” laptop can be enough once freed from the burden of always-on connectivity. It’s cheap. It’s available. You probably already have one.
Les BDs/graphiques/photos de la semaine
Les vidéos/podcasts de la semaine
- Don’t be that guy (tube.fdn.fr)
- Comment Bolloré s’est-il imposé dans nos vies ? (humanite.fr)
- Questions morales et enjeux politiques dans les sociétés contemporaines – Didier Fassin : Présences de Foucault : Prison (college-de-france.fr)
Les trucs chouettes de la semaine
- Cultiver sans pesticides, c’est possible : dans la Somme, ces scientifiques sèment des alternatives (vert.eco)
- Humans prefer to walk anticlockwise, scientists find – but reason is unclear (theguardian.com)
Tests reveal that when people are ambling about, they have a natural tendency to turn to the left and walk in an anticlockwise direction.
- The first complex cells had genes from a complex mix of species (arstechnica.com)
We tend to view ourselves and the complex cells that build us as a distinct branch of the tree of life from the compact, seemingly featureless cells of bacteria and archaea. But we’ve found that our genome is actually a hybrid, a mish-mash of genes from bacteria and archaea, along with some that have evolved in our own lineage.
- Threads of underground fungal networks are long enough to reach beyond the Solar System (arstechnica.com)
Hidden underground around the world lie 110 quadrillion kilometers of arbuscular mycorrhizal fungal networks—webs of ultra-thin threads that, if connected in a single line, would stretch almost a billion times the distance between the Earth and the sun
Retrouvez les revues de web précédentes dans la catégorie Libre Veille du Framablog.
Les articles, commentaires et autres images qui composent ces « Khrys’presso » n’engagent que moi (Khrys).




 You can still use APCA (whatever version). If you do, limit your risk by taking one of these approaches: