Une pub honnête pour Palantir, JIM JIM JIM JIM JIM JIM 🎶️, une migration de Framagit à Codeberg, le fonctionnement des sociopathes, et la tentation de séduction universitaire de Jordan Peterson.
kresus : beaucoup de mises à jour cette semaine 🥳️
Nous avons migré notre infrastructure vers Codeberg, et on en parle plus en détail ici. C’est assez impressionnant tout ce que ça implique, ce n’est vraiment pas « juste » un mouvement de code d’un dépôt vers un autre, vu toutes les références externes. Par contre, je croyais que Codeberg, propulsé par le logiciel Forgejo écrit en Go, était méga rapide, mais l’affichage de la page d’issues de Kresus prend au moins 4 secondes, tandis que l’affichage de la page de pull requests en prend 6 ou 7. Il se peut que ce soit juste qu’il y ait beaucoup de trafic sur la base de données de Codeberg, au vu de leur popularité, mais ça me refroidit un petit peu. Il n’est pas inenvisageable qu’on auto-héberge notre propre forge d’ici quelques temps…
cargo-machete : une petite relecture en cours, et je vais sûrement prendre un peu de temps pour faire une passe sur les autres PRs ouvertes, maintenant que j’ai de nouveau envie et le temps d’écrire un peu de code 😊️
auto-hébergement :
J’ai mis en place Sveltia pour l’écriture de mon blog (voir veille tech).
J’ai mis en place un forum de discussion pour notre collectif numérique Le Délire (qui aimerait être un CHATONS mais a un peu la flemme). C’est basé sur Flarum, et ça tourne bien.
Suite à ça, j’en ai profité pour annoncer qu’on fermerait nos instances de Wallabag (remplacé par Readeck, au vu du succès de mes tests personnels de ces dernières semaines) ainsi que Funkwhale (remplacé par… Nextcloud qu’on avait déjà, vu que l’application de lecture musicale marche du tonnerre, avec la possibilité de partager des sons entre potes via des partages de fichier, et d’écouter sur mobile avec l’API Subsonic intégrée).
Jim Queen : qu’est-ce que le “dark woke” ? revient sur le film Jim Queen (attention, quelques mini spoilers), et sa revendication de ne pas faire du militantisme « propre et poli ».
How Sociopaths Actually Work, où une sociopathe docteur en psychologie nous explique ce que c’est, de grandir, de vivre en tant que « sociopathe », un trouble de la personnalité caractérisé par le manque d’émotions sociales apprises (honte, remord, empathie, compassion…). Ça permet de déconstruire le mythe « sociopathe = tueur en série » notamment, parce que comme beaucoup de troubles psychiatriques, c’est beaucoup plus subtil et nuancé que ça, et la plupart des sociopathes (5% estimé de la population, si ce n’est plus) arrivent bien à s’intégrer en société sans se mettre à assassiner tout le monde.
Le dernier épisode de Rhinocéros revient sur la notion de pluralité, et sur l’alliance générale des médias de droite contre… Jean-Luc M., petit candidat de gauche qui monte et qui monte.
Dans une démonstration assez intéressante, Tom Nicholas explique pourquoi l’internationale de la droite mondiale pourrait bien être dans la merde. La raison étant que cette extrême droite dont les scores montent partout n’est pas faite pour diriger, n’est pas habituée à ça, et ne fait que se tirer dans les pattes de partout. Malgré tout, je ne suis pas vraiment rassuré par cette vidéo ; quand l’extrême droite arrive au pouvoir, elle a un pouvoir de nuisance immédiat énorme, donc j’ai du mal à entendre « non mais ces partis puants vont s’empêtrer et disparaître aux prochaines élections » ; c’est probablement un argument de personnes privilégiées qui peuvent tolérer un quinquennat d’extrême droite sans trop d’inquiétude 😟️
The Educational Seduction of Jordan Peterson, une explication très pertinente par Zoe Bee que l’on peut facilement se faire avoir, et avoir l’impression d’apprendre plutôt qu’apprendre pour de vrai, avec pour exemple, « l’université en ligne » de Jordan Peterson (par ailleurs une pourriture masculiniste). Avec des études en psychologie qui vont dans ce sens-là : quand les gens apprennent vraiment, iels galèrent, et ont donc l’impression de moins bien apprendre que dans d’autres situations. Donc regarder une vidéo Youtube, ce n’est pas apprendre — et l’hôte prend le temps de remarquer l’ironie de parler de ça dans une vidéo Youtube.
Je suis allé voir L’Odyssée au cinéma, le dernier film de Christopher Nolan. Comme souvent avec lui, j’ai beaucoup apprécié tout l’aspect esthétique, notamment la photographie. L’histoire me semble avoir dérivé un peu de l’histoire originale (même si je ne prétends pas être un super connaisseur), pour rendre le tout plus grand public, avec une insistance toute particulière sur les combats. J’ai bien aimé certains personnages qui obtiennent aussi des raisons d’être et d’agir bien plus modernes, comme par exemple Circé qui porte un discours qu’on pourrait appeler féministe.
Je suis finalement allé voir Jim Queen, et comme on me l’avait annoncé c’est effectivement super drôle, et bien plus profond que ce à quoi je m’attendais ! Énormément de références pop et queer lors du film, et un fond militant assumé, et malgré tout auto-critique. À aller voir, ou tipiaker, je suis pas la police, vous faites ce que vous voulez.
J’ai décidé d’arrêter de regarder la série Nobody wants this, parce que le dernier épisode que j’ai regardé, Abby Smoothies, est un petit concentré de backlash réactionnaire puant. Merci mais non merci, les scénaristes/producteurs qui font la lèche à Trump et sa clique (une accusation purement sortie de nulle part de ma part, mais disons qu’il y a un contexte à ce genre de retournements de situation).
Toujours en train de lire Saint Luigi, de Nicolas Framont, et j’apprécie vraiment beaucoup son analyse de la violence politique, des différents types de violence, et du fait que la centralisation du syndicalisme et le fait de vouloir rentrer dans les règles du jeu de l’adversaire (aka « être convenable ») dessert les combats militants. J’allais lui reprocher de ne pas sourcer assez ses affirmations, mais il s’avère que toutes les sources sont en fin du bouquin haha.
Project Inbox 2026 où ratfactor parle de sa mission d’aller répondre à toutes ces personnes qui lui ont écrit personnellement un jour et pour qui les réponses traînent. Je regarde mon répertoire email « à répondre » et ces emails vieux de plusieurs années, avec une légère flemme.
Plusieurs lectures intéressantes sur Krabby, un compilateur Rust 🦀️ 😎️ 🚀️ alternatif à rustc, avec quelques explications sur sa raison d’être (un terrain de jeu pour améliorer rustc !) et son architecture :
AI Economics for Dummies est un article satirique qui explique par des métaphores les liens économiques entre les différentes entreprises d’IA. Mouahahaha.
Something seems to be lost on my peers today: it’s still easy to not use AI. The food we eat, clothes we wear, and every electronic device we touch may embody innumerable injuries to the world, and all this is inescapable. Eschewing AI is one thing that we can actually do to live out ethics that affirm values of human and environmental rights. It’s almost a gift! Just use a computer the same way you did three years ago!“
LLM Cliché Highlighter est une petite page Web qui vous permet de détecter les clichés typiques des IAs dans l’écriture (en anglais). This is X, not Y, les fameux tirets quadratins, et autres formes sont bien détectées. Peut être utile pour savoir si un texte est écrit par un LLM.
Honest Government Ad sort une nouvelle vidéo qui parle de l’entreprise tech de surveillence globale Palantir (et ICE, et les techno-fascistes, et du génocide israëlien), et ça fait autant rire que frissonner de peur.
We’ve all heard of the sacred rule in modern web development, the rule never to be broken. The rule of “Never block the main thread.”
You almost can’t miss it as a web developer; it’s in almost every performance guide, and to be fair, it is good advice. We all know the browser’s main thread is single-threaded, meaning it can only do one thing at a time.
Plus, as we know, the main thread isn’t ours alone; we share it with the browser’s rendering engine, input handlers, and other critical tasks. As a result, the less time we hold onto the main thread, the more responsive an app feels. That leads us to share tasks with background workers as we’ve convinced ourselves there should be a hard line between the UI and any computation, and that line shouldn’t be crossed.
And that is what a “recommended” architecture looks like.
But I dare say that sometimes**, moving the data to a worker is slower than just letting the main thread do the work.
I found this out a few months ago while building a Chrome extension with screenshotting features called Fastary. I kept finding a latency of about 2 to 3 seconds in all my testing, even after using an Offscreen Document (a background process in Chrome extensions) to handle the canvas operations. A screenshot task should feel instant without lag, after all.
It is quite ironic that by reflex, we move work away from the main thread to avoid freezing the UI, but sometimes the act of moving that work (e.g., serializing, copying, and deserializing) can also freeze the UI. And sometimes the recommended approach of letting the background do the work can be slower than just doing the work on the main thread.
Let’s talk about that.
The Architecture Of Browser Context Isolation
To put things in perspective, let’s understand why we isolate browser contexts and how they communicate with each other, with emphasis on the communication part.
A browser is more than a single environment. Different environments are running at the same time, each having its own memory space, what it can access, and rules:
The main thread is what we are most familiar with; this is where JavaScript logic runs, where the DOM lives, where styles get rendered, and where users interact.
The Web Workers are separate threads that can also execute JavaScript without DOM access. We mostly use this for heavy data tasks.
The Service Workers are network-related proxies in charge of intercepting network requests and can even run when the page is closed.
And then there are Chrome extension contexts, where we have background service workers, content scripts, and Offscreen Documents (the relevant ones for this article).
Each one of these is isolated from the others. A web worker or background script lives in a different memory space from the main thread. They cannot just reach and read each other’s variables or logic, and this is known as the “shared-nothing” architecture.
How do these isolated environments communicate? They explicitly message each other back and forth using APIs, like postMessage().
The Structured Clone Algorithm
postMessage() tells the browser to take a piece of data and deliver it to the context that requested it. But to do this, the browser relies on the Structured Clone Algorithm (SCA).
You’re probably familiar with JSON.stringify(). SCA is similar, but much stronger and smarter. In its simplest form, SCA is a deep, recursive copy operation, i.e., cloning. It walks through the entire data structure it is given, clones every single value, serializes it into a transportable format, ships those bytes to the target contexts, and then reconstructs the original object on the receiving side.
SCA is fast, or maybe fast-ish... For a small regular config object like {theme: "dark"}, it is imperceptible; you don’t even notice it. The story changes, however, when dealing with heavy data because the SCA is a synchronous blocking O(n) operation, i.e., the cost increases linearly with the size of your data.
Let’s put that into perspective. A user clicks a button, and internally, an 8MB image payload is sent to a background worker for processing. When you call postMessage(), the main thread must immediately stop what it is doing to run this serialization and copying process.
So, if the time it takes to pack, ship, unpack the data, and go back to the start is longer than the time to just process the data on the main thread, why not do that instead?
What About Transferable Objects?
I’m sure some of you are already thinking, “Why not just use Transferable objects?” And that is a valid point. Let’s talk about that.
Developers who really pursue ultra-high-performance web apps usually use Transferable objects (e.g., ArrayBuffer, ImageBitmap, or MessagePort) to bypass the Structured Clone Algorithm. This is because when you transfer an object, you’re not making a copy (like SCM). Instead, the browser switches ownership of the data from one context to another.
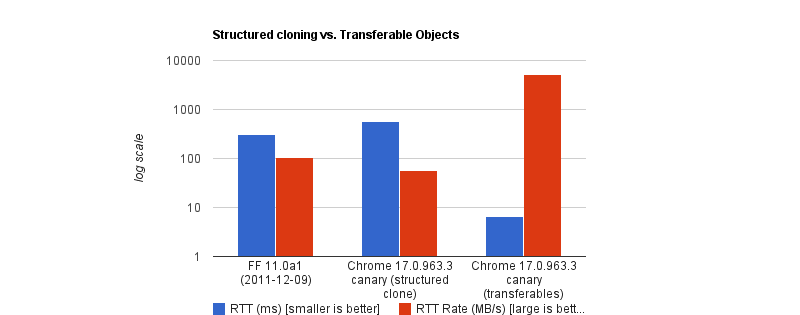
The browser performs a hand-off whereby the sending context loses access to the data instantly, and the receiving context takes full control. It is actually insanely fast. According to Chrome Developers’ benchmark, transferring a massive 32MB ArrayBuffer can take under 7ms, compared to about 300ms when cloning with SCM. That’s a 43x speed boost.
But like all good things, there are downsides. To name a few:
You lose it once you send it. If the UI still needs that data (like to show an image preview), you can’t access it anymore.
Not all data is transferable. A plain JS object is not. A Blob is not. Even a Base64 string is not.
API limitations. In the context of browser extensions, Chrome’s internal messaging (chrome.runtime.sendMessage) traditionally forces everything through JSON serialization.
So, as far as my screenshot extension went, Transferable objects were not an option.
Why We Isolate Contexts Anyway
Why do we even bother isolating contexts at all? Why not just leave it all to the main thread?
Offloading long-running CPU tasks to a background thread is absolutely the right thing to do. The browser needs to paint a new frame every 16.6ms to keep things fluid; that means any task that takes >50ms is generally considered “long”. Offloading to the background is absolutely the right thing to do.
The issue, however, is that we’ve turned this “never block the main thread” into an absolute rule, without asking is this task expensive to process or expensive to move?
I have come to realize now that the rule is less “never block the main thread” than “never block the main thread for too long.”
When The Right Architecture Is The Wrong Architecture
My goal with the Fastary extension was to make it feel like a native app, running as smoothly and instantly as you would expect a native app to.
As you already know, I took the recommended approach to use the Offscreen Document to handle DOM work in the background. But to my surprise, that took a different turn.
The Offscreen Document API is a clear winner. You create a hidden, undisplayed document that runs entirely in the background. It has a DOM and supports Canvas. For example, if I want to crop a screenshot, stitch multiple screenshots together, perform heavy image manipulation, or add a watermark, Offscreen Document was made for that.
Turns out that was not the best approach. This was my architecture:
The background Service Worker captures a screenshot with chrome.tabs.captureVisibleTab(), which returns a Base64-encoded data URL string.
The background Service Worker uses chrome.runtime.sendMessage() to ship this image payload to the Offscreen Document.
The Offscreen Document receives the image, loads it into an <img> element, then draws it onto a canvas before it applies the user’s crop coordinates, encodes the result, and sends the processed image back to the background worker.
But when I tested it, the screenshot didn’t feel instant. As I said earlier, there was a consistent 2–3 second lag.
I figured out that when captureVisibleTab() takes a screenshot, it returns a Base64 URL string, and on a standard 1080p screen, that string could be approximately 1MB or more, depending on how detailed the image is. It gets even more interesting on modern Retina displays (e.g., MacBooks) as they tend to automatically double the image’s size by default.
Keep in mind that since the image payload could be doubled and extension messaging relies on JSON serialization (as of this writing), we potentially deal with massive synchronous communication that costs an entire round trip.
The image string data is JSON-serialized at least twice: once when going into the Offscreen Document and once coming back out with the processed results to the background worker. The actual image processing (cropping) done inside the Offscreen Document was fast, no doubt, but I can’t say the same about the transfer overhead.
The Retina High-DPI Problem
As if the latency itself wasn’t enough, I noticed a rather subtle bug — which, now that I think of it, was more of my ignorance. After a screenshot was taken, the crop result was completely off in a way that either weirdly scaled the image or resulted in incorrect coordinates.
It turns out that when a user selects a region to crop, the content script gets the box coordinates using getBoundingClientRect(), which is measured in CSS pixels; this is what the DOM uses. But when the screenshot is captured natively in Chrome, the browser doesn’t crop it automatically; it instead uses the physical hardware pixels to get the full screen capture. And the browser uses devicePixelRatio (DPR) to know how many physical pixels should represent one CSS pixel. Basically, if a user on a Retinal display (DPR = 2) highlights an area of 400x300 CSS pixels, the actual captured image area is 800x600 physical pixels.
Note: One CSS pixel is equal to 1 physical pixel (DPR of 1) on a standard monitor. On a Mac Retina display or a modern 4K monitor, however, the DPR is usually 2 or 3.
For an accurate crop, I needed to apply these two different measurement systems with the right DPR, i.e., scale the crop coordinates by the DPR. But remember, Offscreen Documents have no physical display. Processing any image would have a default DPR equal to 1. To fix this, I would have to capture the exact devicePixelRatio from the active tab, serialize it, pass it alongside the image payload, and manually do the scaling math inside the Offscreen Document. The complexity starts to compound.
What if I broke the golden rule and did the work on the main thread instead?
Working On The Main Thread
Some developers will argue that UI tasks are the only things that should run on the main thread, but I don’t fully agree with that. Personally, I believe that user explicitly-invoked actions that need immediate results can sometimes get a solid pass to run on the main thread, provided the work is incredibly fast (e.g., 1s).
That’s what I did: scrap out the Offscreen Document and reengineer the logic. Instead of:
…I decided to run the whole image processing in the active tab:
The background Service Worker captures the screen and gets the Base64 string (same as before).
The background sends the payload directly to the content script in the active tab using chrome.scripting.executeScript().
The content script (running on the main thread) receives the payload, draws it to a canvas, performs the crop using the correct DPR value, and copies the result to the clipboard.
// Background Script
const screenshotUrl = await chrome.tabs.captureVisibleTab(undefined, { format: "png" });

// Inject the processing function into the active tab as a content script
await chrome.scripting.executeScript({
  target: { tabId: activeTab.id },
  func: processAndCopyImage,
  args: [{ base64Image: screenshotUrl, cropData: userSelection }]
});
This approach completely clears out multiple context hops and round trips that JSON serialization requires. The only cross-context transfer involves sending the data URL from the background to the content script.
The Retina DPI issue essentially solved itself, as the content script runs directly inside the real, active browser tab because it knows the monitor’s real devicePixelRatio.
But there’s an elephant in the room that you may have noticed.
Sure, the image is now processed on the main thread, and the background manipulates the canvas in the active tab. I could technically be blocking the main thread. That’s where I amended the “no blocking the main thread” rule to “no blocking the main thread for too long.” In this specific case, at least, blocking the main thread for a task the user requests for approximately one second is justifiable. It works conversely as well: maybe don’t isolate processes if the data transfer cost is greater than the processing cost.
Conclusion: When To Isolate And When Not To
I’ve boiled it down to a mental model that depends on whether the task is:
1. Compute-Heavy Tasks (CPU-Bound)
These are tasks where the primary cost is computation and not the size of the data itself. These are tasks where most of the time is spent on doing calculations or heavy transformations, e.g., image compression, audio profiling, physics simulation, etc.
The transfer cost for these tasks is minuscule compared to the actual work.
2. Data-Heavy Tasks (Data-Bound)
These tasks are the exact opposite. These tasks are only expensive because of the size. The processing time is almost insignificant, but the data is expensive to transport, e.g., image cropping, filtering an array, shallow copy, etc.
In my specific case, offloading the task to the background falls mostly into negative-sum efficiency. If we are talking about moving megabytes of data to perform a 50ms operation, there is no benefit to offloading it to the background.
Perhaps we can think of it like this:
Total Time = Serialization Cost
  + Transit
  + Background Processing Time
  + Deserialization Cost
Looking at this, if the “background processing time” is the most dominant task in your operation, then isolation is the clear winner. But if serialization, plus deserialization, plus transit exceeds that cost, then there’s no need to isolate things.
And if you can’t figure out if the task is CPU-heavy or data-heavy, it certainly doesn’t hurt to measure it, for example, using performance.mark() and performance.measure() around postMessage calls to profile the transfer cost.
Pour l’amateur de zoologie, l’approche des élections est toujours un grand moment.
Il suffit d’enfiler ses bottes, sa veste, d’aller chercher ses jumelles et de s’installer au petit jour dans un endroit où l’on a une vue dégagée sur un plateau télé, et, oh ! Regardez, les voici ! Les candidats ! Ces êtres mystérieux qui se multiplient plus vite que des lapins sitôt que quelqu’un prononce le mot « urne » (ce qui pose souvent des soucis dans les crématoriums, mais c’est un autre sujet). D’où viennent-ils ? Qui sont-ils ? Pourquoi a-t-on le droit de chasser le sanglier parce qu’il piétine nos champs, mais pas le candidat alors qu’il piétine nos neurones ?
Penchons-nous donc sur cet être mystérieux.
Le candidat
L’objectif du candidat est cette jolie maison, qui permet de frimer devant les copains.
Le candidat est une espèce de primate qui, bien que similaire à l’homo sapiens en apparence, en est avant tout le parasite. L’espèce est répartie de manière assez uniforme dans le monde, et on la retrouve en général rôdant à proximité des micros et autres caméras pour raconter peu ou prou n’importe quoi. Raison pour laquelle les zoologistes amateurs confondent souvent le candidat avec le journaliste. La différence est pourtant facile : le journaliste pose les questions, le candidat n’y répond pas (mais nous y reviendrons).
Dénomination
Un candidat est appelé candidat ou candidate. Si l’on trouve plusieurs candidats au même endroit, on parle alors de débat. Si l’ensemble des présents dans la pièce sont candidats, sans exception, on parle alors de parti de gauche. Si ladite pièce est une prison, on parle alors de parti de droite. Si tous les candidats ont mystérieusement disparu et qu’il n’en reste qu’un dans la pièce qui vous assure qu’il ne sait pas ce qui est arrivé aux autres, on parle de Jean-Luc Mélenchon. Enfin, si le candidat vous assure que la démocratie c’est super, mais appelle le candidat précédent « papa« , on parle de Marine Le Pen.
Histoire
L’histoire des hommes est riche en expériences démocratiques. La plupart des historiens s’accordent pourtant à dire que les grandes bases de la démocratie furent posées à Athènes, autour du Vème siècle avant Djizousse. On y retrouve par exemple la Boulè, assemblée de citoyens tirés au sort qui viennent voter les lois. Et comme ce faisant, ils ne pouvaient pas être à la fois présents aux débats et au travail, il fut décidé de les rémunérer. De nos jours encore, lorsque l’on parle d’un membre de l’assemblée payé pour y être et qu’on ne voit pas beaucoup au travail, le terme Boulè revient souvent.
C’est à peu près à cette époque qu’apparait le candidat, en même temps que les premiers postes à pourvoir en tant qu’élu. Certes, on n’a alors inventé ni le micro, ni la caméra, et le candidat se contente donc de parler très fort en place publique pour expliquer qu’avec lui attention, ça va changer, si vous m’élisez, vous allez voir, le merdier actuel va se transformer en véritable utopie, promis juré. À noter que puisque nous attendons toujours ladite utopie, on en conclura que cela fait pas moins de 2 500 ans que les candidats pipeautent. Une constante impressionnante, certes, mais pas aussi épatante que la crédulité de mon prochain qui se dit que cette fois, c’est la bonne.
À noter que dès le début, les Grecs eurent une illumination : si on limitait par exemple la participation à la Boulè à deux mandats ? Une grande idée, que les candidats, sitôt élus, ont rapidement attaquée au fil du temps. Raison pour laquelle, de nos jours, le candidat moyen a souvent derrière lui 30 ans de mandats divers et variés, et pour seule expérience professionnelle un stage de troisième en 1998, mais si, si, c’était ‘achement dur, je sais ce que c’est que le travail, je vous jure. Tenez : pas plus tard qu’hier, j’en parlais encore à mon chauffeur.
À noter que le candidat n’a pas la même notion de l’histoire que nous : par exemple, il n’est souvent même pas au courant de la sienne. Si vous en doutez, je vous propose l’expérience suivante : mettez un candidat en présence d’un juge. Vous verrez : soudainement, le candidat ne se souvient plus de rien, et n’a aucune idée de qui est ce Monsieur sur la photo avec lui. Comment ? On l’y voit pourtant qui se baigne dans la piscine dudit Monsieur, avec lui, un cocktail à la main ? Non, aucun souvenir. Un marchand d’armes vous dites ? Ah ! Si j’avais su Monsieur le juge…
Mais nous parlerons des juges plus loin, lorsque nous évoquerons les prédateurs du candidat.
Comportement
Le candidat a un comportement qui varie de l’amical (en période pré-électorale) à l’hostile (le lendemain de l’élection). Tel l’oiseau des îles, lorsque vient la saison des urnes, on le voit se promener sur les marchés, distribuant des tracts comme autant de plumes chamarrées. Alors certes, qui se fait encore un avis politique en lisant un tract récupéré entre deux pomme de terres sur un marché en 2026 ? Personne, mais le candidat a ses traditions, et le tractage fait partie de sa parade amoureuse pour tenter de séduire l’électeur.
Au lendemain de l’élection, lorsque l’électeur demande pourquoi on n’applique pas ce qui était écrit sur le tract, le candidat se met alors à froncer les sourcils très fort pour expliquer qu’en fait, c’est pas si simple, il voudrait bien, mais vous voyez, en peu de mots : non. Ahlala, c’est pas de chance ! Bon par contre je vais quand même rester en poste, hein.
La perception du temps n’est pas la même chez le candidat que chez vous et moi. Pour le candidat, il n’existe que deux repères temporels :
L’élection précédente
L’élection suivante
Tel le serpent, à chaque élection, le candidat fait sa mue et laisse derrière lui son image et ses promesses de la dernière échéance, et se présente comme un candidat nouveau. Oui, même s’il était ministre trois mois avant et qu’on lui demande pourquoi il n’a pas appliqué toutes ses promesses quand il le pouvait. On en revient alors au point précédent : froncement de sourcils, c’est pas si simple, il voulait bien, mais vraiment, pas de chance !
De manière générale, le candidat est le second appeau à claques le plus connu de la planète, juste après l’enfant de film américain avec une coupe à la con.
Ici, un exemple de la rencontre entre les deux éléments précédemment cités. On parle de « Cumul des mandales ».
Démographie
Le candidat est, avec la punaise de lit, l’un des parasites les plus communs que l’on retrouve à Paris. Il dispose de la même capacité à se démultiplier alors qu’on souhaiterait l’exact contraire, et contrairement à la puce, et pour des raisons mystérieuses, il est interdit de l’asperger de Baygon. Pire, alors que la puce peut être évacuée en envoyant le matelas contaminé loin de chez soi, le candidat, lui, revient toujours. Même si vous l’expédiez hors de vos frontières en lui expliquant que vraiment, ça va pas être possible, il revient : c’est ce qu’on appelle faire une Manuel Valls.
De manière intéressante, le candidat déteste voir un nombre de candidats supérieur à 1. Il appelle régulièrement tous les autres candidats à se « rassembler », ce qui signifie foutre le camp manu militari pour se ranger derrière lui et fermer sa gueule. Ce qui confirme une chose : le candidat est un être tellement méprisable qu’il méprise lui-même les candidats. CQFD.
Alimentation
Le candidat est omnivore. Il mange de tout, et bien souvent, à tous les râteliers. Sous ses apparences de tribun, le candidat reste cependant un être profondément timide, voire carrément cachotier, qui sait se montrer très discret sur les notes de frais de ses repas.
Cri
Si l’alouette grisolle et la grive babille, le candidat, lui, discoure. Son cri – le discours, donc – a une durée allant de 30mn à 2 heures, et consiste à se poser devant un micro pour étaler, devant un public de gens d’accord avec lui, à quel point il est d’accord avec eux. La longueur du propos est l’une des caractéristiques typiques du candidat. Ainsi, si vous posez une question fermée à un enfant de 5 ans, il arrivera à répondre par oui ou par non. Pas le candidat, qui qu’importe le sujet, se sent dans l’obligation de broder longuement pour mieux montrer qu’il est la caricature qu’il assure ne pas être. Le tout en répétant les prénoms et nom complet de la personne avec qui il parle pour rallonger la sauce.
Si vous appliquez la logique d’un candidat à n’importe quelle situation de la vie, on comprend mieux à quel point l’interdiction d’un permis de chasse pour ces bestioles est criminelle. Par exemple :
« Dis candidat, tu peux me passer le sel ? – Ecoutez, Jean-Jacques Pipounet, avant de vous répondre, je tiens à rappeler aux gens qui nous écoutent que c’est un sujet qui me tient particulièrement à cœur. En effet, comme tout un chacun, j’ai lu beaucoup d’ouvrages sur le sel, et j’ai été particulièrement touché par les conditions de travail des employés des mines de sel. Saviez-vous par exemple… – Non mais candidat : je veux juste le sel. Tu me le passes oui ou non ? – Un instant, Jean-Jacques Pipounet. C’est une question complexe, et je vais y répondre, mais je tiens à vous dire deux choses. D’abord – et je pense que les Françaises et Français qui nous écoutent en sont conscients… – Mais bordel candidat on est SEULS à une FUCKING TABLE d’aire d’autoroute ! – Mais, Jean-Jacques Pipounet, je vois que mon propos vous dérange, n’est-ce pas ? Eh bien oui. Car je n’ai pas peur d’être politiquement incorrect. Je me suis déjà positionné, vous le savez, sur des sujets courageux comme « la guerre, c’est mal » ou « la pauvreté, c’est pas gentil », et je continuerai à… »
Le procès de M. Pipounet, pour strangulation et introduction d’une salière dans un rectum, est toujours en cours, raison pour laquelle je ne commenterai pas plus cet échange.
Depuis quelques années, en France, le candidat a aussi un cri curieux : « L’extrême-droite« . Il en parle le matin pour dire qu’il est contre, le midi pour dire qu’il est le meilleur pour la vaincre, et le soir pour expliquer que jamais il ne s’alliera avec. Pour une raison mystérieuse, depuis plus de 20 ans, absolument tous les candidats de tous les partis se sentent obligés d’en parler, laissant chez l’électeur assoupi une impression de « Vous avez le choix entre n’importe quel parti OU l’extrême-droite« . Curieusement, après deux décennies de ce régime, l’extrême-droite se rapproche de plus en plus des 50% voire les dépasse dans certains coins, mais ça n’alerte pas les candidats. Ah, si le candidat trouvait qui est le con qui fait la pub de l’extrême-droite matin midi et soir, et transforme tout en choix binaire !
À noter que le candidat d’extrême-droite, lui, a tendance a faire du rien et à attendre. Tant qu’il ne dit rien, il a moins de chances de dire une connerie : c’est ce que l’on appelle « La méthode Chirac « . Les plus anciens savent.
La méthode Chirac se définit comme suit : « Ne rien dire, ne rien faire, laisser les autres parler de vous. Comme ça, vous ne dites pas de conneries, eux, si, et en plus comme on parle de vous toute la journée, vous avez juste à regarder votre score monter ».
Instinct
Contrairement à une rumeur bien établie qui voudrait que le candidat soit totalement dénué d’instinct de survie, au point de se présenter à des élections où tout le monde sait qu’il peinera à faire 0,3%, il s’agit là d’une méthode, bien au contraire, qui vise à assurer la continuité de sa misérable existence. En effet, le candidat étant un parasite (cf plus haut), il ne peut s’empêcher de pourrir les autres candidats. L’objectif étant de faire un score absolument nullissime, certes, mais qui pourrait faire la différence au second tour d’une élection. Frottant ses mains tordues par des années de complots et de trahisons, le candidat roule alors sa bosse jusqu’à l’antre du Gros Candidat (celui au second tour) et lui offre son ralliement en échange de, disons, un p’tit ministère ? Hmm ?
Sitôt en poste, le petit candidat se mettra alors à pomper tout ce qu’il peut pour grossir, espérant, un jour, devenir un gros candidat, qui sera à son tour parasité par plus petit que lui.
Et comme en plus tout cela lui permet de passer à la télé, vous pensez bien qu’il ne se prive pas.
Dégénérescence de l’espèce
C’est à ce stade de notre récit que les plus observateurs d’entre vous poseront cette question :
« Certes, Monsieur Connard, mais pour une espèce envahissante que vous semblez présenter comme rusée, pourquoi diable a-t-on l’impression que la plupart des candidats sont cons comme des branches de houx ? »
Une observation bien légitime, même s’il faut toujours préférer la branche de houx au candidat : en effet, un seul des deux peut être pendu à Noël dans une ambiance festive. Pour autant, concentrons-nous sur la réponse : cela a trait à l’instinct du candidat que nous venons d’évoquer. Le candidat sait qu’il est d’une espèce vile et pernicieuse, et que ses semblables n’attendent qu’une occasion pour le parasiter. Aussi, de manière générale, le candidat s’entoure toujours de gens qu’il estime plus cons que lui. En effet, s’ils sont moins malins, ils ne pourront pas la lui faire à l’envers et le trahir dans les grandes largeurs. En plus, un con, c’est toujours utile : mettons que vous soyez maire et que vous parveniez à décrocher un plus gros mandat. Allez-vous vraiment abandonner votre premier poste ? Nenni ! Vous y mettrez quelqu’un d’un peu plus con que vous, mais avant tout fidèle, afin de le dégager si les choses tournent mal et que vous devez vous replier.
Là où dans la nature, la loi est souvent celle du plus fort ou du plus adapté, le monde politique répond bien souvent à la loi du plus con. Et diable, certains sont incroyablement fidèles à la règle.
Si vous en doutez, il vous suffit d’observer les baronnies du royaume de France, où tel ou tel parti est si bien installé qu’on hérite des postes de génération en génération. Vous verrez qu’en général, tout a commencé par un type intelligent, qui à son départ, a nommé son fidèle lieutenant un peu moins malin, qui lui-même, a nommé son fidèle sergent qui n’était pas bien fin, qui lui-même.. bref. Quelques décennies de ce régime, et dans certains coins, le candidat est plus proche du teckel que de l’homo sapiens.
Si vous voulez une preuve que le candidat est par nature incroyablement con tant l’espèce va mal, je vous rappelle qu’à chaque élection, on pose les deux mêmes questions au candidat :
Quel est le prix d’un ticket de métro ?
Quel est le prix d’un pain au chocolat ?
Et à chaque élection, alors que les ces questions sont attendues, ils ne sont pas foutus de répondre, alors que vous, si. Et vous, vous n’avez pas en plus une armée de conseillers pour vous faire vos fiches. À ce stade, je crois que même le teckel s’en tire un peu mieux finalement.
Heureusement, il reste des prédateurs pour s’occuper de ces créatures du démon.
Prédateurs
On note deux grands prédateurs naturels au candidat : le journaliste et le juge.
Le journaliste
Longtemps, le journaliste a été le principal prédateur de l’homme politique, n’hésitant pas à placarder en Une des scandales aptes à ruiner une carrière entière. Hélas, tout comme le chat domestique n’en a plus rien à branler des souris depuis qu’on lui donne du Whiskas tasty mix, le journaliste a perdu ses instincts de prédateur le jour où on lui a donné internet. Car voilà : il a découvert que ce qui faisait le buzz, et donc vendre sa soupe, c’était plus la dernière petite phrase de l’idiot du village que l’analyse géopolitique brillante de 2 heures d’un génie du droit international. Aussi, lorsque le journaliste a le choix entre faire un long travail d’investigation et de préparation pour tenter de cuisiner un homme politique, ou tendre un micro à Sandrine Rousseau, il a choisi.
La grande dégringolade du journalisme est visible en France tous les 5 ans, au moment du débat de l’entre-deux tours, puisque l’on peut y observer des journalistes sur un plateau en présence de deux candidats à l’élection présidentielle et… ils ne font rien. Non, ils ne vérifieront aucune information. Oui, vous pouvez les remplacer par votre nièce de 8 ans qui se contente de dire « Sujet suivant, la parole est à vous », et c’est la même. Quand on peut se faire remplacer par une IA, c’est déjà sale. Mais quand un enfant de 8 ans peut faire votre boulot sans formation, il faut vraiment s’inquiéter.
Attention cependant : il reste tout de même des journalistes qui enquêtent, même si l’espèce est en danger. Ce sont eux qui, en général, finissent par attirer l’autre prédateur…
Le juge
Le juge est un être au goût vestimentaire douteux, et aux calembours qui le sont plus encore : on peut l’apercevoir gloussant en marmonnant « Vous devriez devenir avocat« , ce qui dans sa langue, signifie d’aller vous faire Maître. Ses meilleures blagues provenant en effet du Dalloz, son humour n’est pas des plus populaires, d’où l’absence totale de juges dans les soirées stand up. Mais tout comme on n’adopte pas un pitbull pour son amour des câlins, on ne recrute pas les juges pour leurs contrepèteries, mais bien pour chasser les candidats. Car si maman canard promène régulièrement ses canetons, dans la nature, le candidat promène plutôt ses casseroles.
Attention : le candidat n’est pas sans défense. À vrai dire, la sienne est toujours la même : « Evidemment, comme par hasard, on me fait un procès pile en période électorale ! »
Des paroles reprises en chœur par ses soutiens, sans jamais que qui que ce soit ne relève :
– Qu’en France, on est toujours en période électorale
– Qu’en France, on est tellement habitués à la corruption qu’au lieu de regarder le crime ou délit, on regarde le calendrier
Oui, pour le candidat, le problème n’est pas de taper dans la caisse : c’est qu’on lui dise que ce n’est pas bien juste avant un rendez-vous important, et ça, c’est vraiment dégueulasse !
Alors certes, on me dira « Oui, mais notez que certains dossiers ressortent à des moments un peu taquins« . Oui-da, mais notez que le problème est plus le dossier que le moment. Vraiment. Si vous me piquez mon portefeuille, et que vous hurlez au complot parce que je vous ai demandé de me le rendre pendant que vous faisiez un discours sur votre formidable probité, tenter de m’accuser d’être le vilain de l’histoire, c’est quand même… ma foi, non,, c’est vrai : c’est suffisamment bas et bête pour être un truc de candidat.
Comme tous les bons chasseurs, le juge reste cependant un ami de la nature : lorsqu’il prélève un candidat, il le bague. On appelle cela un bracelet électronique.
La tenue traditionnelle du juge est en fourrure blanche, faite à partir de cheveux de candidats condamnés. Oui, les candidats se font généralement avoir en fin de carrière, donc le poil est blanc.
En captivité
Le candidat a une fâcheuse tendance à finir en captivité. Cependant, contrairement au zoo où les passants peuvent venir observer la bête tournant dans sa cage pour se distraire, ici, ce qui fait rire les enfants et pouffer les adultes, c’est le livre que le candidat fera écri… ahem, écrira durant son toujours trop bref temps passé derrière les barreaux. Permettez-moi de vous citer quelques extraits de l’ouvrage d’un candidat qui, afin de préserver son anonymat, sera nommé Le Comte de Monte-Tabouret.
Un téléphone était installé dans ma cellule comme dans celle des autres détenus. Il s’agissait d’un poste fixe. Je devais me tenir debout pour l’utiliser car il était fixé au mur à hauteur d’homme. Son utilisation n’était guère aisée.
Il est vrai que pour certains candidats, ce qui est à hauteur d’homme est hors de portée. Que ce soit un téléphone ou une carrière honnête.
Il convenait ensuite de composer pas moins de dix chiffres qui constituaient autant de codes nécessaires pour obtenir la ligne permettant enfin d’atteindre le correspondant désiré. Un véritable parcours du combattant.
Un triste rappel : si le candidat ignore le prix d’un ticket de métro ou d’un pain au chocolat, c’est parce qu’il vit dans un monde si différent du nôtre que même l’utilisation normale d’un téléphone lui semble incroyablement compliquée.
Même une simple enveloppe devenait un objet de convoitise. Pour en obtenir une, il fallait remplir un formulaire, attendre l’autorisation, puis espérer que le surveillant ait le temps de vous la remettre. Tout était compliqué, même l’acte le plus banal.
Le vrai drame du candidat en prison est que lorsqu’il reçoit l’enveloppe, elle ne contient pas d’argent. C’est une première : on comprend que ça surprenne un peu.
Mort
Tout comme les éléphants, lorsque les candidats sentent que la fin de l’un des leurs est proche, ils le guident vers un endroit secret où il pourra s’éteindre en paix, loin des prédateurs. On parle de Conseil Constitutionnel ou d’Académie Française (je vous rappelle que le candidat a écrit un livre, dites donc). Si jamais trop de candidats y sont déjà entassés à attendre que la grande faucheuse vienne les prendre comme une vulgaire valise derrière la Banque de France, on crée alors une commission. Un endroit où même les candidats qu’on n’ose plus envoyer à Bruxelles peuvent enfin s’endormir paisiblement sur un tapis fait d’épais fauteuils et de notes de frais. Attention cependant ; lorsque beaucoup de candidats sont dans la même commission, on parle de grande commission, et non de grosse commission, la seconde étant l’autre nom donné aux participants à la première.
Foire aux questions
Devient-on candidat à partir du moment où l’on dit « Je suis candidat » ?
Pas forcément, malheureux. Vous pouvez vous déclarer astronaute et ne pas l’être pour autant. Candidat, c’est pareil : des années d’emplois plus ou moins fictifs, de parachutisme sur des circonscriptions acquises à la cause, de pantouflage dans des cabinets d’élus copains… c’est un métier, tout de même. Je trouve que vous méprisez un peu les candidats. C’est mal.
Si un candidat est en captivité, n’est-ce pas dangereux de le relâcher dans la nature ?
Non. Le candidat n’a jamais vraiment connu la nature, ni le monde réel de manière générale. Comme expliqué plus haut, sitôt libéré, le candidat saura aller trouver auprès des siens le havre de paix dont il a besoin pour se tenir loin des prédateurs. Une commission, donc, ou un poste d’ambassadeur « contre la faim dans le monde » ou autre portefeuille flou, payé plus cher que vous, malandrin, et en plus pour assister à moins de réunions.
Je suis harcelée par un candidat, comment me débarrasser de ce gros lourd ?
Demandez-lui le prix d’une baguette. Il reculera en feulant.
Et si un candidat est honnête ?
Il perd.
Dites-donc Monsieur Connard, espèce de vil petit poujadiste, ne seriez-vous pas en train de nous faire le coup du monde politique où ils seraient « tous pourris » ?
Alors tous pourris, pas forcément. Mais tout pourri, certainement.
Lancés dans une course folle à l'IA, les Big Tech cherchent à implanter des centres de données sur tous les continents. Ils se heurtent de plus en plus, y compris aux États-Unis, à des oppositions locales qui dénoncent les impacts environnementaux et le manque de transparence autour de ces infrastructures gigantesques. Panorama de ces luttes populaires qui essaiment partout dans le monde.
De pays en pays, de continent en continent, la même histoire se répète. Lancées dans une course folle pour dominer le marché de l'intelligence artificielle (IA), les entreprises du numérique, Big Tech en tête (Google, Amazon, Meta, Microsoft, Nvidia, TikTok…), alliées à de puissants acteurs financiers, investissent des dizaines de milliards de dollars pour construire des centres de données. Selon L'Agefi, qui cite une note de l'agence Moody's, Meta, Amazon, Oracle, Alphabet (qui détient Google) et Microsoft ont engagé en 2025 près de 1000 milliards de dollars pour construire leurs hyperscalers. Un montant qui pourrait atteindre les 3 000 milliards de dollars d'ici 2030, selon l'entreprise d'immobilier JLL. Ces entrepôts gigantesques (pour la plupart appelés « hyperscale ») hébergent de grandes masses de données produites par l'utilisation de leurs IA respectives. Leurs exigences ? Un accès au réseau électrique, du foncier disponible et peu cher, et souvent des réserves d'eau à proximité pour refroidir leurs serveurs.
Selon les pays, cette configuration peut varier, mais à chaque fois, leur stratégie reste la même : arriver masqués, en dire le moins possible sur leurs impacts environnementaux, imposer leur narratif à base de « c'est le progrès » et « nous apportons des emplois » et obtenir le soutien politique nécessaire pour que tout se fasse le plus vite possible. Une stratégie que nous avons relatée en détail dans notre enquête sur le projet de datacenter de Google près de Châteauroux. Mais un élément peut venir troubler leurs plans : la contestation locale. Car il arrive de plus en plus fréquemment, au vu du nombre et de la taille des projets, que des groupes d'opposants, inquiets de voir ces gigantesques infrastructures se construire à côté de chez eux, se mobilisent pour en empêcher l'installation. Et obtiennent parfois gain de cause.
La lutte victorieuse des militants chiliens
C'est précisément ce qu'il s'est passé au Chili, à Quilicura, une commune située au nord de l'agglomération de Santiago, la capitale du pays. C'est en 2015 que Google décide d'y construire son premier centre de données, rejoint quelques années plus tard par un datacenter de Microsoft, puis d'autres opérateurs. Aujourd'hui, la commune en compte cinq, contre 33 au niveau national. Un chiffre encore modeste en comparaison avec les plus de 4000 centres de données présents aux États-Unis. Mais l'ancien président de gauche, Gabriel Boric, a lancé avant son départ un plan visant à augmenter leur nombre pour faire du Chili un « hub technologique ».
Certains résidents de Quilicura se sont inquiétés de voir les zones humides de la région s'assécher d'année en année. En 2022, l'étudiant en droit Rodrigo Vallejos a démontré, en épluchant la documentation transmise par Microsoft aux autorités chiliennes, que la firme avait menti sur la nature de son système de refroidissement. Il a déposé une centaine de plaintes, sans succès, pour contraindre Microsoft à ne pas prélever d'eau pour refroidir ses serveurs, dans un pays touché par une sécheresse qui dure depuis quinze ans. Mais le militant écologiste ne s'est pas découragé. En 2024, accompagné par Tania Rodríguez, fondatrice du Mouvement socio-environnemental communautaire pour l'eau et l'environnement (Mosacat), il a contesté devant le tribunal environnemental de Santiago les immenses quantités d'eau que Google prévoyait de consommer pour un second datacenter dans la même zone (7 milliards de litres d'eau par an, soit environ 228 litres par seconde, l'équivalent de 40 000 foyers). Après un long combat juridique, le tribunal a finalement suspendu le permis de construire de la multinationale. « Nous n'avons pas besoin de nouveaux centres de données qui vont nous priver d'eau, uniquement pour que les Occidentaux puissent créer des images rigolotes grâce à l'IA », a déclaré Tania Rodríguez au média anglais The Guardian.
Sur son compte Instagram, le militant chilien Rodrigo Vallejos a posté une photo du parc urbain créé par Google censé compenser l'impact environnemental de son datacenter.
Comme à Châteauroux et dans d'autres lieux d'implantation de ses datacenters, Google promettait un impact environnemental minimal et jouait la carte du bon voisin. « Mais ses investissements pour la communauté locale sont restés minimaux », déplore Alexandra Arancibia, conseillère municipale à Quilicura, interrogée par The Guardian. Pour faire tourner son centre de données construit en 2015, la firme n'emploie que 208 personnes, et le parc urbain qu'elle a créé en 2019 pour compenser l'impact environnemental de son site est selon elle un « échec » : « La végétation s'est desséchée, les sentiers ne sont pas entretenus et il n'y a pas d'irrigation. »
L'accès à l'eau, au coeur du combat contre les datacenters
En Amérique latine, la question de l'accès à l'eau constitue souvent la principale porte d'entrée des luttes contre les centres de données. Ainsi à Canelones, une petite ville du sud de l'Uruguay, pays marqué lui aussi par la sécheresse, où l'eau du robinet devient impropre à la consommation car trop salée, Google a annoncé un autre projet de datacenter. Les militants ont bataillé devant les tribunaux pour obtenir la divulgation de la consommation d'eau prévue par la firme américaine dévoile – 7,7 millions de litres par jour, soit l'équivalent des besoins en eau de 55 000 personnes. Elle a finalement été contrainte d'utiliser un système de refroidissement par air, bien moins gourmand en eau.
Dans le nord-est du Brésil, c'est la lutte des Anacés, un peuple indigène de l'État de Ceará, qui met des bâtons dans les roues de TikTok.
Dans l'État de Querétaro, en plein centre du Mexique, la population doit se faire livrer de l'eau par camion-citerne, à cause d'une sécheresse débutée en 2024. Une partie des habitants du territoire accuse les Big Tech (Equinix, Amazon, Microsoft et Google notamment) de prélever l'eau du système d'eau potable pour refroidir leurs serveurs, à hauteur de plusieurs millions de litres par an. Après de nombreuses actions, les habitants du village de Maconí, un des lieux les plus touchés, ont obtenu un accord avec le gouvernement fédéral qui doit leur garantir un accès pérenne à l'eau.
Dans le nord-est du Brésil, c'est la lutte des Anacés, un peuple indigène de l'État de Ceará, qui met des bâtons dans les roues de TikTok. Le Brésil compte aujourd'hui près de 210 centres de données, soit environ la moitié de la capacité installée en Amérique latine, et son gouvernement cherche à assouplir les conditions fiscales pour attirer encore davantage les opérateurs. Le géant chinois a investi 10 milliards de dollars dans un gigantesque projet de centre de données, dont une partie impactera directement leur territoire. « Ils le construisent juste au bord de la rivière », un lieu qui revêt une importance spirituelle pour la communauté, selon Cacique Roberto Ytaysaba Anacé, interrogé par Rest of World. Le peuple Anacé a donc déposé une plainte devant les autorités fédérales pour empêcher sa construction, dénonçant notamment la violation de leur droit à la consultation, garanti par un traité international.
L'Observatoire dans votre boîte email
Pour recevoir toutes les informations sur nos publications et nos événements.
Selon la journaliste indépendante Nastasia Hadjadji, coauteure avec Olivier Tesquet de Apocalypse Nerds (Divergences, 2025), ces implantations reflètent la dimension coloniale du modèle économique des Big Tech : « Leur agenda consiste à exploiter toutes les failles politiques d'un État, en choisissant consciemment les lieux où les populations sont les plus vulnérables. » Un constat partagé par la journaliste étasunienne Karen Hao, auteure de Empire of IA (Penguin Press, 2025), pour qui l'IA dessine les contours d'un néo-colonialisme numérique, reproduisant les schémas d'exploitation des empires de jadis. Elle a d'ailleurs contribué au lancement de The AI Resist List en mai 2026, une initiative visant à documenter les actes de résistance à cette industrie dans le monde.
Pour la journaliste étasunienne Karen Hao, l'IA dessine les contours d'un néo-colonialisme numérique, reproduisant les schémas d'exploitation des empires de jadis.
C'est précisément ce qu'il se passe en Inde, où le gouvernement a mis en place une exonération fiscale de 20 ans pour les opérateurs étrangers de centres de données. Google, Microsoft et Amazon y possèdent ou développent chacun au moins un centre de données, et ont jeté leur dévolu sur des zones rurales dont les habitants ne jouissent pas des mêmes droits de contestation que les populations occidentales, relève l'avocate Jillian Hishaw dans un article du média Rest of World. Malgré tout, dans l'État du Telangana, une partie des habitants du village de Mekaguda ont lancé une pétition contre un datacenter de Microsoft, l'accusant de déverser illégalement des déchets industriels dans un plan d'eau à proximité de leurs élevages de vaches.
C'est le projet d'hyperscale de Google, dans l'État d'Andhra Pradesh, évalué à 15 milliards de dollars, qui concentre le plus de critiques. D'après une enquête vidéo de l'Environmental Reporting Collective, Google veut artificialiser 200 hectares de terrains appartenant à des dalits (aussi appelés Intouchables), un des groupes sociaux les plus pauvres du pays. Les paysans dénoncent les pressions et les menaces subies de la part de la firme et du gouvernement, propriétaire des terres, qui a fait supprimer les posts Instagram d'une ONG informant sur le projet. « Nous nous battrons, même si nous devons y laisser nos vies », promet Pyla Kandamma, l'ancienne cheffe du conseil du village.
Travailleurs du clic et mouvements d'habitants
Aux Philippines, la lutte anti-IA est menée par les « travailleurs du clic », les personnes chargées d'entraîner les grands modèles de langage (LLM), obligés de visionner des vidéos pornographiques à des fins de modération par exemple, et payés une misère.
Ailleurs en Asie, les habitants des grandes villes japonaises s'organisent pour résister à l'essor des datacenters urbains. En Malaisie, où le gouvernement a récemment gelé l'arrivée de centres de données non liés à l'IA par craintes de tensions sur les ressources en eau et en électricité, les premières contestations commencent aussi à émerger. Aux Philippines, la lutte anti-IA est menée par les « travailleurs du clic », les personnes chargées d'entraîner les grands modèles de langage (LLM). Obligés de visionner des vidéos pornographiques à des fins de modération par exemple, et payés une misère, ils ont créé Code AI, une coalition réunissant plus de 1,8 million de travailleurs pour défendre leurs droits.
Au Kenya, autre pays de forte concentration de travailleurs du clic, une organisation baptisée Data labelers association s'est lancée avec le même objectif. « Nous construisons un mouvement dans lequel le travail numérique est visible, valorisé et organisé, et où le rôle humain à la base de l'IA est enfin reconnu comme un élément central, et non plus périphérique, de l'innovation », explique sa fondatrice, Joan Kinyua, à Rest of the world. Au Cap, en Afrique du Sud, des associations civiles comme Housing Assembly s'opposent à la construction de deux datacenters de l'entreprise étasunienne Equinix, qui domine le secteur de l'hébergement dit de colocation. Le pays, qui lui aussi « se rêve en leader continental de ce nouveau marché », décrit Courrier international, devrait prochainement accueillir des infrastructures de Google, Microsoft, Amazon ou encore Oracle.
L'Irlande, tête de pont des Big Tech en Europe
En Irlande, premier hébergeur européen en termes de capacité électrique, plus de 80 centres de données consommaient 22 % de l'électricité nationale en 2024, contre 5 % en 2015. Ce chiffre pourrait atteindre 30 % d'ici 2030. Cette demande exponentielle a fait grimper la facture d'électricité des ménages de 1,4 milliard d'euros et rendu le réseau électrique plus instable, à tel point que l'État a dû rouvrir dans l'urgence deux centrales à énergie fossile. Après avoir instauré un moratoire de près de trois ans, gelant 6,5 milliards d'euros d'investissement, le gouvernement impose désormais aux opérateurs de produire eux-mêmes leur électricité. Un revirement dû en partie aux mobilisations populaires débutées en 2021 sous l'impulsion de l'ONG People Before Profit et aux luttes locales.
En Irlande, premier hébergeur européen en termes de capacité électrique, plus de 80 centres de données consommaient 22 % de l'électricité nationale en 2024, contre 5 % en 2015.
À Ennis, dans le comté de Clare, trois scientifiques retraités, Bridget Ginnity, Colin Doyle et Martin Knox, ont mené pendant cinq ans une bataille juridique contre un centre de données de 200 mégawatts de l'entreprise Art Data Centres, derrière laquelle se cache Amazon. « Les politiciens suivent ce que veut Washington. Le message du gouvernement, c'est que nous avons besoin de centres de données. [...] Nous sommes dépendants des États-Unis, toutes leurs multinationales sont ici », déplorait Colin Doyle, interrogé par le média Le Soleil.
Au micro de France Inter, le porte-parole des Amis de la Terre Irlande, Rosi Leonard, appelait la France à ne pas répéter les mêmes erreurs que l'Irlande : « D'emblée, vous devriez imposer des limites strictes à l'expansion des centres de données : fixer une taille maximale pour leurs bâtiments, mettre en place des moratoires, et décider du type d'énergie qu'ils peuvent utiliser ainsi que du moment où ils peuvent la produire. » Une politique totalement opposée à celle promue par le gouvernement, qui se plie aux exigences des Big Tech pour faciliter leur installation sur le territoire.
Soutenez l'Observatoire
Parce que le débat démocratique mérite mieux que la com' du CAC 40.
« Une stratégie de prédation sur des territoires précarisés »
Instaurer un moratoire sur les projets de centres de données, c'est aussi ce que souhaite le collectif espagnol « Tu Nube Seca Mi Rio » (Ton nuage assèche ma rivière), créé en 2023, qui réunit agriculteurs, riverains et associations citoyennes. Celui-ci dénonce les investissements des Big Tech dans le pays, notamment en Aragon, où Google, Amazon et Microsoft prévoient de construire plusieurs infrastructures, dans un pays touché par des sécheresses récurrentes et une avancée de la désertification. Malgré l'opposition des militants, un projet d'hyperscale de Meta qui devrait consommer 500 millions de litres d'eau par an a été validé par les autorités locales de Castille-La Manche, aveuglées par les promesses d'emplois dans « une province déprimée qui affiche l'un des taux de chômage les plus élevés du pays (environ 24 %) », décrit Reporterre.
« On assiste à un regroupement des luttes »
Cette stratégie relève d'une « forme de prédation sur des territoires déjà précarisés, fragilisés économiquement et déjà pollués » observe Anti, du collectif français Le Nuage était nous pieds. C'est aussi le cas en Belgique, à Farciennes, commune la plus pauvre de Wallonie, où le mouvement de désobéissance civile Code Rouge s'est rassemblé fin juin 2026 à proximité du chantier du futur datacenter de Google, deuxième investissement majeur du géant étasunien en Belgique après son site à Saint-Ghislain. Réunis autour d'un sound system tekno, les militants ont dénoncé non seulement les conséquences environnementales du projet, mais aussi le rôle de Google dans le développement de l'IA et certains de ses contrats militaires. « Les terroristes, c'est Google, pas nous », a déclaré la responsable presse du mouvement au média belge la DH.
En France, « on assiste aussi à un regroupement des luttes », détaille Anti. Et le spectre est large : riverains mobilisés à l'échelle locale, collectifs antiextractivistes et anticoloniaux, comme Survie ou Génération Lumière, organisations environnementales comme France Nature Environnement, mouvements comme les Soulèvements de la Terre, défenseurs des libertés numériques dans la lignée de La Quadrature du Net ou de Data For Good, syndicats et travailleurs confrontés au remplacement de leur travail par l'IA, militants anarchistes et antimilitaristes, chercheurs ou sociologues, syndicats agricoles ou encore tenants du permacomputing. Au Bourget, en Seine-Saint-Denis, leur mobilisation a payé : le nouveau maire de la commune, Mehdi Nezzar a invalidé le permis de construire accordé à l'entreprise immobilière anglaise Segro, lui demandant l'abandon du projet de centre de données dans sa forme actuelle, détaille un communiqué du 17 juin 2026. Pour le journaliste Nicolas Celnik, coauteur avec Fabien Benoit de Techno-luttes : Enquête sur ceux qui résistent à la technologie (Seuil, 2022) et de Les Assoiffeurs : Enquête sur ces entreprises qui accaparent l'eau (Les Liens qui libèrent, 2026), « on observe dans les luttes contre les datacenters les mêmes configurations de résistance qu'à Sainte-Soline ».
Aux États-Unis, une résistance transpartisane...
Cette coalition de luttes est encore plus vaste et plus politiquement diverse aux États-Unis, le pays qui de loin accueille le plus de centres de données au monde. Le mouvement anti-datacenter serait parvenu, selon le média américain Grist, à réunir une coalition plus vaste que les luttes climatiques : « Des gens de tous horizons — des musiciens punk de l'Utah, des agriculteurs de l'Oregon, des employés de salons de beauté du Maryland — se mobilisent pour toutes sortes de raisons. [...] Mais leurs différences ne les empêchent pas de travailler ensemble », explique Levin Saul, animateur d'un podcast sur les résistances contre les centres de données.
L'opposition aux centres de données constituent l'un des rares sujets qui rassemblent les citoyens étasuniens.
Ce qui se vérifie aussi d'un point de vue politique. « Même dans un État « bleu » [démocrate, ndlr], tout le monde s'accorde à dire que l'opposition aux centres de données doit être bipartisane pour avoir une chance de réussir », écrit la journaliste de Grist Kate Yoder. Les centres de données constituent d'ailleurs l'un des rares sujets qui rassemblent les citoyens étasuniens : selon un sondage Gallup, 75 % des démocrates et 63 % des républicains s'opposent à la construction de centres de données dans leur région. Au point de changer totalement les orientations politiques de certains candidats aux élections de mi-mandat, comme la démocrate Keisha Lance Bottoms, qui célébrait il y a quelques années l'arrivée de Microsoft en Géorgie et qui fait désormais campagne pour un moratoire sur les centres de données, comme le raconte Libération.
Reste néanmoins un point de vigilance : quels seront les discours mobilisés pour s'opposer à l'essor de l'IA durant ces élections ? S'agira-t-il de défendre les écosystèmes et de dénoncer son coût environnemental, ou de brandir le risque d'une annihilation de l'humanité ? Nastasia Hadjadji invite à interroger la coloration idéologique de certains opposants et met en garde contre les discours qui associent le rejet des technologies à des positions réactionnaires, comme c'est le cas en France de la mouvance Anti-Tech Résistance. Certains de ses représentants voient, par exemple, dans la pilule abortive une menace technologique similaire à celle de l'IA. Mais la vague de mobilisation étasunienne, dont une frange tant à se radicaliser vers des actions violentes, pourrait inspirer les mouvements de résistance dans le monde entier, car elle semble en passe de faire infléchir les Big Tech.
…victorieuse à plusieurs reprises
Selon Data Center Watch – un projet financé par l'industrie elle-même – 130 milliards de dollars d'investissements ont été bloqués ou retardés au premier trimestre 2026, soit autant que pour l'année 2025 entière. En septembre 2025, Google a abandonné un projet d'un milliard de dollars à Indianapolis après la mobilisation de riverains. Même constat en Virginie, où une filiale de Brookfield, Compass datacenter, s'est retirée d'un vaste projet sur 333 hectares. Le projet Data Center Opposition recense 268 collectifs de protestation répartis dans 37 États, représentant près de 360 000 opposants. La célèbre activiste Erin Brockovich a également lancé un observatoire citoyen et développé sa propre cartographie des centres de données aux États-Unis. Au niveau local (villes et comtés notamment), le site US Datacenter Moratorium Tracker recense 116 moratoires actifs. Une quinzaine d'États songent également à légiférer à ce sujet, tandis qu'au niveau national, les élus démocrates Bernie Sanders et Alexandria Ocasio-Cortez appellent à un moratoire national. Plus de 500 organisations ont d'ailleurs signé une lettre adressée au Congrès le 11 juin 2026 rejoignant leur proposition.
Face à ces contestations, les Big Tech investissent massivement pour se refaire une image.
Face à ces contestations, les Big Tech investissent massivement pour se refaire une image, à coup de lobbying et de promesses d'emplois recyclées par une classe politique souvent très naïve vis-à-vis du selon de la « souveraineté numérique ». La bataille pour l'acceptabilité sociale est aussi une guerre culturelle, et le récit de l'inévitabilité de ces infrastructures s'est installé dans le débat médiatique.
Mais, derrière ces rhétoriques bien huilées se profile aussi le risque d'un accroissement de la répression contre les opposants aux datacenters. En Belgique, 19 militants du mouvement de désobéissance civile Code Rouge ont été perquisitionnés, et six d'entre eux ont été inculpés par les autorités flamandes au cours du mois de juin 2026. Aux États-Unis, des documents obtenus par le média Wired révèlent que les autorités fédérales, dont le FBI, considèrent les « extrémistes anti-tech » comme une cible prioritaire de leurs activités répressives et de surveillance. Entre les opposants au datacenters et les Big Tech, le gouvernement étasunien a choisi son camp.
Quand on audite un menu de navigation, est-ce pertinent de signaler une erreur si l’état « survolé » d’un lien est indiqué seulement par un changement de couleur ?
Au quotidien, nous avons toutes et tous recours à de nombreux objets, services et technologies dont l’existence semble évidente et l’usage parfaitement ordinaire.
Ce que beaucoup ne soupçonnent pas, c’est qu’une partie de ces inventions trouve son origine dans le handicap.
Les sous-titres, les livres audio, les SMS, et même la brosse à dents électrique ne sont que quelques exemples, parmi tant d’autres, de solutions qui n’ont pas été pensées, à l’origine, pour le grand public.
Derrière ces innovations se trouvent des personnes ayant été confrontées à des obstacles très concrets, mais aussi des démarches de recherche, de conception et parfois des inventions réalisées par les personnes concernées elles-mêmes.
Ces solutions sont nées d’un besoin simple : permettre aux personnes handicapées de contourner certaines difficultés, de gagner en autonomie ou d’accéder à des usages jusque-là compliqués, voire impossibles, à cause d’un manque d’universalité dans la conception des produits, infrastructures, communications, environnements, etc.
Paradoxalement, des solutions, initialement pensées pour répondre à des situations particulières, sont donc devenues des évidences de la vie de tous les jours pour tout le monde.
Ce phénomène a d’ailleurs un nom : l’effet « bordure de trottoir » ou, en anglais, « curb-cut effect ».
Dans cet article, nous vous proposons un retour sur plusieurs inventions et usages largement démocratisés dans notre société, mais dont les racines sont étroitement liées à l’accessibilité.
La réception d’appels et de notifications par vibrations, maintenant présent sur n’importe quel téléphone mobile, a été implanté pour la première fois en 1996 par Motorola avec le Motorola StarTAC.
Outre le fait de pouvoir sentir son téléphone dans un environnement bruyant, cette fonctionnalité permettait surtout de rendre les appels et notifications désormais perceptibles pour les personnes sourdes et malentendantes.
Grâce aux vibrations, il devenait alors possible d’être averti d’un appel sans dépendre uniquement du son.
La paille flexible
Dans les années 30, en observant sa fille de deux ans avoir du mal à boire son milkshake à la paille, son père, un inventeur du nom de Joseph Friedman, s’est adonné à repenser le design des pailles, qui n’étaient alors que de simples tubes rigides en papier, en s’aidant de vis et de fil dentaire.
Brevet accordé à Joseph Friedman (image : Radio-Canada)
Après avoir breveté son invention, les hôpitaux furent les tous premiers à adopter ces nouvelles pailles pliables car elles permettaient entre autres aux patients alités ayant des difficultés de motricité ou de déglutition de boire dans de meilleures conditions.
Avec l’essor du plastique, son usage s’est ensuite très largement popularisé à partir des années 60, pour devenir cet objet de la vie quotidienne que l’on connait aujourd’hui, apportant évidemment son lot d’impacts environnementaux.
Heureusement, des alternatives existent, telles que les pailles réutilisables en silicone ou en inox avec embout flexible.
Les fidgets toys
Vous souvenez-vous des handspinners ?
Ces toupies à main, qui avaient envahi les cours de récréation en 2017, ne sont qu’une énième itération d’un concept d’objet nommé « fidget toy » (« s’agiter, gigoter » en anglais) ayant vu le jour dans les années 1990 par le biais de recherche médicale dans l’ergothérapie sensorielle.
En effet, ces « jouets » sont à l’origine conçus pour aider les enfants avec TDAH à améliorer leur concentration et réguler leur stress.
Apparus comme un phénomène viral aussi vite qu’ils ont disparu du quotidien du grand public, les fidget toys, tout en continuant à accompagner les personnes initialement concernées, demeurent un moyen discret et thérapeutique envisageable pour qui souhaitant calmer son anxiété, travailler sa motricité fine, ou canaliser son énergie.
La brosse à dent électrique
Aujourd’hui largement recommandée par les professionnels de la santé bucco-dentaire, la première brosse à dent électrique, de son nom la BROXODENT, vit le jour en 1954 en Suisse.
Invention du Dr Philippe-Guy Woog, ce dernier étudia et prouva la corrélation entre la santé des gencives et l’alimentation moderne : cette dernière ayant eu tendance à se ramollir avec l’évolution de notre société et de nos habitudes de consommation, les problèmes gingivaux ont fortement augmenté, notamment chez les personnes ayant une motricité fine insuffisante pour exercer les mouvements de brossage et la pression requise pour obtenir un brossage efficace en profondeur.
Pour pallier à cette diminution progressive de la nourriture dure et crue qui permettait d’entretenir naturellement les gencives, il mit alors au point cette fameuse BROXODENT, mais ce n’est qu’à partir des années 90, que les brosses à dents électriques se sont progressivement popularisées, portées par les avancées technologiques et surtout la baisse de leurs prix.
Conclusion
Nous avons cité en introduction les SMS, les livres audio et les sous-titres.
Est-ce qu’améliorer l’accessibilité, c’est rendre service à tout le monde ? Potentiellement, mais ce n’est pas l’objectif premier. L’accessibilité vise avant tout à répondre au droit fondamental des personnes handicapées : celui de pouvoir vivre, se déplacer, apprendre, travailler, accéder à la culture comme toute personne. Les bénéfices pour les autres publics (personnes âgées, parents, voyageurs) sont potentiellement réels, mais secondaires. Les mettre en avant en priorité, c’est dépolitiser la question, la réduire à du confort, et oublier que sans ces aménagements, certaines personnes restent exclues.
Autrement dit, l’histoire de ces inventions est très intéressante, mais le fait qu’elles aient été pensées pour les personnes handicapées puis bénéfiques pour tout le monde n’est pas (et ne doit pas constituer) un argument en faveur de l’accessibilité.
Les bénéfices induits pour le large public ne sont qu’une conséquence bienheureuse, l’objectif recherché étant le respect, l’application et la garantie des droits des personnes handicapées dans la société sous tout aspect (citoyen, culturel, professionnel, éducatif, sanitaire, etc.).
Accessible web design opens up a universe of possibilities where every user, regardless of their abilities, can easily navigate, interact, and appreciate your website.
But why stop here?
Achieving web accessibility isn’t merely a requirement by law; it’s a critical step towards improving user experience and amplifying your site’s engagement.
Creating an accessible website involves several aspects – optimal colour contrast, appropriate text size, and the use of semantic HTML, among other things. Although it may seem overwhelming at first, knowing where to begin is a challenge that we can tackle together.
In this post, we’ll go over the main areas to concentrate on when constructing an accessible website and discuss six exceptional examples of accessible websites, each illustrating best practices and serving as a source of inspiration.
First, the basics: the four principles of accessibility (POUR)
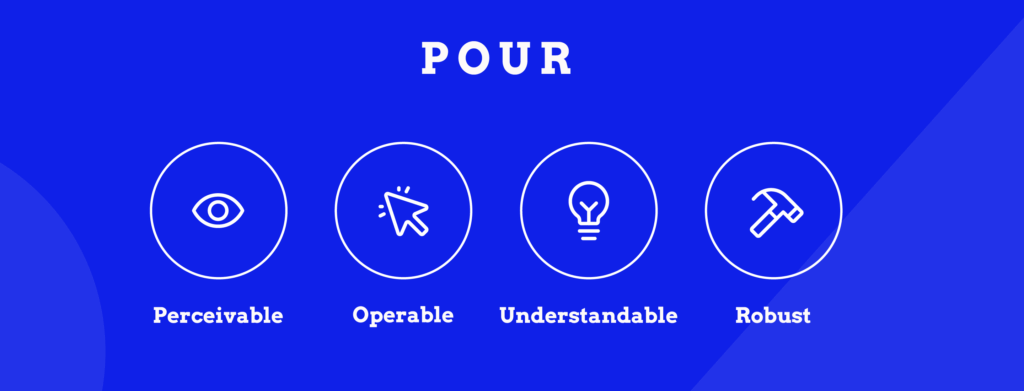
Every accessible website is built on four core principles defined by WCAG. These form the foundation of web accessibility:
Perceivable: Information must be presentable to users in ways they can perceive. If someone can’t see images, they need alt text. If they can’t hear audio, they need captions. Content can’t be invisible to all of someone’s senses.
Operable: Users must be able to operate the interface. This means providing keyboard access, giving people enough time to complete tasks, not causing seizures with flashing content, and helping users navigate and find content easily.
Understandable: Information and operation of the user interface must be understandable. Use clear language, make your site behave predictably, and help users avoid and correct mistakes.
Robust: Content must work reliably with current and future technologies, including assistive technologies like screen readers, voice recognition software, and alternative input devices.
These four principles – Perceivable, Operable, Understandable, Robust (POUR) – guide every WCAG success criterion. When websites meet these principles, they work for everyone.
What makes a website accessible?
Since accessibility is centred around people, your first job would be to consider the wide range of potential impairments – from vision and hearing impairments to cognitive and physical disabilities. The goal is to create an inclusive experience for every user, regardless of their abilities.
AA – The global standard everyone should adhere to.
AAA – The strictest requirements that aren’t necessary.
Usually, legal accessibility requirements stipulate at least AA compliance; however, striving for AAA accessibility where possible can elevate the user experience considerably.
The WCAG guidelines cover a wide array of accessibility aspects, from visual design to navigability and coding semantics to input modalities. If you want to read more about them, go to the W3C website.
For the site owners, web designers, and developers who are already interested in learning more about any of these specific topics or just web accessibility in general, our team at The A11y Collective has created a range of online courses for that very purpose.
Essential accessibility features at a glance
Here’s a quick reference guide to the main features that make websites accessible:
Feature
What it does
Who it helps
Alt text for images
Provides descriptive text for images
People using screen readers, those with slow connections
Readable text
Uses clear fonts, appropriate size, and spacing
People with dyslexia, low vision, or reading difficulties
Keyboard navigation
Allows full site use without a mouse
People with motor disabilities, screen reader users, and power users
Colour contrast
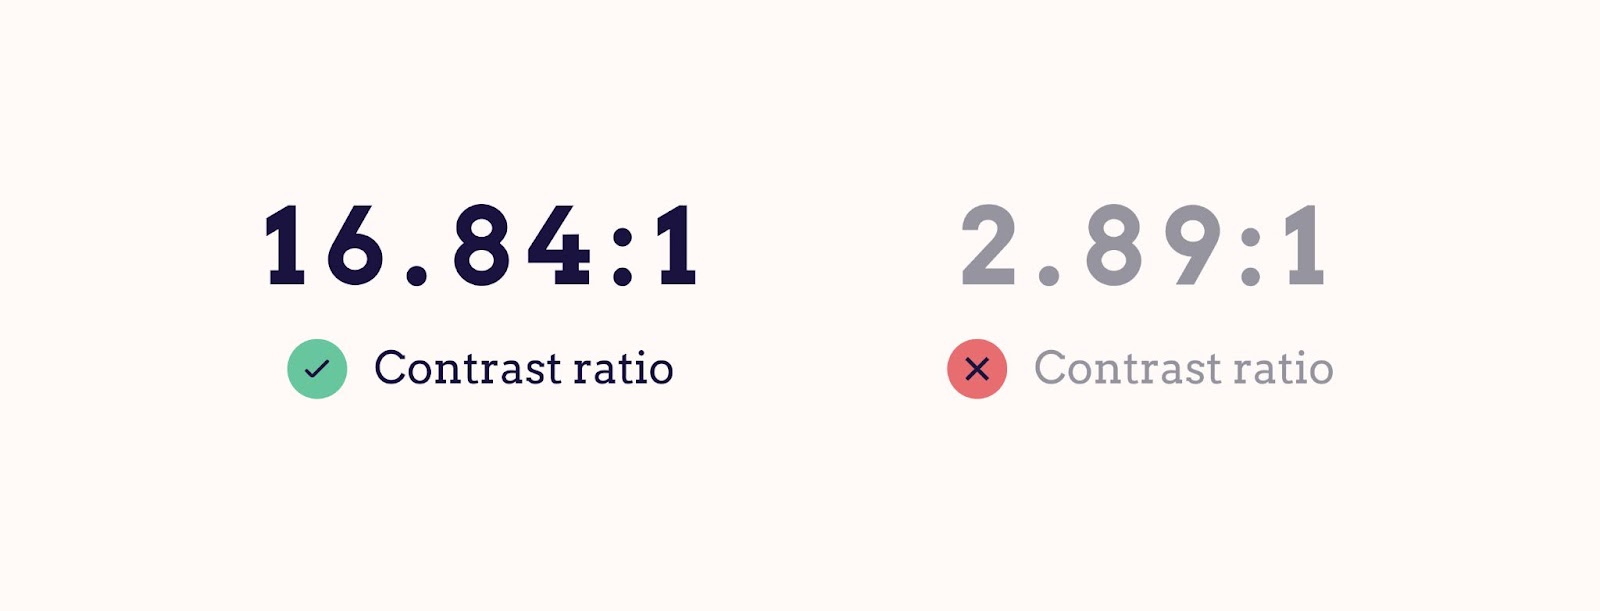
Ensures text stands out from backgrounds (4.5:1 minimum)
People with low vision, colour blindness, or viewing in bright light
Captions/subtitles
Provides text versions of audio/video content
People who are deaf or hard of hearing, non-native speakers
Consistent design
Keeps layouts and navigation predictable
People with cognitive disabilities, all users learning the site
Semantic HTML & ARIA
Uses meaningful code for assistive technologies
Screen reader users, keyboard navigators
Below, we’ll explore each of these features in detail with practical examples and implementation tips.
Alt text for images
This descriptive text helps relay the content of the images to users who may depend on screen readers to browse the internet. When crafting alternative text, focus on conveying the essential details contained in the image.
Keep in mind that the aim isn’t to provide an artistic critique of the image but rather to communicate necessary information to visitors who might not be able to visually perceive it.
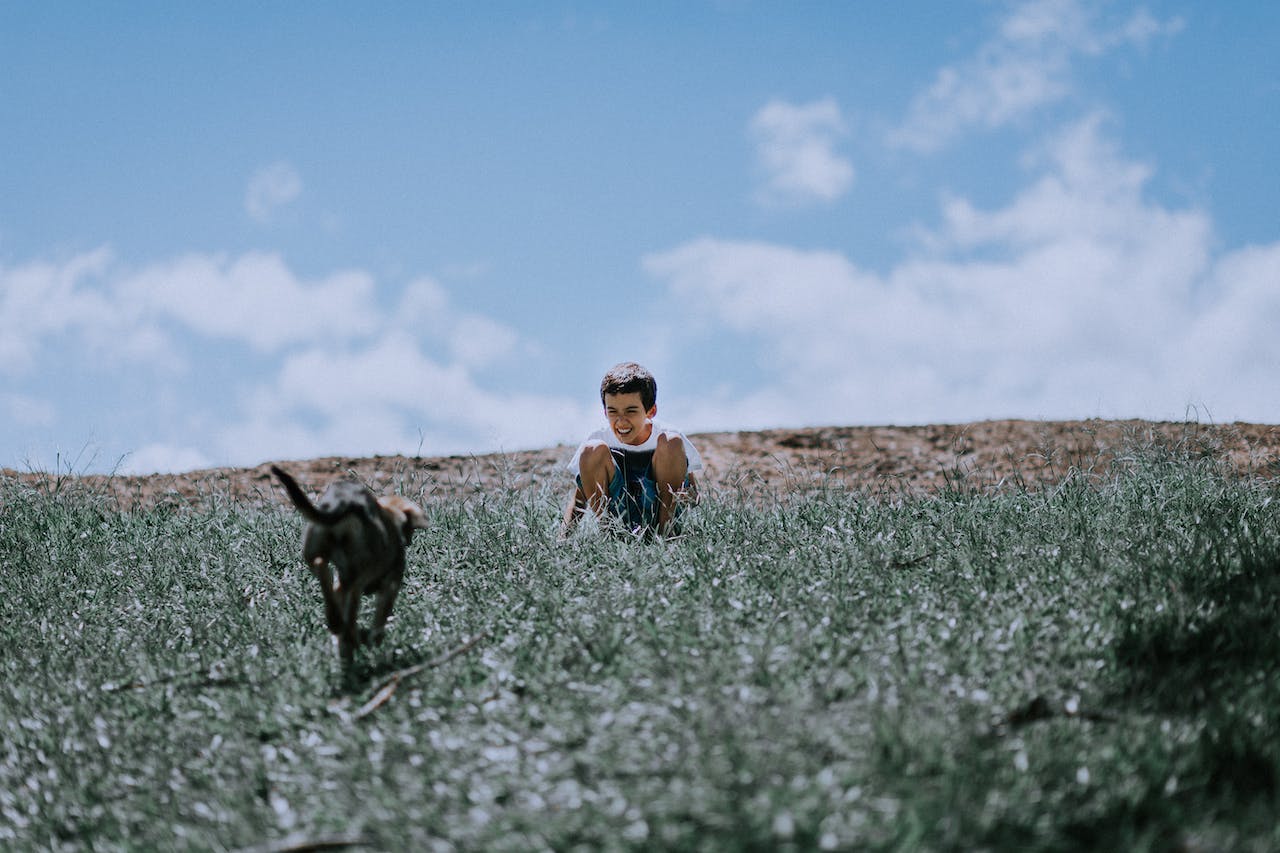
A horizontal photograph of a small black-haired boy with a white shirt and short jeans, smiling with anticipation, kneeling in a patch of grass waiting for a little furry dog of unknown breed to meet him at his location.
A boy sitting on green grass waiting for a dog.
If you said the second one, you’re on the right track. This simple, informative description allows visually impaired users an equivalent content experience to their sighted peers.
Readable and legible text
Websites, particularly ones dense with content, are more accessible and user-friendly when the text is concise. Fonts, text size, and line spacing are pivotal to the legibility of your content. Avoid fonts that may be challenging for some users to read, for example, ones with “imposter letter shapes”.
Use relative units like “em” or “rem” when specifying text sizes, typically keeping body text around 1em or larger.
Appropriate line spacing can make blocks of text easier to read and less daunting.
Tooltips, which usually appear when users hover over or focus on a particular item, should have a background and text colour with high contrast. These design elements should never block essential information or controls and must be legible.
Keyboard-friendly navigation
In the pursuit of outstanding web accessibility, it’s essential that a website be fully functional via a keyboard. This allows users who are unable to use a mouse due to physical disabilities to browse your website without hindrance.
Key navigation controls such as “Tab” to move forward and “Shift” + “Tab” to move backwards should be fully functional, enabling users to access all actionable elements like links, buttons, and forms.
Colour contrast
Adequate colour contrast between text and the backdrop aids visually impaired users, particularly those who are colourblind. High contrast levels between the background and text can greatly augment the visibility and overall accessibility of your website.
To ensure compliance with these, there are several tools, such as the WebAIM Contrast Checker and the Stark plugin for Figma, Sketch, and Adobe. These tools calculate the contrast ratio and indicate whether your chosen colour combination meets the required standards.
For instance, a colour combination such as black text on a white background gives a high contrast ratio, while light grey text on a white background would not meet accessibility standards.
Captions/subtitles for videos
Besides being beneficial for those with impaired hearing, they also assist non-native speakers in understanding video content and cater to those eager to learn a new language. Similarly, users in a noisy environment or who prefer silenced videos can significantly benefit from this feature.
Consistency in design and navigation
Predictable and intuitive navigation accompanied by a consistent layout provides an exceptional user experience. This involves maintaining a familiar design across the site, using easily recognisable web design patterns such as commonly located search bars, and ensuring a proper hierarchical structure of headings is in place.
Semantic HTML and ARIA landmarks
Using semantic HTML – meaningful HTML elements that describe their function – enables viewers and screen reader users to better interpret different areas of your web pages. The use of heading tags, such as <h1>, <h2>, <h3>, etc., assists visitors and assistive technologies in skimming through different sections of a webpage.
Integrating Accessible Rich Internet Applications (ARIA) landmarks can markedly advance your website’s accessibility. These landmarks, through specially designed code, assist screen readers in providing additional context to users, thereby fostering better understanding and navigation.
A prime example is using ARIA landmarks to label a search section on a website. By doing so, assistive technologies can quickly recognize this feature and guide users to it.For readers eager to delve deeper into ARIA’s details and practical implementation, consider signing up for The A11y Collective’s insightful course, “ARIA explained”.
Understanding the importance of website accessibility
Just as ramps and elevators facilitate physical mobility, web accessibility practices ensure digital inclusivity, making online content usable by all. Accessible web design benefits everyone – it encompasses a wide variety of needs and improves the user experience by considering the diverse range of site visitors.
Web accessibility is particularly essential for users with disabilities who are part of one of the three main types of disability groups: permanent, temporary, and conditional/situational.
Permanent disabilities may include enduring visual, auditory, or physical impairments.
Temporary disabilities could be short-term conditions like a broken arm affecting your ability to use a mouse or a scratched cornea impacting your sight.
Situational or conditional disabilities refer to external factors that could affect how someone interacts with a website, like trying to view a screen in bright sunlight or attempting to browse while holding a baby.
Our goal is to make the digital space as welcoming as possible, no matter the circumstances of any individual.
Take, for example, a site incorporating simple, clear navigation menus: this small design choice eases the experience of all users, particularly those with cognitive impairments who may find complex navigation structures overwhelming.
It’s worth noting that good design is far more than just aesthetic appeal and fancy graphics. It’s about creating a platform that’s intuitive, enjoyable, and inclusive for everyone.
How accessibility affects SEO and rankings
Search Engine Optimisation, more commonly known as SEO, relates to practices aimed at enhancing a website’s visibility on search engine result pages. Although accessibility is not a direct ranking factor for search engines, such as Google, it can significantly impact user experience signals that are central to SEO.
An inaccessible website may lead to higher bounce rates as users may quickly leave if they find it difficult to navigate or interact with the site. So logically, accessible websites tend to encourage more user engagement, signalling to search engines the value of the site to visitors.
This sentiment is echoed by Google Search Advocate John Mueller, who stated:
Accessibility is something that is important for a website because, if you drive your users away with a website that they can’t use, then they’re not going to recommend it to other people.
Despite these legal frameworks, the case for accessibility extends beyond mere compliance. Of course, the risk of legal repercussions may push certain organisations to prioritise accessibility, but the real prize is the ethical duty of providing equal access to all users. It’s about businesses recognising and validating the diversity of their audience and ensuring their digital platforms mirror these beliefs.
6 stellar examples of accessible websites
Theory is good, but it’s even better to see all of these tips in action. That’s why we’ve collected some of the best examples of websites that follow accessibility guidelines:
BBC
BBC main website accessibility page
Emerging as a leader in the field of the digital inclusivity matrix, the British Broadcasting Corporation (BBC) exhibits a passionate dedication to making its digital services accessible to one and all.
Their specific accessibility page provides a plethora of links to resources and documents to help users access the BBC’s content. This page is indeed a testament to accessibility in action.
The BBC also makes sure that all of their websites work well with assistive technologies to guarantee the best possible browsing journey for their audience.
Rotterdam Innovation City
Rotterdam Innovation City website
Rotterdam Innovation City‘s seamlessly designed and keyboard-navigable website is a testament to its commitment to accessibility.
Indeed, their masterful use of semantic HTML provides meaning to the web page content, ensuring users and screen readers alike can nimbly navigate through different website elements.
Harvard University
As a reflector of its academic excellence, Harvard University ensures a hurdle-free digital experience. The University provides an array of reading tools, incorporates multilingual video subtitles, and has carefully botched its colour scheming to accommodate the needs of colourblind individuals.
Their menu also reflects the simplistic but effective design of their website with a large and easy-to-read font and clear interface.
GOV.UK
GOV.UK expertly demonstrates its commitment to digital inclusivity and accessibility. The array of accessibility features on its webpage, from clear content displayed with high contrast, consistent navigation, and support for assistive technologies through ARIA landmark roles to full keyboard navigation functionality, is impressive.
In their Accessibility statement, they also directly list all the features included in the website.
Additionally, they offer people the option to request any content in a different format best suited for them, such as plain text, braille, BSL, large print, or audio CD.
Barclays
The digital version of Barclays mirrors its corporate commitment to advocating for accessible banking. With provisions for intuitive navigation, sensitive colour schemes, compatibility with screen readers, and a host of other features, the Barclays website makes banking accessible to all.
Apple
Apple has long been recognised as a leader in accessibility, and their website reflects this commitment. Apple.com demonstrates that accessible design doesn’t mean compromising on visual appeal – their clean, high-contrast design works beautifully with screen readers, keyboard navigation, and voice control.
Their product pages provide comprehensive keyboard navigation throughout complex product configurators, detailed alt text for product images, and video content with captions and audio descriptions. The shopping experience works just as smoothly whether you’re using a mouse, keyboard, screen reader, or voice commands
With these examples serving as a benchmark, start making strides to enrich your own website’s accessibility and usability today! Embed these best practices into your web projects to create a streamlined user experience that truly caters to everyone.
What an accessibility statement looks like
You might have noticed that many accessible websites include an accessibility statement. This is a public commitment that shows users you care about accessibility and provides a way for them to report issues. Here’s what a good accessibility statement typically includes:
EXAMPLE ACCESSIBILITY STATEMENT TEMPLATE
Our Commitment to Accessibility
[Organisation Name] is committed to ensuring digital accessibility for people with disabilities. We are continually improving the user experience for everyone and applying the relevant accessibility standards.
Conformance Status
The Web Content Accessibility Guidelines (WCAG) define requirements for designers and developers to improve accessibility for people with disabilities. We aim to conform to WCAG 2.1 Level AA standards.
**[Website Name] is [fully/partially/not] conformant with WCAG 2.1 Level AA. [Fully conformant means: the content fully conforms to the accessibility standard without any exceptions. Partially conformant means: some parts of the content do not fully conform.] **
Measures to Support Accessibility
[Organisation Name] takes the following measures to ensure accessibility:
• Include accessibility as part of our mission statement • Integrate accessibility into our procurement practices • Provide ongoing accessibility training for our staff • Test with people who use assistive technologies
Feedback and Contact Information
We welcome your feedback on the accessibility of [Website Name]. Please let us know if you encounter accessibility barriers:
We aim to respond to accessibility feedback within [X business days].
Technical Specifications
Accessibility of [Website Name] relies on the following technologies:
HTML
CSS
JavaScript
ARIA
Date: [Last reviewed: DD/MM/YYYY]
That’s it! Your accessibility statement doesn’t need to be fancy or full of jargon – it just needs to be honest, clear, and show that you’re committed to making your website work for everyone. You can see real examples on sites like the BBC and GOV.UK.
Take the next steps toward creating accessible websites
Creating an accessible website involves more than just ticking compliance boxes. It’s about welcoming your users into the heart of your online presence and enhancing their experience.
While there are various automated tools that check your website’s accessibility, keep in mind that they provide some insights, but their scope and depth can be somewhat limited. They simply cannot comprehend user experience as humans do.
In particular, be cautious of quick-fix solutions such as accessibility overlays. Despite their tempting promise of making your website accessible with a single click, these overlays often fail to resolve numerous website accessibility issues and have been widely criticised by users with disabilities.
Instead of relying on these patchy solutions, it’s wiser to build a comprehensive understanding of what an accessible website looks like and how to create one. Don’t worry. Building that understanding is not as daunting as it sounds. Remember, The A11y Collective is here for your support. Our bespoke online courses are here to guide you on this journey towards accessibility. “Web accessibility, the basics” is a particularly beneficial course that provides you with the best foundation in this area.
The journey to web accessibility is an ongoing process, not a one-off task. As standards evolve, so should your understanding, and continuous learning is an integral part of the journey toward better accessibility and inclusion.
So, don’t wait – take the next step in enhancing your website’s accessibility and enroll in one of The A11y Collective’s courses today!
Design websites that meet accessibility laws.
Understand how design decisions impact real-world users and teach you to create websites that are inclusive for everyone.
The earth is heating up and AI isn't helping. It drives major increases in electricity use, water use and CO2 emissions. Yet, industry and governments alike seem keen to leverage the latest tech. Can we make greener choices?
Yesterday, I spoke at a conference on AI in government about sustainable choices. The presentation and slides were in Dutch, this post is a high level summary of what I covered.
As the presentation took place during a record-breaking heatwave, which meteorologists attribute to climate change, and there were some airconditioning-related issues, very little irony was lost on us.
Words matter
I started out talking about if AI is good or bad for sustainability and called it the wrong question. It's the wrong question, because both AI and sustainability are concepts that have many meanings.
AI can be understood in different ways:
as a technology, there are many kinds; Microsoft alone has 78 products named Copilot, but also, there are many types of AI, like computer vision, natural language processing, generative AI and agentic architectures. Traditional vs generative can be a useful distinction in sustainability, because of the difference in energy impact.
as an economic phenomenon (it isn't profitable yet, so it may get more expensive or introduce ads, and there are lots of financial stakes that explain why it's sometimes forced on consumers)
as an infrastructure (behind the cloud metaphore, there are very real data centres that warrant closer inspection)
Sustainability is multi-faceted too. In the Web Sustainability Guidelines, we center our definition around three pillars that ultimately need balance between them: Planet, People, and Profit:
Planet: its surface temperature rises due to emission of greenhouse gases that trap heat, and it has a finite amount of water of which only a small portion is suitable to drink.
Profit: within our capitalist system, the needs of planet and people need to be balanced with profit, in order for anyone to successfully make the case for change.
So, there's some nuance about what the words mean, but despite that, it's worthwhile to try and reduce climate impact of our services. The pope said so, and in government, it's an increasingly a priority (like in the UK, where the Digital Service expanded their design guidance last year with principle 11: Minimise environmental impact) .
It's ok not to use AI
I shared five tips to make greener choices around AI, but couldn't help myself to add a bonus tip as tip zero: in many cases, not using AI for your project makes the most sense. Which is fine.
Many of us will have sat in meetings around a new idea or project, where someone put up their finger and said ”oh, maybe we can use AI for this”. The AI vendors primed us for this with hype.
Often, using AI, and especially generative AI, is like going to your local corner shop using a helicopter. What if you could solve the same problem with a couple of lines of Python, and Excel-sheet, people, or manually summarising?
I wanted to mention this specifically, because nobody wants to be the downer in the group and suggest not doing the thing that everyone is hyped about. But to be sustainable, we need to pick out just the cases where AI is absolutely necessary, and go without it for anything else.
Five tips to make greener choices
When using a specific type of AI actually solves your problem best, here's five tips to make greener choices.
Smaller models
When using generative AI, model size differs wildly. An example of a large model is DeepSeek v4 Pro, which has 1.6 trillion parameters (12 zeroes), while there are small models like Hugging Face's SmollLM that has 135 million parameters (6 zeroes).
A lot of generative AI uses so-called general purpose models, which are systems that know pretty much everything about the world. When hiring humans, we usually list a specific area of expertise. That's partially because there are no humans that know it all (just ones that think they do).
We should try to do the same with language models. If we're building a system that answers questions about taxes, we don't need to tell it what the capital of France is.
In “Power Hungry Processing”, Luccioni, Jernite, & Strubell explains this: “multi-purpose generative architectures are orders of magnitude more expensive than task-specific systems for a variety of tasks, even when controlling for the number of model parameters” (emphasis mine).
Be smart about data centre usage
In many applications of AI, the relevant software needs lots of computing: GPUs, CPUs, memory, and storage. This computing is often done in the “cloud”, or: data centres. The climate impact of data centres is widely seen as three components: electricity, CO2 emissions (and equivalent greenhouse gases), and water usage.
The International Energy Agency predicts the amount of data centres to double or triple over the next few years. The electricity used for this will be green, partially. But it won't all be green : gas and coal will continue to be a share of what powers data centres.
On an operational level, we could reduce the load on data centres by reducing how many tokens we use, via smarter prompting (shorter, more specific, more explicit, less repetition through variables). The paper Smarter, smaller, stronger by Perez Ortiz and Drobnjak details tests that show reducing a response from 400 to 200 words reduced energy consumption by 54%.
On a policy level, one tip I learned at the AI reporting event I attended, is to question how many 9's you really need. Data centres are convenient because they offer compute for rent and make it easy to scale. And they offer uptime, guaranteeing sometimes up to 99,99999 availability: five nines. More nines could mean less sustainability: some data centres will use diesel power or other unsustainable sources when they have a power cut. So to get to a higher uptime guarantee, they need to make such choices. What if we required less nines? What if we decided it's ok to have the AI thing not work for a couple of days a year?
Recognise greenwashing
Greenwashing is everywhere, and to make sustainable choices, we'll need to develop our skills to recognise it from afar. Sometimes it's easy to recognise, like an airline that said with them, you can “fly responsibly” (a Dutch court said this is misleading). EU Directive 2024/825 effectively forbids greenwashing, but companies still tend to do it.
“bait and switch”: often “traditional” AI has a much smaller footprint than generative AI; when companies point at how clean their traditional AI is while ignoring the effect of their generative AI, this is misleading
use of (own) research with little evidence
hidden emissions through clever bookkeeping (often leaving out Scope 3 or ‘embodied’ emissions)
empty promises, like pointing at technologies that don't exist yet
downplaying via selective shopping in data or data without context
fatalism: “we'll reach those sustainability goals anyway, why bother trying”
When you do get data, it often does not include Scope 3 emissions, which are estimated to be a very large part (I've seen percentages from 30 to 89%, and I am not sure what's right, other than that it is large).
There can also be a major difference in reporting: some companies do location-based reporting, others market-based reporting. Location-based means that you get information about how much a specific data centre is actually using, whereas with market-based, factors outside are taken into account, including certificates for carbon.
Location-based data is the most helpful if your team is trying to make optimisations, because it allows them to see the numbers go down (or up),where they would appear constant with market-based reports.
Lastly, I mentioned grid intensity: because there are many different power sources, and they deliver different amounts of energy depending on the time and location, grid intensity vary. For instance, if it's sunny and windy today at noon, the grid intensity will be low because there is lots of green energy available. At other times there's less.
Your application can use this difference, that constantly changes, by moving your computing to the right place at the right time. This is also called “carbon aware computing” and companies like Google already do it, to save emissions and costs at the same time.
Summing up
AI-related electricity usage, water use, and carbon emissions can be huge. That's a problem, but it's also an opportunity (cheesy but it's true). There is lots of low-hanging fruit that we can start addressing. As there's still so much to reduce, our efforts really can make a dent.
I really enjoyed giving this talk and hearing the audience comments afterwards. The main worry seems to be: how do I sell this within my organisation, and an answer emerged in the group: cost-savings and carbon-savings often go hand in hand.
For years, users and many companies have been complaining about cookie banners. Even though this understandable frustration is mostly caused by misleading dark patterns used by the industry, these banners have become the symbol of what is perceived as excessive EU regulation. As part of the ‘Digital Omnibus’, the European Commission now finally wanted to get rid of cookie banners and replace them with an automated signal. However, Google and some of the very EU Member States that are actually calling on the EU to “simplify” and “cut red tape” – including Germany and France, for example – are now standing in the way. In the Council’s latest position paper of 18 June, the plan to abolish the cookie banner has been scrapped. This baffling outcome is likely to continue to cost European users a great deal of hassle, frustration and billions of clicks per year.
“Dark patterns” and annoyance until the right result. In Europe, users cannot simply be tracked. Both online and offline, there is a fundamental right to data protection – including on Meta’s or Google’s platforms, as well as on websites full of tracking adverts. Companies must therefore ask each individual for their consent – or simply leave them in peace. This is done via so-called cookie banners, whereby consent is not only sought for cookies, but usually also for the sharing of data with often thousands of third-party companies. Users should actually have the option here to consent only if they wish to be tracked online of their own free will. Depending on the study, only around 3–10% of people want this. However, through so-called dark patterns (e.g. hidden ‘No’ buttons or pre-ticked consent boxes), the tracking industry achieves consent rates of up to 90%.
With more than 450 million people in the EU, this farce generates several billion (!) clicks a year, causes frustration and is a complete waste of time for consumers – whilst tech giants and the tracking industry rake in billions in profits through “voluntary” tracking. At the same time, it is becoming increasingly clear that the massive harvesting of personal data also poses risks to security and democracy.
Max Schrems: “Cookie banners are not an invention of data protection, but of the tracking industry. Without consent, there is no snooping online. Now there are fears that a simpler way of saying ‘yes’ or ‘no’ will result in a loss of revenue for Google and the like. That is why the tracking industry is currently lobbying as hard as it can to keep the cookie banner. Clearly, it wants to retain the ability to directly manipulate users’ choices.”
The EU's proposal: an automatic signal. In autumn 2025, the European Commission proposed replacing cookie banners with an automated signal that would communicate cookie consent preferences between the device, the user and websites. Even in California – the home state of most tech companies – a similar solution is already in place. Various proposals adapted to EU law have also been around for some time. The EU proposal is actually significantly less radical than the laws in the US because it still allows for consent to be given on a per-website basis. Specifically, the newly proposed Article 88b GDPR would have provided the solution and was a simple example of how reducing red tape can succeed whilst simultaneously benefiting consumers and fair businesses.
Max Schrems: “Browsers already automatically communicate which language I prefer. It’s just as easy to indicate digitally whether you want to be tracked. Technically, this is straightforward and is even enshrined in law in some US states. There are actually a number of technical solutions that could be introduced tomorrow. Europe is lagging completely behind with these antiquated banners. Absurdly, however, Google and the tracking industry want to make it as difficult as possible for people.”
The “Google Paper” and an avalanche of misinformation. However, a secret lobbying paper from Google has thrown a spanner in the works for the European Commission. Using completely far-fetched figures, it argues that without cookie banners, all online advertising would come to a standstill. Google is exaggerating wildly here and assumes there is a central ‘kill switch’ for all advertising. Yet the European Commission has explicitly made it clear that consent should still be possible on a per-website and per-purpose basis. It would therefore be possible to grant consent to quality media outlets in particular – and to withhold it from Google, Meta and the like. Google conveniently ‘overlooks’ this. Particularly absurd is Google’s argument that quality media outlets would suffer from the abolition of cookie banners. Media outlets are exempt from the provision and would therefore not be affected at all.
Germany, France and others are now in favour of (!) the cookie banner. However absurd and transparent the arguments of the tracking lobby may be, they seem to have had the intended effect. In the proposal for a final vote in the Council, Article 88b was removed entirely from the Digital Omnibus – and with it, the only measure that would actually have simplified things for consumers. Countries such as Germany, France and Poland had demanded this in advance – presumably following massive pressure from the tracking lobby.
Max Schrems: “You really have to let that sink in: the European Commission finally wants to get rid of cookie banners, but Google and some EU Member States are now determined to keep them. For decades, people have been complaining about EU bureaucracy. But in reality, the tracking industry is so terrified of consumers being able to simply say ‘no’ that, after a bit of lobbying, everyone gives in. It really does raise the question of whether some Member States are primarily representing their voters or the lobbyists.”
The European Parliament has not yet taken a position. The ‘Digital Omnibus’ is currently still the subject of parallel negotiations in the Council and the European Parliament, although the latter has not yet made its position on Article 88b known. At the end of the negotiations, the two institutions will then have to reach a compromise. It is therefore essential that the European Parliament now advocates for the retention of Article 88b. However, here too, the conservative EPP is likely to tip the balance, as it is also under pressure from the tracking lobby.
Max Schrems: “In a democracy, what the majority of people want should actually happen – in this case, getting rid of cookie banners. If decision-makers prefer to follow the will of the tech lobby rather than that of their voters, then something is very, very wrong here."
Super El Niño, que ça vous serve de leçon, l’amour ne se négocie pas, et la guerre des émeus.
Il semblerait que j’ai passé cette semaine à profiter du temps extérieur avant qu’il ne devienne empiriquement infernal : je me suis occupé du jardin avec amour, j’ai chanté (beaucoup), j’ai déambulé et marché, j’ai vu des copain·es. Bref, du temps loin des claviers, c’est pas plus mal non plus 😊️
kresus : quelques relectures avant de sortir une nouvelle version 👀️
auto-hébergement : mise à jour de Mastodon vers la dernière version, qui contient des nouveautés qui me semblent bien sympas, notamment la possibilité de s’abonner par courriel aux micro-posts d’un compte !
Écoutez, c’est peut-être pas le meilleur moment pour être anxieux par rapport au climat, mais j’ai regardé cette vidéo qui expliquait ce que c’était le « phénomène El Niño » dont on n’arrête pas d’entendre parler, et pourquoi il était amplifié par / amplifiait les effets du réchauffement climatique.
Fini Que ça vous serve de leçon, et j’ai kiffé jusqu’au bout ! Encore une fois, ce ne sont pas des pratiques désirables, mais ça défoule l’imaginaire.
Fini la saison 1 de Man on the inside (Espion à l’ancienne), et cette première saison était vraiment chou ! Ça parle très tendrement de vieillesse, d’Alzeihmer et de solitude. J’ai commencé la deuxième saison qui se passe dans une université, et hum pour le moment pas très emballé, mais je disais sensiblement la même chose pour la première saison la semaine dernière, alors je lui laisse une chance !
Un épisode assez marrant et absurde de l’histoire de l’Australie, la guerre des émeus, des gros oiseaux un peu comme des autruches. Eh bien, croyez-le ou pas, mais l’armée australienne a perdu.
Tout le monde connaît Wikipédia. Mais connaissez-vous Wikidata ?
Wikidata fait partie de la longue liste de projets gérés par la Fondation Wikimedia, au même titre que Wikipédia, Wikimedia Commons ou Wiktionnaire. Là où Wikipédia stocke de la connaissance sous forme de texte, donc de donnée non structurée, Wikidata fait exactement l'inverse : il stocke et expose des entités liées entre elles. Cela revient à construire un immense graphe de connaissance, dans lequel chaque personne, organisation, lieu ou concept est relié aux autres par des attributs lisibles par une machine.
Wikidata, qu'est-ce que c'est exactement ?
Wikidata est une base de connaissance libre, collaborative et multilingue. Chaque entité y porte un identifiant unique : un Q pour les éléments (Q42 pour Douglas Adams, par exemple) et un P pour les propriétés (P50 pour l'auteur, P19 pour le lieu de naissance). En assemblant ces briques, on obtient des affirmations du type sujet, prédicat, objet : ce que le monde de la donnée appelle un triplet RDF.
Le volume donne le vertige. Wikidata dépassait déjà 1,5 milliard de triplets sémantiques à la mi-2024 [1]. Et toute cette donnée n'est pas seulement consultable à la main : elle est interrogeable par requête, via un point d'accès SPARQL public [2]. On peut ainsi demander « tous les écrivains français nés à Nantes » et obtenir une réponse exploitable, là où une recherche classique ne renverrait qu'une liste de pages à lire.
#!/usr/bin/env bash
# Liste les écrivains nés à Nantes via le point d'accès SPARQL de Wikidata.
# Dépendances : curl et jq.

ENDPOINT="https://query.wikidata.org/sparql"

# Q5 = être humain, P106 = occupation, Q36180 = écrivain,
# P19 = lieu de naissance, Q12191 = Nantes.
QUERY='SELECT ?ecrivain ?ecrivainLabel WHERE {
  ?ecrivain wdt:P31 wd:Q5 ;
            wdt:P106 wd:Q36180 ;
            wdt:P19 wd:Q12191 .
  SERVICE wikibase:label { bd:serviceParam wikibase:language "fr,en". }
}
ORDER BY ?ecrivainLabel'

# Wikimedia impose un User-Agent descriptif, sous peine de blocage (HTTP 429).
curl -s -G "$ENDPOINT" \
  --data-urlencode "query=$QUERY" \
  -H "Accept: application/sparql-results+json" \
  -H "User-Agent: Geeek-demo/1.0 (https://www.geeek.org)" \
  | jq -r '.results.bindings[].ecrivainLabel.value'
Comment fonctionne Wikidata ?
Sur le fond, Wikidata est une base de données orientée graphe, alimentée par des contributeurs et des imports automatisés. Sa logique n'est pas isolée : elle appartient à la même famille que les données structurées que l'on retrouve aujourd'hui sur une majorité de pages Web, ces blocs JSON-LD qui décrivent un article, une FAQ ou une organisation au format Schema.org.
C'est le même esprit, celui du Linked Open Data : décrire le monde de façon explicite pour que les machines le comprennent sans deviner. Quand vous injectez un JSON-LD sur l'une de vos pages, comme je l'ai détaillé dans mon article sur les microdonnées FAQ en JSON-LD, vous appliquez cette logique à l'échelle d'une page. Wikidata l'applique à l'échelle de la connaissance mondiale.
Pourquoi les LLM apprécient autant Wikidata ?
Pour construire un modèle de langage, il faut de la connaissance, et surtout de la connaissance de haute qualité si l'on veut limiter les hallucinations au moment des requêtes. Or la donnée disponible sur Internet est partout : sites de presse, blogs, forums, dépôts de code comme GitHub pour le monde informatique, et bases ouvertes comme Wikipédia pour la connaissance du monde.
Chaque source possède un niveau de fiabilité différent. Un modèle considérera spontanément une fiche Wikipédia comme plus solide qu'un message de forum. Wikidata pousse ce raisonnement un cran plus loin : la donnée y est non seulement fiable, mais déjà structurée et reliée. Pour un LLM, c'est la différence entre lire un paragraphe et consulter une fiche prête à l'emploi.
Trois usages expliquent cet engouement :
Wikidata alimente le Knowledge Graph de Google, donc les fameux encarts de connaissance affichés à droite des résultats [3].
Wikidata figure parmi les bases de connaissances ouvertes les plus réutilisées pour entraîner et ancrer les modèles de langage [4]. Une entité bien décrite y a davantage de chances d'être reconnue, correctement attribuée et citée avec assurance.
Wikidata est interrogeable en direct par les agents, via SPARQL, pour aller chercher un fait vérifié au lieu de le reconstituer de mémoire.
Vous comprenez pourquoi cette base pèse lourd dans une stratégie de Generative Engine Optimization (GEO). Être présent et bien décrit dans Wikidata, c'est exister proprement dans l'écosystème qui nourrit l'IA, et cela d'un seul coup pour de nombreux systèmes à la fois.
Tout le monde peut-il entrer dans Wikidata ?
C'est là que je m'étais trompé. Je pensais au départ que Wikidata était au moins aussi sélectif que Wikipédia, et qu'une « notoriété publique » était indispensable. En réalité, c'est l'inverse : les critères d'admissibilité de Wikidata sont volontairement plus souples [5].
Un élément est accepté dès lors qu'il remplit au moins un de ces trois critères :
Il possède un lien valide vers une page d'un projet Wikimedia (un article Wikipédia dans n'importe quelle langue, une catégorie Commons, une page Wikisource, etc.). Si vous disposez déjà d'une fiche Wikipédia, même dans une langue exotique, vous êtes automatiquement admissible.
Il désigne une entité clairement identifiable, matérielle ou conceptuelle, que l'on peut décrire à l'aide de sources sérieuses et publiquement accessibles. C'est le critère le plus accessible, et celui que remplissent la plupart des personnes et organisations. Les identifiants délivrés par des tiers faisant autorité (VIAF, ISNI, identifiant BnF, GND, registres officiels) renforcent fortement cette admissibilité. Attention toutefois : un identifiant que l'on alimente soi-même, comme un ORCID, constitue un signal beaucoup plus faible aux yeux des administrateurs.
Il répond à un besoin structurel, c'est-à-dire qu'il rend plus utiles les affirmations portées par d'autres éléments. L'auteur d'un ouvrage référencé, le développeur d'un logiciel notable ou le membre d'une organisation connue entre dans cette catégorie.
La barre est donc plus proche de « existence vérifiable » que de « célébrité ». Deux nuances méritent toutefois d'être posées clairement. D'abord, le critère 2 reste volontairement flou, au point de faire l'objet de discussions de réforme au sein de la communauté [6]. Ensuite, et c'est le point important, l'auto-promotion est explicitement découragée. Créer soi-même son propre élément relève du conflit d'intérêts [7], et un élément sans la moindre source finit supprimé. L'admissibilité large ne signifie pas absence de garde-fous.
Mon retour d'expérience
Je ne vais pas vous faire la leçon, car je me suis pris ce mur en pleine figure. J'ai tenté de créer ma propre entité Wikidata, ainsi que celle du blog. Quelques jours plus tard, un administrateur (Madamebiblio) a supprimé les deux fiches indiquant que celles-ci ne répondent pas aux exigences de notabilité [5:1].
Avec le recul, le verdict était écrit d'avance, et il illustre exactement les garde-fous décrits plus haut. En créant moi-même ces éléments, je me plaçais d'emblée en situation de conflit d'intérêts, ce que la communauté décourage explicitement. Et mes fiches manquaient de ce qui fait tenir un élément : non pas mes propres profils ou mon propre site, mais des sources indépendantes et des identifiants d'autorité délivrés par des tiers. Un ORCID que l'on remplit soi-même ne prouve rien aux yeux d'un administrateur. Une notice BnF ou VIAF, générée parce qu'une bibliothèque a catalogué un ouvrage publié, pèse infiniment plus lourd. La leçon est claire : sur Wikidata, on ne décrète pas sa propre notoriété, on la laisse se constater par des traces externes que l'on ne contrôle pas.
Conclusion
Wikidata est sans doute l'un des projets les plus sous-estimés de la galaxie Wikimedia. Invisible pour le grand public, il est pourtant devenu une couche d'infrastructure essentielle : il structure la connaissance, alimente les moteurs de recherche et nourrit les modèles de langage. Pour quiconque travaille la visibilité de ses contenus à l'ère de l'IA, comprendre Wikidata n'est plus une curiosité d'érudit, c'est un sujet de fond.
Estimation de mi-2024, en croissance constante depuis. Les compteurs à jour (nombre d'éléments et de triplets) figurent sur la page Wikidata:Statistics. ↩︎
Google a fermé Freebase, qui alimentait historiquement son Knowledge Graph, et en a migré les données vers Wikidata à partir de 2015. Voir Thomas Pellissier Tanon et al., « From Freebase to Wikidata: The Great Migration », WWW 2016, ainsi que la fiche Freebase : https://en.wikipedia.org/wiki/Freebase_(database)↩︎
Wikidata est régulièrement citée parmi les bases ouvertes réutilisées pour entraîner ou ancrer les modèles. La composition précise des corpus d'entraînement reste cependant rarement documentée publiquement par les laboratoires. ↩︎
Using SEO (search engine optimization) to justify accessibility was only ever a technique for bosses or clients or stakeholders who see accessibility as a cost center and are typically driven more by dashboards or money. Ideally, you want to get past that ASAP to drive better outcomes for humans, not SERPs (search engine results pages). I get it as a foot-in-the-door tactic — hopefully it goes no further.
But SEO also drove bad accessibility practices, such as alt text keyword stuffing, low-contrast text, verbose headings, link text built around keywords, gratuitous landing pages, and more. Karl does a good job of demonstrating how little SEO and accessibility are connected. As such, I’ve always been wary of companies pitching accessibility and SEO in their marketing.
Now I see companies pitching accessible & “AI-ready” or “agent friendly” work, often still including SEO. I’m calling foul.
We’ve already seen anti-user guidance from LLM companies asking for their notion of accessible sites. Never mind that these PhD-level genius LLM tools can’t handle a general site most kids navigate with ease. Let’s ignore the failure of that technology and instead start slapping misunderstood ARIA attributes on all our pages instead.
Sure, there’s overlap between SEO and LLM-thieving. SEO and accessibility even have slight overlap. But accessibility is about people. Twisting a human affordance to feed these corporate efforts to make humans redundant (among all the other harms) is a signal. Different people will read that signal in different ways. If it sells work and you still focus on humans first, cool.
But to me that signal says you aren’t serious about the work. That your TESCREAL patch is just waiting to get sewn on. I’m trying to be less absolutist, less black-and-white. But boy is it hard given what I see every time I peel back the veneer.
Hi, just me heading off some bad advice I’m starting to see in developer venues.
Background
The proposed Document Outline Algorithm, where headings would automatically reset themselves to the appropriate level based on their position in the DOM structure, was never part of a final HTML specification. It was quickly proven to be unworkable; brief support in JAWS demonstrated that. You can read the tortured history (and a JAWS support demo) in my 2016 post There Is No Document Outline Algorithm.
In 2019 WHATWG worked to resurrect <hgroup>, partly in a novel effort to try to resurrect the Document Outline Algorithm. In the end, even that effort was futile. <hgroup> came back, but it came back as a grouping element only. The only impact it has on heading structures is that browser could, if they really wanted, ignore other headings in the same <hgroup>.
Authors very much want to make the browser decide heading levels for them. Authors also very much continue to write content and HTML structures that make that impossible.
So I wasn’t surprised when Firefox’s recent announcement of headingoffset support coming to Firefox behind a flag resulted in many cheering the “return” (irony quotes) of the Document Outline Algorithm.
But it isn’t.
headingoffset
The headingoffset attribute lets authors offset heading levels for descendants of a given node.
So if you have, say a dialog that starts at <h2>, you could add headingoffset="2" and then let it pull in (server-side or via your preferred user-slowing front-end tooling) another page that uses <h1> as its first heading, you can be comfortable knowing that <h1> will be treated as <h3> in the accessibility tree.
This can be handy for content re-use without authors needing to make every heading a variable or burning down the DOM each time to forcibly re-write them.
But it’s still the author’s job to make an intentional and good decision. The browser will know nothing more about your content or structure than it did before. And it certainly doesn’t reduce WCAG risk.
Other useful nuggets:
headingoffset values must be valid non-negative integers.
headingoffset values must be between 0 and 8.
headingoffset values greater than 8 are specified to max at level 9, but existing bugs may impact that.
Other invalid headingoffset values should fall back to level 2, but again, bugs and implementation decisions wil impact that.
headingreset is a boolean attribute that tells browsers to ignore headingoffset for that node and its descendants.
Do not use headingoffset until you can confirm support for the computed heading level in your target audience browser.
Recap
headingoffset is not the (nor any) Document Outline Algorithm, nor does it replicate it.
headingoffset requires the author to make decisions based on content.
Until JAWS and TalkBack fix existing bugs, probably don’t do / allow any heading levels higher than 6.
Don’t do / allow any heading levels higher than 9.
If you are hoping headingoffset will resolve your heading level problems in a hands-off way with imported or user-generated content, you may end up creating confusion and WCAG risk.
Do not try to use headingoffset to try to recreate the Document Outline Algorithm.
Related
Not a ton of detail in this post, but at 500 words if you want more then here are some resources beyond what I linked:
Après une semaine sans aucune sortie Marmots, les affaires reprennent et les jeux qui arrivent sentent bon l’été et les vacances… Les voyages en montgolfière et les barbecues… Les fiestas dans la jungle et les… trucs colorés à assembler. Décidément, certains ont des occupations bizarres en vacances.
Bonne semaine ludique avec vos Marmots !
Panorama
Jules Messaud & Melody Leblond
Melody Leblond
Scorpion Masqué
2 à 4 joueurs
8 ans et plus
Pose de tuiles
Voyagez en montgolfière pour récupérer les meilleures tuiles et former le plus beau des panoramas. Des mécaniques simplissimes, des illustrations toutes choupis et le plaisir simple d’assembler ses tuiles : « Panorama » est un jeu qui invite toute la famille autour de la table, joueurs comme non joueurs…
« Très Futé Kids » revient pour un nouvel opus. Après avoir préparé un goûter d’anniversaire dans la première boîte, organisez la plus belle fiesta dans la jungle. À votre tour, lancez les dés, choisissez ceux d’une couleur, laissez les autres à vos adversaires, et cochez les meilleurs emplacements pour gagner un maximum d’étoiles colorées.
Le trouver chez
Kumi Kumi
Toshiki Sato
(non crédité)
Miraludo
2 à 4 joueurs
5 ans et plus
Observation/Rapidité
Dans « Kumi Kumi », soyez le plus rapide à reproduire une grille colorée, en combinant et en superposant des tuiles. Celles-ci sont composées de 2 calques de couleurs primaires, et c’est en les superposant que vous obtenez les couleurs secondaires (par exemple : Bleu + Jaune = Vert).
Le trouver chez
Miro Miro
Toru & Aiko Oyama
(non crédité)
Miraludo
2 à 6 joueurs
6 ans et plus
Observation/Estimation
Autre jeu japonais dans la même gamme que « Kumi Kumi », « Miro Miro » est bien plus abstrait abstrait pour les Marmots. Estimez la surface colorée d’une carte référence, en la comparant à toutes celles visibles sur la table. Celui qui choisit la carte qui contient la surface colorée la plus proche remporte la manche.
Le trouver chez
Barbecubes
Brett J. Gilbert & Rob Sparks
Rory Muldoon
Matagot
2 à 6 joueurs
8 ans et plus
Jeu d’adresse
Dans « Barbecubes », vous posez des saucisses et du poisson sur un barbecue. Sauf que les saucisses sont des jetons en pixel art, que le barbecue est fait de buchettes en bois et que c’est avec une petite pince que vous allez tenter de ne rien faire tomber dans les flammes.

 Connexion