For years, users and many companies have been complaining about cookie banners. Even though this understandable frustration is mostly caused by misleading dark patterns used by the industry, these banners have become the symbol of what is perceived as excessive EU regulation. As part of the ‘Digital Omnibus’, the European Commission now finally wanted to get rid of cookie banners and replace them with an automated signal. However, Google and some of the very EU Member States that are actually calling on the EU to “simplify” and “cut red tape” – including Germany and France, for example – are now standing in the way. In the Council’s latest position paper of 18 June, the plan to abolish the cookie banner has been scrapped. This baffling outcome is likely to continue to cost European users a great deal of hassle, frustration and billions of clicks per year.
“Dark patterns” and annoyance until the right result. In Europe, users cannot simply be tracked. Both online and offline, there is a fundamental right to data protection – including on Meta’s or Google’s platforms, as well as on websites full of tracking adverts. Companies must therefore ask each individual for their consent – or simply leave them in peace. This is done via so-called cookie banners, whereby consent is not only sought for cookies, but usually also for the sharing of data with often thousands of third-party companies. Users should actually have the option here to consent only if they wish to be tracked online of their own free will. Depending on the study, only around 3–10% of people want this. However, through so-called dark patterns (e.g. hidden ‘No’ buttons or pre-ticked consent boxes), the tracking industry achieves consent rates of up to 90%.
With more than 450 million people in the EU, this farce generates several billion (!) clicks a year, causes frustration and is a complete waste of time for consumers – whilst tech giants and the tracking industry rake in billions in profits through “voluntary” tracking. At the same time, it is becoming increasingly clear that the massive harvesting of personal data also poses risks to security and democracy.
Max Schrems: “Cookie banners are not an invention of data protection, but of the tracking industry. Without consent, there is no snooping online. Now there are fears that a simpler way of saying ‘yes’ or ‘no’ will result in a loss of revenue for Google and the like. That is why the tracking industry is currently lobbying as hard as it can to keep the cookie banner. Clearly, it wants to retain the ability to directly manipulate users’ choices.”
The EU's proposal: an automatic signal. In autumn 2025, the European Commission proposed replacing cookie banners with an automated signal that would communicate cookie consent preferences between the device, the user and websites. Even in California – the home state of most tech companies – a similar solution is already in place. Various proposals adapted to EU law have also been around for some time. The EU proposal is actually significantly less radical than the laws in the US because it still allows for consent to be given on a per-website basis. Specifically, the newly proposed Article 88b GDPR would have provided the solution and was a simple example of how reducing red tape can succeed whilst simultaneously benefiting consumers and fair businesses.
Max Schrems: “Browsers already automatically communicate which language I prefer. It’s just as easy to indicate digitally whether you want to be tracked. Technically, this is straightforward and is even enshrined in law in some US states. There are actually a number of technical solutions that could be introduced tomorrow. Europe is lagging completely behind with these antiquated banners. Absurdly, however, Google and the tracking industry want to make it as difficult as possible for people.”
The “Google Paper” and an avalanche of misinformation. However, a secret lobbying paper from Google has thrown a spanner in the works for the European Commission. Using completely far-fetched figures, it argues that without cookie banners, all online advertising would come to a standstill. Google is exaggerating wildly here and assumes there is a central ‘kill switch’ for all advertising. Yet the European Commission has explicitly made it clear that consent should still be possible on a per-website and per-purpose basis. It would therefore be possible to grant consent to quality media outlets in particular – and to withhold it from Google, Meta and the like. Google conveniently ‘overlooks’ this. Particularly absurd is Google’s argument that quality media outlets would suffer from the abolition of cookie banners. Media outlets are exempt from the provision and would therefore not be affected at all.
Germany, France and others are now in favour of (!) the cookie banner. However absurd and transparent the arguments of the tracking lobby may be, they seem to have had the intended effect. In the proposal for a final vote in the Council, Article 88b was removed entirely from the Digital Omnibus – and with it, the only measure that would actually have simplified things for consumers. Countries such as Germany, France and Poland had demanded this in advance – presumably following massive pressure from the tracking lobby.
Max Schrems: “You really have to let that sink in: the European Commission finally wants to get rid of cookie banners, but Google and some EU Member States are now determined to keep them. For decades, people have been complaining about EU bureaucracy. But in reality, the tracking industry is so terrified of consumers being able to simply say ‘no’ that, after a bit of lobbying, everyone gives in. It really does raise the question of whether some Member States are primarily representing their voters or the lobbyists.”
The European Parliament has not yet taken a position. The ‘Digital Omnibus’ is currently still the subject of parallel negotiations in the Council and the European Parliament, although the latter has not yet made its position on Article 88b known. At the end of the negotiations, the two institutions will then have to reach a compromise. It is therefore essential that the European Parliament now advocates for the retention of Article 88b. However, here too, the conservative EPP is likely to tip the balance, as it is also under pressure from the tracking lobby.
Max Schrems: “In a democracy, what the majority of people want should actually happen – in this case, getting rid of cookie banners. If decision-makers prefer to follow the will of the tech lobby rather than that of their voters, then something is very, very wrong here."
Super El Niño, que ça vous serve de leçon, l’amour ne se négocie pas, et la guerre des émeus.
Il semblerait que j’ai passé cette semaine à profiter du temps extérieur avant qu’il ne devienne empiriquement infernal : je me suis occupé du jardin avec amour, j’ai chanté (beaucoup), j’ai déambulé et marché, j’ai vu des copain·es. Bref, du temps loin des claviers, c’est pas plus mal non plus 😊️
kresus : quelques relectures avant de sortir une nouvelle version 👀️
auto-hébergement : mise à jour de Mastodon vers la dernière version, qui contient des nouveautés qui me semblent bien sympas, notamment la possibilité de s’abonner par courriel aux micro-posts d’un compte !
Écoutez, c’est peut-être pas le meilleur moment pour être anxieux par rapport au climat, mais j’ai regardé cette vidéo qui expliquait ce que c’était le « phénomène El Niño » dont on n’arrête pas d’entendre parler, et pourquoi il était amplifié par / amplifiait les effets du réchauffement climatique.
Fini Que ça vous serve de leçon, et j’ai kiffé jusqu’au bout ! Encore une fois, ce ne sont pas des pratiques désirables, mais ça défoule l’imaginaire.
Fini la saison 1 de Man on the inside (Espion à l’ancienne), et cette première saison était vraiment chou ! Ça parle très tendrement de vieillesse, d’Alzeihmer et de solitude. J’ai commencé la deuxième saison qui se passe dans une université, et hum pour le moment pas très emballé, mais je disais sensiblement la même chose pour la première saison la semaine dernière, alors je lui laisse une chance !
Un épisode assez marrant et absurde de l’histoire de l’Australie, la guerre des émeus, des gros oiseaux un peu comme des autruches. Eh bien, croyez-le ou pas, mais l’armée australienne a perdu.
Tout le monde connaît Wikipédia. Mais connaissez-vous Wikidata ?
Wikidata fait partie de la longue liste de projets gérés par la Fondation Wikimedia, au même titre que Wikipédia, Wikimedia Commons ou Wiktionnaire. Là où Wikipédia stocke de la connaissance sous forme de texte, donc de donnée non structurée, Wikidata fait exactement l'inverse : il stocke et expose des entités liées entre elles. Cela revient à construire un immense graphe de connaissance, dans lequel chaque personne, organisation, lieu ou concept est relié aux autres par des attributs lisibles par une machine.
Wikidata, qu'est-ce que c'est exactement ?
Wikidata est une base de connaissance libre, collaborative et multilingue. Chaque entité y porte un identifiant unique : un Q pour les éléments (Q42 pour Douglas Adams, par exemple) et un P pour les propriétés (P50 pour l'auteur, P19 pour le lieu de naissance). En assemblant ces briques, on obtient des affirmations du type sujet, prédicat, objet : ce que le monde de la donnée appelle un triplet RDF.
Le volume donne le vertige. Wikidata dépassait déjà 1,5 milliard de triplets sémantiques à la mi-2024 [1]. Et toute cette donnée n'est pas seulement consultable à la main : elle est interrogeable par requête, via un point d'accès SPARQL public [2]. On peut ainsi demander « tous les écrivains français nés à Nantes » et obtenir une réponse exploitable, là où une recherche classique ne renverrait qu'une liste de pages à lire.
#!/usr/bin/env bash
# Liste les écrivains nés à Nantes via le point d'accès SPARQL de Wikidata.
# Dépendances : curl et jq.

ENDPOINT="https://query.wikidata.org/sparql"

# Q5 = être humain, P106 = occupation, Q36180 = écrivain,
# P19 = lieu de naissance, Q12191 = Nantes.
QUERY='SELECT ?ecrivain ?ecrivainLabel WHERE {
  ?ecrivain wdt:P31 wd:Q5 ;
            wdt:P106 wd:Q36180 ;
            wdt:P19 wd:Q12191 .
  SERVICE wikibase:label { bd:serviceParam wikibase:language "fr,en". }
}
ORDER BY ?ecrivainLabel'

# Wikimedia impose un User-Agent descriptif, sous peine de blocage (HTTP 429).
curl -s -G "$ENDPOINT" \
  --data-urlencode "query=$QUERY" \
  -H "Accept: application/sparql-results+json" \
  -H "User-Agent: Geeek-demo/1.0 (https://www.geeek.org)" \
  | jq -r '.results.bindings[].ecrivainLabel.value'
Comment fonctionne Wikidata ?
Sur le fond, Wikidata est une base de données orientée graphe, alimentée par des contributeurs et des imports automatisés. Sa logique n'est pas isolée : elle appartient à la même famille que les données structurées que l'on retrouve aujourd'hui sur une majorité de pages Web, ces blocs JSON-LD qui décrivent un article, une FAQ ou une organisation au format Schema.org.
C'est le même esprit, celui du Linked Open Data : décrire le monde de façon explicite pour que les machines le comprennent sans deviner. Quand vous injectez un JSON-LD sur l'une de vos pages, comme je l'ai détaillé dans mon article sur les microdonnées FAQ en JSON-LD, vous appliquez cette logique à l'échelle d'une page. Wikidata l'applique à l'échelle de la connaissance mondiale.
Pourquoi les LLM apprécient autant Wikidata ?
Pour construire un modèle de langage, il faut de la connaissance, et surtout de la connaissance de haute qualité si l'on veut limiter les hallucinations au moment des requêtes. Or la donnée disponible sur Internet est partout : sites de presse, blogs, forums, dépôts de code comme GitHub pour le monde informatique, et bases ouvertes comme Wikipédia pour la connaissance du monde.
Chaque source possède un niveau de fiabilité différent. Un modèle considérera spontanément une fiche Wikipédia comme plus solide qu'un message de forum. Wikidata pousse ce raisonnement un cran plus loin : la donnée y est non seulement fiable, mais déjà structurée et reliée. Pour un LLM, c'est la différence entre lire un paragraphe et consulter une fiche prête à l'emploi.
Trois usages expliquent cet engouement :
Wikidata alimente le Knowledge Graph de Google, donc les fameux encarts de connaissance affichés à droite des résultats [3].
Wikidata figure parmi les bases de connaissances ouvertes les plus réutilisées pour entraîner et ancrer les modèles de langage [4]. Une entité bien décrite y a davantage de chances d'être reconnue, correctement attribuée et citée avec assurance.
Wikidata est interrogeable en direct par les agents, via SPARQL, pour aller chercher un fait vérifié au lieu de le reconstituer de mémoire.
Vous comprenez pourquoi cette base pèse lourd dans une stratégie de Generative Engine Optimization (GEO). Être présent et bien décrit dans Wikidata, c'est exister proprement dans l'écosystème qui nourrit l'IA, et cela d'un seul coup pour de nombreux systèmes à la fois.
Tout le monde peut-il entrer dans Wikidata ?
C'est là que je m'étais trompé. Je pensais au départ que Wikidata était au moins aussi sélectif que Wikipédia, et qu'une « notoriété publique » était indispensable. En réalité, c'est l'inverse : les critères d'admissibilité de Wikidata sont volontairement plus souples [5].
Un élément est accepté dès lors qu'il remplit au moins un de ces trois critères :
Il possède un lien valide vers une page d'un projet Wikimedia (un article Wikipédia dans n'importe quelle langue, une catégorie Commons, une page Wikisource, etc.). Si vous disposez déjà d'une fiche Wikipédia, même dans une langue exotique, vous êtes automatiquement admissible.
Il désigne une entité clairement identifiable, matérielle ou conceptuelle, que l'on peut décrire à l'aide de sources sérieuses et publiquement accessibles. C'est le critère le plus accessible, et celui que remplissent la plupart des personnes et organisations. Les identifiants délivrés par des tiers faisant autorité (VIAF, ISNI, identifiant BnF, GND, registres officiels) renforcent fortement cette admissibilité. Attention toutefois : un identifiant que l'on alimente soi-même, comme un ORCID, constitue un signal beaucoup plus faible aux yeux des administrateurs.
Il répond à un besoin structurel, c'est-à-dire qu'il rend plus utiles les affirmations portées par d'autres éléments. L'auteur d'un ouvrage référencé, le développeur d'un logiciel notable ou le membre d'une organisation connue entre dans cette catégorie.
La barre est donc plus proche de « existence vérifiable » que de « célébrité ». Deux nuances méritent toutefois d'être posées clairement. D'abord, le critère 2 reste volontairement flou, au point de faire l'objet de discussions de réforme au sein de la communauté [6]. Ensuite, et c'est le point important, l'auto-promotion est explicitement découragée. Créer soi-même son propre élément relève du conflit d'intérêts [7], et un élément sans la moindre source finit supprimé. L'admissibilité large ne signifie pas absence de garde-fous.
Mon retour d'expérience
Je ne vais pas vous faire la leçon, car je me suis pris ce mur en pleine figure. J'ai tenté de créer ma propre entité Wikidata, ainsi que celle du blog. Quelques jours plus tard, un administrateur (Madamebiblio) a supprimé les deux fiches indiquant que celles-ci ne répondent pas aux exigences de notabilité [5:1].
Avec le recul, le verdict était écrit d'avance, et il illustre exactement les garde-fous décrits plus haut. En créant moi-même ces éléments, je me plaçais d'emblée en situation de conflit d'intérêts, ce que la communauté décourage explicitement. Et mes fiches manquaient de ce qui fait tenir un élément : non pas mes propres profils ou mon propre site, mais des sources indépendantes et des identifiants d'autorité délivrés par des tiers. Un ORCID que l'on remplit soi-même ne prouve rien aux yeux d'un administrateur. Une notice BnF ou VIAF, générée parce qu'une bibliothèque a catalogué un ouvrage publié, pèse infiniment plus lourd. La leçon est claire : sur Wikidata, on ne décrète pas sa propre notoriété, on la laisse se constater par des traces externes que l'on ne contrôle pas.
Conclusion
Wikidata est sans doute l'un des projets les plus sous-estimés de la galaxie Wikimedia. Invisible pour le grand public, il est pourtant devenu une couche d'infrastructure essentielle : il structure la connaissance, alimente les moteurs de recherche et nourrit les modèles de langage. Pour quiconque travaille la visibilité de ses contenus à l'ère de l'IA, comprendre Wikidata n'est plus une curiosité d'érudit, c'est un sujet de fond.
Estimation de mi-2024, en croissance constante depuis. Les compteurs à jour (nombre d'éléments et de triplets) figurent sur la page Wikidata:Statistics. ↩︎
Google a fermé Freebase, qui alimentait historiquement son Knowledge Graph, et en a migré les données vers Wikidata à partir de 2015. Voir Thomas Pellissier Tanon et al., « From Freebase to Wikidata: The Great Migration », WWW 2016, ainsi que la fiche Freebase : https://en.wikipedia.org/wiki/Freebase_(database)↩︎
Wikidata est régulièrement citée parmi les bases ouvertes réutilisées pour entraîner ou ancrer les modèles. La composition précise des corpus d'entraînement reste cependant rarement documentée publiquement par les laboratoires. ↩︎
Using SEO (search engine optimization) to justify accessibility was only ever a technique for bosses or clients or stakeholders who see accessibility as a cost center and are typically driven more by dashboards or money. Ideally, you want to get past that ASAP to drive better outcomes for humans, not SERPs (search engine results pages). I get it as a foot-in-the-door tactic — hopefully it goes no further.
But SEO also drove bad accessibility practices, such as alt text keyword stuffing, low-contrast text, verbose headings, link text built around keywords, gratuitous landing pages, and more. Karl does a good job of demonstrating how little SEO and accessibility are connected. As such, I’ve always been wary of companies pitching accessibility and SEO in their marketing.
Now I see companies pitching accessible & “AI-ready” or “agent friendly” work, often still including SEO. I’m calling foul.
We’ve already seen anti-user guidance from LLM companies asking for their notion of accessible sites. Never mind that these PhD-level genius LLM tools can’t handle a general site most kids navigate with ease. Let’s ignore the failure of that technology and instead start slapping misunderstood ARIA attributes on all our pages instead.
Sure, there’s overlap between SEO and LLM-thieving. SEO and accessibility even have slight overlap. But accessibility is about people. Twisting a human affordance to feed these corporate efforts to make humans redundant (among all the other harms) is a signal. Different people will read that signal in different ways. If it sells work and you still focus on humans first, cool.
But to me that signal says you aren’t serious about the work. That your TESCREAL patch is just waiting to get sewn on. I’m trying to be less absolutist, less black-and-white. But boy is it hard given what I see every time I peel back the veneer.
Hi, just me heading off some bad advice I’m starting to see in developer venues.
Background
The proposed Document Outline Algorithm, where headings would automatically reset themselves to the appropriate level based on their position in the DOM structure, was never part of a final HTML specification. It was quickly proven to be unworkable; brief support in JAWS demonstrated that. You can read the tortured history (and a JAWS support demo) in my 2016 post There Is No Document Outline Algorithm.
In 2019 WHATWG worked to resurrect <hgroup>, partly in a novel effort to try to resurrect the Document Outline Algorithm. In the end, even that effort was futile. <hgroup> came back, but it came back as a grouping element only. The only impact it has on heading structures is that browser could, if they really wanted, ignore other headings in the same <hgroup>.
Authors very much want to make the browser decide heading levels for them. Authors also very much continue to write content and HTML structures that make that impossible.
So I wasn’t surprised when Firefox’s recent announcement of headingoffset support coming to Firefox behind a flag resulted in many cheering the “return” (irony quotes) of the Document Outline Algorithm.
But it isn’t.
headingoffset
The headingoffset attribute lets authors offset heading levels for descendants of a given node.
So if you have, say a dialog that starts at <h2>, you could add headingoffset="2" and then let it pull in (server-side or via your preferred user-slowing front-end tooling) another page that uses <h1> as its first heading, you can be comfortable knowing that <h1> will be treated as <h3> in the accessibility tree.
This can be handy for content re-use without authors needing to make every heading a variable or burning down the DOM each time to forcibly re-write them.
But it’s still the author’s job to make an intentional and good decision. The browser will know nothing more about your content or structure than it did before. And it certainly doesn’t reduce WCAG risk.
Other useful nuggets:
headingoffset values must be valid non-negative integers.
headingoffset values must be between 0 and 8.
headingoffset values greater than 8 are specified to max at level 9, but existing bugs may impact that.
Other invalid headingoffset values should fall back to level 2, but again, bugs and implementation decisions wil impact that.
headingreset is a boolean attribute that tells browsers to ignore headingoffset for that node and its descendants.
Do not use headingoffset until you can confirm support for the computed heading level in your target audience browser.
Recap
headingoffset is not the (nor any) Document Outline Algorithm, nor does it replicate it.
headingoffset requires the author to make decisions based on content.
Until JAWS and TalkBack fix existing bugs, probably don’t do / allow any heading levels higher than 6.
Don’t do / allow any heading levels higher than 9.
If you are hoping headingoffset will resolve your heading level problems in a hands-off way with imported or user-generated content, you may end up creating confusion and WCAG risk.
Do not try to use headingoffset to try to recreate the Document Outline Algorithm.
Related
Not a ton of detail in this post, but at 500 words if you want more then here are some resources beyond what I linked:
Après une semaine sans aucune sortie Marmots, les affaires reprennent et les jeux qui arrivent sentent bon l’été et les vacances… Les voyages en montgolfière et les barbecues… Les fiestas dans la jungle et les… trucs colorés à assembler. Décidément, certains ont des occupations bizarres en vacances.
Bonne semaine ludique avec vos Marmots !
Panorama
Jules Messaud & Melody Leblond
Melody Leblond
Scorpion Masqué
2 à 4 joueurs
8 ans et plus
Pose de tuiles
Voyagez en montgolfière pour récupérer les meilleures tuiles et former le plus beau des panoramas. Des mécaniques simplissimes, des illustrations toutes choupis et le plaisir simple d’assembler ses tuiles : « Panorama » est un jeu qui invite toute la famille autour de la table, joueurs comme non joueurs…
« Très Futé Kids » revient pour un nouvel opus. Après avoir préparé un goûter d’anniversaire dans la première boîte, organisez la plus belle fiesta dans la jungle. À votre tour, lancez les dés, choisissez ceux d’une couleur, laissez les autres à vos adversaires, et cochez les meilleurs emplacements pour gagner un maximum d’étoiles colorées.
Le trouver chez
Kumi Kumi
Toshiki Sato
(non crédité)
Miraludo
2 à 4 joueurs
5 ans et plus
Observation/Rapidité
Dans « Kumi Kumi », soyez le plus rapide à reproduire une grille colorée, en combinant et en superposant des tuiles. Celles-ci sont composées de 2 calques de couleurs primaires, et c’est en les superposant que vous obtenez les couleurs secondaires (par exemple : Bleu + Jaune = Vert).
Le trouver chez
Miro Miro
Toru & Aiko Oyama
(non crédité)
Miraludo
2 à 6 joueurs
6 ans et plus
Observation/Estimation
Autre jeu japonais dans la même gamme que « Kumi Kumi », « Miro Miro » est bien plus abstrait abstrait pour les Marmots. Estimez la surface colorée d’une carte référence, en la comparant à toutes celles visibles sur la table. Celui qui choisit la carte qui contient la surface colorée la plus proche remporte la manche.
Le trouver chez
Barbecubes
Brett J. Gilbert & Rob Sparks
Rory Muldoon
Matagot
2 à 6 joueurs
8 ans et plus
Jeu d’adresse
Dans « Barbecubes », vous posez des saucisses et du poisson sur un barbecue. Sauf que les saucisses sont des jetons en pixel art, que le barbecue est fait de buchettes en bois et que c’est avec une petite pince que vous allez tenter de ne rien faire tomber dans les flammes.
Ces astres scintillants lointains, inatteignables, et pourtant, tellement attirants. Mû par cette volonté qui lui a permis d’abattre tous les obstacles depuis la nuit des temps, il inventa des outils pour vaincre la gravité. Il le fit, par une belle journée de décembre 1903, quelque part en Caroline du Nord, narguant les lois de la nature durant une poignée de secondes le temps de voler sur quarante mètres. Qui aurait pu prédire que seulement quelques décennies plus tard, il irait sur la Lune ? À présent, l’Homme avait les yeux rivés sur Mars. Et savait déjà que les étoiles qui le narguaient depuis bien avant l’invention de l’écriture, seraient bientôt siennes.
Alors, bordel, pourquoi son train n’arrivait-il pas à faire Paris-Le Mans ?
Le monde des transports est ainsi : mystérieux. On dit d’ailleurs que c’est en discutant avec une guichetière Gare de l’Est que Lovecraft, jusqu’alors homme raisonnable, inventa Cthulhu. Et si récemment, ledit monde a fait parler de lui, c’est parce que la SNCF, dans un instant de naïveté, tenta d’améliorer la qualité de son offre de voyage en proposant, pour quelques euros de plus, des voitures « sans enfants », où le voyageur fatigué n’aurait pas à supporter les hurlements de Léanon ou l’épisode de la Pat’Patrouille diffusé à plein volume de Matthenzo. Cette affaire, qui a déjà quelques mois, fit trembler l’internet français jusqu’à son dernier Minitel, les uns arguant qu’une société dans laquelle on ne voulait pas voir d’enfants était une société mourante, alors que les autres rétorquaient que c’est Léanon qu’on aurait voulu voir mourante, là, de suite, pourvu qu’elle ferme sa grande bouche.
Maintenant que la poussière des débats est retombée, permettez-moi de vous inviter à prendre un siège, un cigare, et rappeler cette règle simple : en train, le problème, ce ne sont pas les enfants. Non. Le problème…
C’est que c’est peuplé de gigantesques connards.
Et croyez-moi, je m’y connais.
Permettez-moi, riche de ma longue expérience, de vous rappeler que si la Cour des Miracles n’existe plus dans les souterrains de Paris, c’est parce qu’elle a été montée sur roues puis sur rails, enrichissant désormais le quotidien de tous ceux qui n’en demandaient pas tant.
Mais, assez introduit, comme on dit dans les soirées interlopes : passons donc aux cas pratiques.
I – L’errant
Ma proposition de réforme des billets, adaptée à la population des trains.
Il est facile d’identifier les personnes qui ne prennent pas souvent le train. En effet, on les reconnait à leur air surpris lorsque 10 minutes après le départ du train, elles constatent que des gens circulent encore en tous sens en cherchant leur place. Ils n’ont pas connaissance de cette créature maudite des hommes et des dieux : l’errant.
Tout train en a, c’est une sorte d’obligation. Certains suggèrent que cela pourrait être les âmes damnées de voyageurs restés coincés lors d’une grève de Sud-Rail, et qui hantent les lieux pour l’éternité, mais personnellement, je pense à une explication bien plus simple : ces gens sont incroyablement cons.
L’errant n’est en effet pas foutu de comprendre un billet. Pas de le lire, non : de le comprendre.. On le reconnait au fait qu’il débarque toujours dans la mauvaise voiture, et mieux encore, à la mauvaise place, et l’énonce à voix haute avec une candeur qui laisse pantois. Prenons un exemple : vous venez de prendre place dans votre train en direction de Marseille, car vous aimez l’aventure. Vous êtes voiture 3, place 42. Soudain, une voix vous interpelle :
« Bonjour ! C’est ma place.
– Ah bon ? Vous êtes voiture 3, place 42 ?
– Non, je suis voiture 5, place 81. »
L’errant prouve ainsi qu’il sait lire son putain de billet, nardin, mais que par on ne sait quelle logique, il ne fait aucun lien entre le joli numéro qu’il vient de lire dans sa tête et le joli numéro qui s’étale devant ses yeux. Il se contente, tel un bébé devant une table basse, de s’avancer hagard vers le premier coin qui passe, et d’y rencontrer un échec douloureux avant de continuer un peu plus loin. Rappelons que cette créature dont la logique rendrait fou la plupart des scientifiques a le droit de vote : elle ne sait pas lire 3 chiffres sur un billet de train, mais on lui demande son avis sur la gestion du budget de l’Etat.
« Allons, Monsieur Connard ! » s’exclameront les plus audacieux qui ne craignent ni ma pelle, ni le Diego qui est au bout « Ce sont peut-être juste des gens arrivés en retard et qui, montés dans la première voiture, cherchent désormais, encore confus de la course, où s’installer. »
Votre optimisme vous honore, mais l’errant est rude à la tâche, et souhaite bien prouver que son QI est inférieur à son numéro de siège. Ainsi, il aura TOUJOURS remonté le quai trop loin, prouvant que, non, il n’est pas monté dans le train au plus vite. Parfois, il va même marcher 5mn sous la pluie pour aller tout au bout du quai, et montrer que vraiment, il en veut, avant de là, et seulement là, grimper à bord, dégoulinant de toute l’eau d’averse qu’il a accumulée durant son inutile voyage, et commencer seulement à demander « C’est bien la voiture 2 ? » alors que clairement, non, ici c’est la 17, espèce de sombre petit coprolithe, tu aurais pu t’en inquiéter 150m plus tôt, maintenant file, tu sens le chien mouillé.
« Vous exagérez », diront certains. Prouvant ainsi qu’ils ne prennent pas souvent le train, tant le phénomène des errants est si commun que même la SNCF a fini par se demander en termes élégants « Mais bon sang, qu’est-ce qu’ils ne comprennent pas dans « Voiture 5, place 81″ ? ». Et proposé une réforme des billets où il est désormais marqué… « Voiture 5, place 581 ». Non, ça ne risquait pas d’aider. Oui, c’est toujours autant le bordel.
Alors qui êtes-vous, errants ? Pourquoi faites-vous cela ? Pourquoi cherchez-vous encore votre place 25mn après le départ ? Là où des coquins s’enfoncent des objets dans le roudoudou pour égayer le quotidien des urgentistes, avez-vous fait de même avec des crayons de couleur (founis par la SNCF) dans vos narines jusqu’à vous gratter l’intérieur de la boîte crânienne ? Par quel miracle avez-vous atteint l’âge adulte alors que quand on vous dit que la place 81 est du côté du numéro marqué « 81 », vous semblez véritablement vraiment apprendre quelque chose ?
Que de mystères. Et tout autant d’envies de meurtres.
II – Le parfumeur
L’une des rares armes chimiques autorisées par la convention de Genève
Pétomane, passe ton chemin, car il ne sera point question de tes hobbies.
Il convient ici d’éclaircir un autre grand mystère. Sur notre planète, plus de 5 000 végétaux différents peuvent se retrouver dans l’assiette des humains. Ce à quoi il faut ajouter la viande, le lait, les œufs, votre voisin (en cas d’apocalypse) et autres ressources venues de nos amis les animaux (qu’on aime bien, mais plus encore avec de la sauce bourguignonne). Alors, pourquoi ?
Pourquoi, sitôt dans un endroit étroit et clos, mangez-vous TOUJOURS UNE CLÉMENTINE ?
Alors, je n’ai rien contre cet agrume, mais rappelons que frère Clément, lorsqu’il le découvrit, déclara, et je cite « Mais putain, ça veut pas se peler cette merde, et puis raaah, je me fous du jus partout, ça colle. Bon, et pour le goût… mmgnouais, okay, mais cha fais « chkouich chkouich » quand che mords dedans, ch’envois du jus dans tous les chenches, et cha chent chuper fort.« . Comprendre que de nos jours, n’importe qui peut emmener une banane, des amandes ou un steak au poivre, mais non : le peuple mystérieux des transports a une sorte d’addiction pour l’un des rares fruits qui va fouetter dans tout le wagon, transformer la tablette en piscine et potentiellement envoyer du jus jusqu’au voisin qui espérait rester propre jusqu’à son arrivée.
Le parfumeur a donc cette passion secrète : faire que tout un chacun puisse profiter de son repas. Bien sûr, certains feront diversion en me disant « Oui, mais les burgers », « Oui, mais les kebabs »… mais apapap. Le snack est proposé en gare ou devant ses lourdes portes, dur, donc, de reprocher au voyageur du rail d’avoir cédé à son appel (voyez comme je suis généreux). Alors que la clémentine ? C’est parfaitement prémédité. Le parfumeur, chez lui, a contemplé sa cuisine et tout en faisant claquer au sol les sabots qui lui servent de pieds, a choisi le truc qui fouettait le plus à emmener avec lui.
Et ne parlons pas de l’homme qui s’est emporté un petit camembert dont vous me direz des nouvelles, et qui visiblement, a passé un peu trop de temps dans le sac.
Il faut donc être ferme : le parfumeur mérite le respect moins encore que le pétomane précédemment cité. Car ce dernier au moins la décence de ne pas aller acheter des accessoires pour accomplir son sinistre office avant de monter à bord.
III – L’enfant et les parents
Vous et moi savons qu’une partie de la population préférerait, en cas d’accident, sauver leur téléphone plutôt que leur enfant. Notez qu’on est d’accord sur un point : nous aussi on préfère notre téléphone à leur enfant.
Si la SNCF a proposé des voitures sans enfants, n’oublions pas que le vrai problème est plus grand. Et souvent, assis juste à côté : on parle de « parent ».
On reconnait le parent qui va provoquer l’apocalypse au fait qu’il monte dans le train avec un enfant dans une main et un téléphone dans l’autre. Or, en général, il a décidé qu’il n’avait assez d’attention que pour l’un des deux, et son enfant contenant vachement moins de vidéos de chats qui dansent, il a choisi. Noa (sans H) va donc pouvoir briser les vôtres librement, surtout que le parent a en général décidé que pour occuper l’enfant, rien de mieux que de lui donner du rien.
Vous confisqueriez son téléphone et toute distraction au parent pour un voyage de 3 heures, il péterait une durite, mais lui suppose que Noa, pour qui 3h ça va être encore plus long (durée ressentie : 2 jours), devrait bien s’occuper avec, je ne sais pas moi, une tablette SNCF. Toutes les conditions sont donc réunies pour que Noa passe de son état naturel (on parle de « trou du cul ») à son état de voyage (« je suis possédé par Satan »). L’Enfer peut donc ouvrir tout grand ses portes, et les hurlements de mille démons poussés par la minuscule gorge transformer ce qui n’aurait dû être qu’un simple voyage en publicité roulante pour l’autorisation de l’avortement dans les 48 mois après la naissance.
On notera d’ailleurs que le parent n’emmène jamais avec lui un enfant entre 8 et 18 ans, soit l’âge où il peut s’occuper plus ou moins seul. Pourquoi ? Où passent ces enfants ? Par quel miracle est-ce qu’on ne trouve que des bébés et des marmots incontrôlables en bas-âge, et bien évidemment tous atteints de troubles de l’attention et autre hyperactivité (c’est ce que le parent vous dit généralement lorsque vous sortez votre arme pour abattre la bête mugissante ; une curieuse excuse, puisque si la bête souffre, c’est une deuxième bonne raison d’en finir) ? Est-ce que ces gens sont conscients que répéter un vague « Chut » pour la 256e fois ne va pas plus que les 255 fois précédentes arrêter Noa d’imiter le cochon qu’on égorge avec un coupe boulon ? Pourquoi le contrôleur tente-t-il de me maîtriser lorsque je sors mon mauser ? Que d’interrogations sans réponses.
Evidemment, si jamais vous veniez à suggérer du bout des lèvres que mettre le marmot devant un film pourrait le calmer, seules deux choses pourront se passer :
A) On vous expliquera que les écrans, c’est mauvais pour Noa (alors que les possessions sataniques, ça va)
B) S’ils cèdent, ils n’auront pas de casque, vous pourrez donc entendre Dora se demander où elle a encore mis sa carte, et l’envie de répondre sera grande
La SNCF doit donc bien réaliser que le problème n’est pas tant l’enfant, dont tout le monde se moque bien lorsqu’il est occupé à son coloriage dans le cahier d’à côté. Par contre, je suis personnellement prêt à payer un billet plus cher, non pas pour voyager sans marmot, mais pour expédier les géniteurs à Cayenne. Où un adjudant de la Légion Etrangère leur expliquera sa propre vision de « l’éducation positive ».
Toujours est-il que cela nous amène à l’entité maléfique suivante…
IV – Le sans-écouteurs
Le sans-écouteurs, hypocrite, compte sur le fait que les autres mettent leurs écouteurs, sinon il ne pourrait pas entendre ce qui sort de son téléphone.
Lors de la Création, Dieu contempla le monde et vit qu’il était silencieux. Aussi, il créa le son.
Quelqu’un alluma alors du Booba, et Dieu se dit que houlala, merde, j’ai p’têt’ chié dans la colle. Dans sa grande bonté, il créa les écouteurs, permettant à chacun de ne pas avoir à révéler ses goûts discutables à son entourage. De nos jours, les écouteurs sont donc partout, tout le temps, ne coûtent quasiment rien, et toujours moins que les chaussures du type qui n’en a pas (d’écouteurs).
Car s’il est inutile de disserter sur les envies de meurtre avec des objets plus ou moins exotiques que provoque l’apparition d’un sans-écouteurs, il nous faut observer que malgré l’alignement chaotique mauvais de ces trublions, ils respectent scrupuleusement deux règles :
– Le sans-écouteurs a toujours des goûts de merde. Qu’il regarde une vidéo ou écoute de la musique, c’est inévitablement consternant. Preuve en est, personne ne raconte jamais avoir croisé un type qui écoutait de l’opéra sans écouteurs dans le métro, ou profité d’un documentaire sur Winston Churchill dans le RER.
– Plus une personne parle fort au téléphone, moins sa vie est intéressante. Ainsi, le sans-écouteurs fera profiter de toute la voiture de Kenza, tchu chai pas ch’qu’elle a dit ? Ch’te jure. Ch’te jure meuf. Chi, chi. Alors que personne, là encore, n’a croisé de type pilotant une opération à cœur ouvert depuis son mobile.
Dernier point essentiel : le sans-écouteurs étant une créature dégénérée, elle progresse sur cette voie en allant encore plus loin, par exemple en diffusant désormais les messages vocaux qu’elle reçoit, ou mieux encore, en faisant des appels en visio. Car il est évident qu’il est essentiel de diffuser à son interlocuteur l’image de soi-même assis dans un carré SNCF, et de préférence, suffisamment mal cadré pour filmer tous les autres passagers qui regardent vers le sans-écouteurs avec un rictus haineux. Autre règle mystérieuse : l’interlocuteur du sans-écouteurs, probablement du même niveau, sera lui aussi toujours mal cadré et en train de faire autre chose en même temps, prouvant ainsi que cet appel n’avait décidément rien d’urgent.
Attention, si la personne dispose carrément d’une enceinte bluetooth, on ne parle plus de « sans-écouteurs » mais de « gibier pour bagne ».
Evidemment, les trains regorgent de bien d’autres créatures magiques, comme les voyageurs sans billet qui, à l’approche du contrôleur, déploient mille ruses avec une inventivité et une créativité dignes du cinéma français. Autant dire, bien peu, tout cela pour donner un bien triste spectacle que personne n’a envie de voir, mais que les autres devront financer quand même. Mais, cela fait assez de misanthropie pour aujourd’hui.
Nous parlerons donc plus tard des autres cercles de l’enfer des transports, comme lorsqu’il se passe quand, dans la moiteur d’un hangar oublié, un TER s’accouple avec une rame de métro, et que jaillit de cette union monstrueuse un RER B.
Just in time for Google I/O, the Chrome for Developers site announced Modern Web Guidance (MWG):
Modern Web Guidance is a set of evergreen and expert-vetted skills that guide your AI coding agents across many common use cases to build modern web experiences that are accessible, performant, and secure.
I appreciate this set of LLM skills lists accessibility first, something I feel strongly every MVP (or early preview as Google calls this) must:
Simply, if your MVP does not have accessibility factored in, it is not viable. If you claim accessibility is a core principle but your version 0 does not include it, then it is not a core principle.
Last year I made a straightforward and simple request to Google (that also respects the law in most jurisdictions where Google does business):
Please, if your team cannot explain how the thing satisfies all WCAG Success Criteria at Level AA, then don’t release the thing.
Unfortunately, MWG accessibility doesn’t satisfy. Partly because not every pattern has tailored guidance. For example, you may remember when Google ran at a toast pattern before abandoning it:
Again, the people designing the feature neither understood accessibility nor had consulted anyone who did while they designed it, instead relegating accessibility to the later stages of their design and assuming it could simply be remediated with a modest effort and without any serious redesign or rethink.
I hoped Google also remembered and applied that experience here, making a skill tailored to toasts to avoid another debacle. Nope.
Reopening because this guide needs accessibility guidance in some form as there’s no general toast guidance.
But this is an early preview of what developers can do with MWG. It’s not going to cover every pattern. That would be absurd. So let’s look to a pattern Google decided to showcase at launch via this first example prompt on the page:
Create an accordion-style stats component that smoothly animates on open and close.
I expected a pile of <details name> elements, maybe CSS block-size with a JavaScript fallback, probably a couple placeholder images for generic stats, possibly a well-formed table to accompany them, and of course all of it passing WCAG. This is what Antigravity produced with MWG:
Antigravity with MWG went well beyond the prompt, providing a theme switcher, configuration settings, and plenty of calls to Google fonts. But it failed to do what I asked. The animation doesn’t work in Firefox. This despite the promise of baseline / Baseline support and fallbacks:
Progressive Enhancement & Nuanced Fallbacks: We distinguish between purely additive enhancements (like speculative preloading) which are safe to let older browsers silently ignore, and critical behaviors (like dialog controls or network beacons) where we write highly considered, low-overhead fallbacks.
[…]
Baseline-Aware Integration: We leverage real-time compatibility data from the Baseline project so agents can dynamically adapt to current browser support and any browser support preferences.
This is already worrisome given we know that three years on, Baseline still doesn’t really address baseline support:
The relatively new Web Platform Baseline offering does not track browser support for accessibility features built into the web platform. If you need to understand whether browsers support accessibility features as your own base level set of requirements, for legal or other compliance reasons, then Web Platform Baseline does not represent a baseline.
Let’s ignore the non-DRY code, like duplicated HTML text in the script and stringing out the transition instead of using transition-property. Antigravity with MWG didn’t even create a WCAG-conformant example from its own prompt. I found errors within moments. MWG failed its core promises of creating accessible and performant code. Despite its own explicit guidance.
For the first two of these MWG already had guidance, and the a11y skill just wasn’t picked up. Overall activation aside, this highlights the importance of including contextual a11y information.
[…] [W]e should try to have one guide for each common interactive element summarizing and linking/embedding relevant bits of guidance (e.g. tabs, accordions, drawers, etc). The more scattered the use case guidance is, the less likely it is that agents will actually pick up all the pieces.
And there’s the rub. There’s no way to guarantee you’ll get what you ask for, that you won’t get something else, and that these guides — the entire promise of MWG — will be honored. MWG asks authors to trust MWG when using an LLM to code interfaces. But MWG knows its guidance may be ignored:
LLMs are non-deterministic. Even if we do everything right, there is no guarantee any guideline will be used for any given prompt. Even if the relevant guide is picked up, it may not be read fully. Case in point: As you say, MWG already had guidelines for many of these things!
The underlying code generation technology can’t be trusted to follow the rules and the rules aren’t robust enough to blunt that reality.
If your job requires you to burn tokens to satisfy some manager’s dashboard, then yes, grab the MWD skills files and integrate them into your LLM work. You’ll almost definitely get better output than if you do nothing at all. There are smart people working on this and many of the accessibility rules I saw were on-point.
But that output will be wrong in subtler and more nuanced ways across potentially fatter piles of code with more unrelated output and unwanted dependencies. It will require a more specialized set of skills to identify errors. And those errors will be different every time the code is generated.
So on the side, keep supporting any existing pattern library. If it’s built well, it’s copy-ready code that you can stuff into a project just as quickly as a chatbot could generate it. It’s deterministic, so you get the same code every time. Ideally it’s been vetted, so you don’t need to look for errors. It’s tailored to your context, meaning you don’t need to yank out random style switchers and typefaces (hoping you got all the dependencies).
If your job doesn’t require you to burn tokens, then probably ignore MWG and, by extensions, LLM for code. In case the environmental damage, intellectual property theft, wealth redistribution to the rich, encoded biases, and built-in support of fascism weren’t enough.
Update: 24 June 2026
The Silktide blog has this banger of a quote:
Across the board, [Google Antigravity using Modern Web Guidance] was a deprioritization of accessibility requirements in favor of visual presentation.
I don’t agree Antigravity nor MWG should use APG, which a regular visitor here may know, but the author is correct the APG disclosure pattern is mostly harmless.
But Silktide is right that the, once again, Google built the wrong thing for the wrong people and then proudly shoved it out into the world with no hint of self-awareness.
Avec la mise à jour 4.11.1 du Freebox Server déployée le 20 mai 2026[1], Free corrige un oubli historique : les Freebox savent désormais résoudre les noms des appareils du réseau local via leur DNS interne. Une fonctionnalité réclamée sur le bug tracker officiel depuis plus de quinze ans[2].
Ce que change réellement la 4.11.1
Jusqu'ici, le DNS embarqué dans la Freebox se contentait de relayer vos requêtes vers les résolveurs externes. Pour joindre un NAS ou un Raspberry Pi, il fallait connaître son adresse IP, du type 192.168.1.42. Et si le bail DHCP changeait, tout tombait.
La 4.11.1 ajoute la brique manquante : « un nom de domaine est maintenant associé automatiquement à chaque périphérique réseau »[3]. Concrètement, le Freebox Server expose un résolveur DNS local capable de répondre à des requêtes du type mon-nas.home ou monserveur.home et de retourner l'IP courante de l'appareil correspondant.
Cette évolution correspond à l'objet du ticket FS#4079, ouvert début 2011 sur le tracker officiel, qui réclamait un couplage DHCP/DNS sur la Freebox[2:1]. Quinze ans plus tard, c'est enfin fait.
Comment ce DNS local fonctionne ?
Le mécanisme de résolution DNS est classique, voici les trois étapes :
Le client demande une IP en DHCP. Au passage, l'appareil annonce son hostname (option DHCP 12), ce nom visible dans Freebox OS dans la liste des périphériques.
La Freebox enregistre le couple nom ↔ IP. Le bail DHCP est désormais injecté dans la table de résolution du DNS local du Server. Soyons précis : la Freebox lisait déjà le hostname annoncé par chaque appareil, c'est lui qui s'affiche dans la liste des périphériques de Freebox OS. Ce qui manquait jusqu'ici, c'était le pont entre cette information et le résolveur DNS embarqué.
Le DNS interne répond aux requêtes. Si la requête correspond à un appareil connu, il renvoie l'IP du LAN. Sinon, relais vers les DNS externes comme avant.
Aucun fichier hosts à maintenir, aucun bail statique forcé. Le hostname annoncé par l'appareil suffit.
Et le suffixe de domaine ?
Free n'a pas communiqué officiellement sur le suffixe utilisé dans le changelog, mais en explorant les écrans du Freebox Server après la mise à jour, on découvre que c'est .home qui a été retenu. Vos appareils sont donc accessibles sous la forme monserveur.home, nas-synology.home, raspberrypi.home, etc.
Choix pragmatique mais discutable techniquement : .home n'est pas réservé par l'IETF pour un usage local. La RFC 8375 a justement créé home.arpa pour combler ce besoin de manière normalisée[4]. À l'inverse, .local est réservé par la RFC 6762 au protocole mDNS (Bonjour, Avahi)[5] et Apple recommande explicitement de ne pas l'utiliser comme suffixe interne[6] Free a donc bien fait de l'écarter.
En pratique, .home est largement répandu sur les box concurrentes et fonctionne sans accroc aujourd'hui. Le seul risque serait qu'un futur registre l'enregistre comme TLD public, mais c'est très improbable vu son usage déjà massif dans les LAN domestiques.
Le nom exact attribué à chacun de vos appareils est visible dans Freebox OS > Périphériques réseau après la mise à jour.
Ce que cela débloque concrètement
Ce serveur DNS local connecté au DHCP vous permet de contacter vos périphériques directement sans que vous ayez connaissance de leur adresse IP :
ssh raspberrypi.home sans relire la liste DHCP à chaque fois
Pointer un docker-compose ou un script de backup vers un hostname stable du type nas.home
Configurer Plex, Jellyfin ou Home Assistant sur mobile sans dépendre d'un bail statique
Imprimer sur imprimante-salon.home depuis n'importe quel poste
Se passer d'un Pi-hole ou d'un AdGuard Home déployé uniquement pour la résolution locale
Ce DNS local est d'autant plus pratique si vous avez beaucoup d'équipements connectés à votre réseau dans votre baie de brassage.
Les limites à connaître
Le DNS interne reste strictement local :
Un appareil avec IP fixe configurée manuellement sur l'appareil lui-même (sans bail DHCP) ne sera pas résolu.
Un appareil qui n'annonce pas de hostname en DHCP restera invisible côté DNS.
Les équipements derrière un routeur secondaire ne bénéficient pas de la résolution.
Si vos clients pointent directement vers un DNS externe (Cloudflare, Quad9, NextDNS, Google…), la résolution .home est évidemment court-circuitée. En revanche, si vous faites tourner un AdGuard Home, un Pi-hole ou un Unbound sur votre réseau, il suffit de configurer la Freebox comme upstream DNS de ces outils pour conserver la résolution locale en plus de votre filtrage maison. Le meilleur des deux mondes.
Comment activer le DNS Local de la Freebox ?
Il n'y a rien à activer. Il suffit de redémarrer le Freebox Server[1:1]. Pour vérifier que la 4.11.1 est bien installée : écran de la box (menu Système / Informations avancées), application Free dans l'Espace Abonné, ou Freebox OS (mafreebox.freebox.fr).
Une fois en place, un simple ping monserveur.home depuis un poste du réseau confirme que le DNS interne répond.
Pour modifier l'entrée DNS du périphérique, il suffit de se rendre dans la vue "Périphériques réseau" et de modifier le champ DNS Local :
En résumé
Une vraie bonne nouvelle, même si j'ai un doute sur la cible : les profils qui ont vraiment besoin de résolution DNS locale font souvent tourner leur propre solution de DHCP (Pi-hole, AdGuard Home, OPNsense, OpenWrt ...) et n'ont pas forcément envie de confier cette brique à un hardware lié à leur opérateur.
Et vous, vous repassez sur le DHCP Freebox pour profiter du .home, ou vous gardez votre stack maison ? N'hésitez pas à rejoindre le serveur Discord Geeek pour discuter.
En recréant ce carnet de zéro, les liens s'ouvraient à même la page, sans créer de nouvel onglet/fenêtre.
Est-ce qu'ajouter un attribut target="_blank" sur des liens hypertextes absolus suffit ? Non, l'exemple du module markdown-it-for-inline ne suffit pas.
J'aimerais :
gérer la sécurité avec l'onglet ouvert. Il pourrait être utilisé par des pisteurs, sur la page nouvellement ouverte, par des extensions web verrolées ;
informer de la destination aux lecteurs d'écran. La destination étant "un nouvel onglet". Ça correspond au critère 6.1.1 du RGAA ;
distinguer visuellement les liens qui ouvrent un nouvel onglet. Même intention, visuelle cette fois.
L'utilisation combinée des propriétés background-color et mask-* aident à respecter les proportions de l'image vectorielle et à la détourer aux couleurs du texte du lien.
L'image est encodée directement dans la feuille CSS pour éviter un temps de latence à l'affichage.
Je découvre la fonctionnalité about:keyboard dans Firefox, qui affiche tous les raccourcis claviers et permet de les modifier. C’est encore expérimental mais c’est génial ! (Si vous n’utilisez pas les raccourcis claviers quand vous utilisez Firefox — ou tout autre application — sachez que c’est un incroyable gain de productivité, et garanti sans IA
Voic Apfel, le p’tit truc qui permet d’utiliser le LLM local des Macs les plus récents. C’est limité (4096 tokens en comptant l’entrée et la sortie, et “seulement” 3 milliards de paramètres), mais ça fonctionne 100% en local ! Les explications de Korben en français. Alors ça ne résout pas tous les problèmes de l’IA (utilisation des travailleurs du clic, obligation d’avoir une machine moderne avec le dernier OS, impact de la fabrication de la machine au niveau eau, ressources abiotiques, énergie, pollution et émissions de GES), mais au moins ça évite de solliciter les datacenters avec des gros GPU, alimentés avec une énergie carbonée, et c’est déjà ça.
Souveraineté numérique : l’État accélère la réduction de ses dépendances extra-européennes. On peut lire un peu partout à quel point cette nouvelle est importante. Elle l’est. Mais il convient de rappeler qu’il s’agit pour l’instant de 250 postes, ceux de la DINUM. Beaucoup de bruit pour rien ? Non, pas du tout, mais comme toujours c’est plus compliqué que ce qu’on pense. D’abord, la DINUM, c’est la Direction Interministérielle du NUMérique. Elle joue un rôle très important dans l’évolution du numérique de l’État. Donc ce qu’elle fait peut faire tâche d’huile, c’est même sa vocation. Ensuite, au niveau technique, c’est intéressant de voir qu’ils ont choisi NixOS et développent leurs propres briques logicielles pour sécuriser l’administration des postes ;
À propos d’utiliser l’IA pour trouver des trous de sécurité dans les logiciels, voici un article passionnant de Mozilla : The zero-days are numbered. Ils utilisent une approche “défense en profondeur” (plusieurs couches de protection), misent de plus en plus sur Rust (mais se débarrasser de C++ va prendre du temps) et mettent leur code à l’épreuve avec des techniques telles que le fuzzing. Enfin, ils ont recours à des humains qui cherchent des bugs dans le code, mais des gens très compétents capables de faire cela sont rares et chers. Et c’est là que ça devient intéressant : “Computers were completely incapable of doing this a few months ago, and now they excel at it. We have many years of experience picking apart the work of the world’s best security researchers, and Mythos Preview is every bit as capable. So far we’ve found no category or complexity of vulnerability that humans can find that this model can’t.” Mais il y a une bonne nouvelle : “Encouragingly, we also haven’t seen any bugs that couldn’t have been found by an elite human researcher.” J’aime leur questionnement : jusqu’à quand le logiciel, dont le développement est dopé à l’IA, restera compréhensible par les humains ? Leur vision, à peine évoquée dans une note de bas de page : “Human-comprehensibility is an essential property to maintain, especially in critical software like browsers and operating systems.” (Traduction maison : “la compréhension par l’humain est une propriété essentielle à préserver, tout particulièrement dans les logiciels critiques comme les navigateurs et les systèmes d’exploitation”) ;
Il est assez clair pour les acteurs de l’IA, que Sam Altman, le patron d’OpenAI (qui fait ChatGPT) est un menteur pathologique. Mais là, cet article du New-Yorker, Sam Altman May Control Our Future — Can He Be Trusted?, le prouve de façon imparable. L’un de ses auteurs est Ronan Farrow, qui a obtenu un prix Pulitzer pour son enquête sur Harvey Weinstein (qui a déclenché l’affaire du même nom) ;
85 % des héritages sont inférieurs à 100 000 euros, sans compter qu’un tiers des français n’héritent pas du tout. Et si la donation est faite de leur vivant, chaque parent peut donner 100 000 € à chaque enfant tous les 15 ans sans être taxé. Malgré tout, la taxation de l’héritage est considérée comme injuste par beaucoup de gens (dont la plupart n’est pas concernée !) Voir aussi L’héritage profite aux riches ;
Cloud souverain : des acteurs européens lancent leur propre label. Ce que j’aime dans cette approche, c’est la distinction entre souveraineté (je préfère “autonomie stratégique” mais passons) et résilience, qui est plus large. Je reviendrais sur ce sujet. (Oui, c’est du teasing !)
Sovereign Tech Standards, un programme de financement visant à permettre à des indépendants / free lance de participer aux travaux sur les standards de l’IETF, du W3C et de l’ISO. Si ça vous intéresse, il faut s’inscrire vite, avant le 19 mai !
Endgame for the Open Web par Anil Dash, sa version à lui de “l’IA est en train de tuer le Web”. Bien documenté, bien étayé. Imparable !
Une vingtaine de chantiers prioritaires ont été sélectionnés pour leur rôle central dans la réussite de la transition bas-carbone de la France. Chaque chantier explore les conditions indispensables de succès comme les points de fragilité (main d’œuvre, dépendances énergétiques ou matérielles, faisabilité) susceptibles de compromettre nos objectifs climatiques nationaux.
Transports : déploiement du vélo, extension des transports en commun, généralisation de la voiture électrique (sobre), massification du train, décarbonation de l’aérien (SAF et baisse du trafic), relance du fret ferroviaire, déploiement des camions électriques
Logement : rénovation des habitations, déploiement des pompes à chaleur (PAC)
Numérique : maîtrise du déploiement des centres de données
Industrie : production d’acier bas-carbone, production d’hydrogène bas-carbone, captage et séquestration de carbone i.e. CCS
Agriculture : transformation de nos systèmes d’élevage (baisse sélective des cheptels bovins), transformation de notre gestion de l’azote (légumineuses), maintien et développement des puits de carbone naturels, agricoles et forestiers
Énergie : prolongation du nucléaire historique et lancement du nouveau nucléaire (EPR2), déploiement des énergies renouvelables (photovoltaïque, éolien terrestre, éolien en mer), déploiement soutenable des bioénergies
Interview de votre serviteur en excellente compagnie, Fred Turner et Lawrence Lessig par le magazine FUTUR (#51). À propos du feu de poubelle qu’est devenu le Web, et comment le réparer (si c’est encore possible). Cela m’a valu la citation suivante en exergue dans le magazine, à propos du Fédivers, d’absence de centralisation et de capture de l’attention : « Mastodon, PeerTube, Mobilizon… Ce sont nos stands de carottes bio plantés en face des dealers de crack attentionnel, et pour l’instant, il y a beaucoup plus de clients chez le dealer que chez le maraîcher. »
Je savais déjà que l'utilisation d'émojis dans le texte n'était pas accessible.
C'est leur texte alternatif qui est lu au lecteur d'écran. Comme "mains rassemblées" ou folded hands pour l'émoji utilisées pour symboliser un "merci" 🙏.
Il a fallu plonger dans les entrailles du fonctionnement de markdown-it pour que chaque émoji existante soit elle aussi, convertie dans un code similaire.
J'ai créé une règle qui est insérée avant l'extension émojis pour convertir chaque émoji (unicode) en raccourci textuel d'émoji :
Je n'ai pas eu à reprendre les vingt années de contenus pour y arriver.
La lecture d'une issue GitHub, d'une proposition de code et le code d'autres extensions markdown m'ont aidé à mettre en place les mécanismes ci-dessus.
I want to discuss accessibility because it is the most important thing for making websites. Other A List Apart articles give you innovation and insight. This article will give you homework. These are just my personal views, but they’re pretty good.
I want to start off with a couple of statements, and you will agree:
Designers are good people. I have never heard a designer say, “I don’t care if somebody can’t read this text”, “Not my fault if somebody can’t use this device”, or “Who cares if this is confusing?”
Some designs exclude people. You have seen people unable to read the text on a website or app that somebody designed. You’ve seen people unable to use a physical device that somebody has designed. You’ve seen people utterly bamboozled while trying to use a service that somebody designed.
So what?
The first question is, “Is this life-or-death stuff?” The answer is, “Yes.” In my favorite essay, This Is All There Is, Aral Balkan makes the point that pretty much everything that we design can affect life events and death events. Aral gives the example of how even a straightforward bus timetable app can affect life and death events, if we design it badly:
somebody might miss a life event, such as their daughter’s fifth birthday party; or
somebody might miss a death event, such as the chance to say goodbye to a dying grandmother.
The next—and frustrating—question is, “Why do some designs still exclude people?” After all, we know that:
not everybody can see perfectly;
not everybody can hear perfectly;
not everybody thinks the same way; and
not everybody moves the same way.
I think the answer is that there’s too much to recall. Consider, if you will, the wide variety of topics that A List Apart articles cover. Designers are expected to remember all of that guidance, plus all of the accessibility guidance, plus so much more. It is too much.
Recognizing accessibility issues while designing
I’d like to point toward one possible solution, starting from Jakob Nielsen’s 10 Usability Heuristics for User Interface Design. These are from the mid-1990s, and—although there’s a good chance that you, gentle reader, are a lot younger than that—please bear with me.
Seeing as the problem is that there’s too much to recall, I want to look at heuristic № 6, “Recognition rather than Recall.” Jakob Nielsen said that for users, information required to use the design should be visible or easily retrievable when needed. I suggest we tweak that to make life easier for designers. Let’s say that the information required to produce the design should be visible or easily retrievable when needed. In other words, let’s make it easier to recognise accessibility issues while we’re designing.
Vishnu, an engineer and global citizen with low vision says, “I want to be on the same level as everyone else”, “If I can adjust my screen, I can read comfortably”, and, “Translating in my head is easier with simpler sentences.”
Trevor, a high school student with autism, says, “I like consistent, familiar places on the web”, “When I can learn the pattern, I can find my way”, and, “Reading is hard for me”.
Maria, a bilingual community health worker, says, “I love this. It’s all here … when I can find it”, “When a site is confusing, I just leave”—fair enough, Maria!—and, “When I hear and see it, health information makes more sense”.
Lea, an editor living with fatigue and pain, says, “No one gets that this really is a disability”, “Don’t make me work so hard”—please do not bombard this lady with drop-down lists—and, “Links at the top of the page make navigation easier for me”.
Carol, a grandmother with macular degeneration which affects her sight, says, “My grandkids are dragging me into the world of technology”, “I don’t understand what the screen is saying”, and, “Why can’t the text be just a little bit larger?”
I want to throw one more persona at you now, because, well, A List Apart readers are overachievers. One of my favorite authors, Cennydd Bowles—who literally wrote the book on Future Ethics—says to create Personas Non Grata. In other words, every time we design something, we have to think about what a bad guy could do with that thing, and whom that might affect.
To actually use these personas while designing, I like what Eric Meyer and Sara Wachter-Boettcher in Design for Real Life call the Designated Dissenter: for each project that you work on, one of your teams should be responsible for asking, “Will this work for Vishnu?”, “How’s Trevor going to get on with this?”, and so on.
Then, once you’ve used the personas to recognise the accessibility issues, you can look up the guidelines for whichever platforms you’re designing for:
I told you in the introduction of this article that I would give you homework. You thought I was joking. So, here’s your homework: I want you to grab the personas from the Know About Accessibility website, and use them throughout every design project to help you recognise accessibility issues while you work—and reclaim design for everyone.
Des Faiseuses de Web, l’histoire de la fille Basse-Fidélité et ses battements pour relaxer / étudier à, la marque de voiture des lesbiennes, installer toutes les extensions Firefox, Des Verbes, et la sagesse de Merlin.
Cette semaine, j’attends une nouvelle importante dont je vous parlerai peut-être la semaine prochaine 👀
Ce weekend je suis allé à l’événement Faiseuses du Web[1] à Dinan, un forum ouvert humaniste, féministe, intersectionnel et communautaire très chouette, avec que des gens trop super : J aux échanges réciproques passionnants et qui m’a inspiré d’utiliser l’expression « trop super » à l’instant ; Ma avec qui nous avons parlé d’amours ; Mé qui a la force d’organiser cet événement tous les ans, et de mieux en mieux (encore merci !) ; Mo et L et leur finesse intellectuelle ; Be, sa gentillesse et le plaisir avec lequel elle partage ses goûts musicaux (« que des Bra, autant Brassens que Brahms » 😀) ; les silences de D qui reflètent la teneur de son écoute et ne sont rompus que pour des interventions pertinentes ; la joie extatique et contagieuse de F de se retrouver ; les idiosyncraties d’élocution et de gestuelle tendrement partagées par F et D (mais aussi par Mé, en y réfléchissant bien) ; le discours pertinent et dénué de jugement de Z ; les interventions douces et la profondeur technique de G ; les trolls politiques au soleil et les trous-du-lapins techniques sous la lune avec A ; les bonnes recos randonnées et la fraîcheur de S ; les observations naturalistes et le partage d’astuces papa-plantes avec Bt ; et j’en oublie sûrement et je suis désolé auprès d’elleux. Nonobstant. Que des gens trop chouettes, des allié·es, des adelphes, qui brillent par leur capacité à résister et à affirmer franchement qui ielles sont, en toutes circonstances. Merci à vous 🥰
cargo-machete : petite release d’une nouvelle version, avec principalement des mises à jour de dépendences et des petites améliorations de performance qui nous viennent de la communauté 🤩
Êtes-vous borderline ? dans laquelle le psychologue critique Za effectue un test en ligne pour savoir s’iel est borderline ; plutôt rigolo qu’informatif, pour une fois.
Par Za encore une fois, Vous ne savez pas ce que fait la dopamine qui parle de l’hyper mise en avant de la dopamine comme le neurotransmetteur qu’il faudrait réguler à titre personnel, alors que… ce serait assez politique d’exiger cela ! Beaucoup de très bonnes choses, comme d’habitude. Personnellement, ça me pose question cette posture « tout le monde vous ment et moi je sais », parce que ça donne un petit relent complotiste qui pourrait limiter la portée du propos, à mon sens. Et pour avoir écouté beaucoup de podcasts de Huberman, je ne suis pas d’accord avec la critique de Za très généralisée du rôle de la dopamine ; c’est très très bien expliqué dans les podcasts d’Huberman, et notamment les rôles des autres neurotransmetteurs (dont celui mentionné par Za, sans divulgâcher quoi que ce soit).
Something very weird is happening on Tinder, où Christophe a enquêté sur un phénomène très étrange sur Tinder : une photo de chaque profil qui n’a absolument rien à voir avec toutes les autres, sur des profils de personnes qui semblent par ailleurs trop belles ou trop parfaites (trop générées par IA ?). Assez intéressant !
L’histoire par SEB de la Lofi Girl et ses beats to relax/study to. Chouette explication d’un phénomène du Web de ces dernières années, avec interview des personnes derrière, et c’est agréable de découvrir que les productions musicales liées ne sont pas générées par de l’IA a priori (pour un style qui s’y prêterait malheureusement trop bien par ailleurs).
Et la vidéo la plus surprenante et fascinante : comment Subaru est devenu une marque de lesbiennes. Alors il y a une petite partie qui parle de la marque Subaru (et on y apprend des choses éclairantes, comme l’origine du nom et du logo de Subaru), mais aussi qu’une grosse partie des campagnes publicitaires aux États-Unis contenaient du marketing queer-codé pour les lesbiennes à une période 🤯 #XENALVR
J’ai lentement continué Multiamory, commencé il y a quelques semaines, un livre qui parle, comme son nom ne l’indique pas, principalement de communication dans les relations (j’en suis au chapitre 4, peut-être que ça change ensuite). Je trouve toujours ça très nuancé et hyper intéressant. Dernier chapitre : la notion de limites (boundaries en anglais), à voir non pas comme quelque chose qu’on impose aux autres, mais quelque chose qu’on applique à soi, uniquement, pour se protéger et rester aligné avec ses valeurs et principes. J’adore 💝
J’ai aussi commencé La maison au milieu de la mer céruléenne, de TJ Klune, sur recommendation d’un ami. C’est pas mal de lire de la fiction aussi, en fait, ça détend ???!!!!
Actually, people love to work hard - Anil Dash nous parle du fait que les gens aiment bien travailler, quand c’est dans de bonnes conditions, avec de l’autonomie, de la confiance, de la responsabilité, au sein d’une équipe. Qui aurait pu prédire. J’ai l’impression de retrouver ça dans certains cadres ; récemment nous avons fait un hackathon interne chez Element où j’ai ressenti ça (même si les hackathons ne sont pas une pratique à trop généraliser et à laquelle s’habituer, parce qu’ils portent parfois des valeurs productivistes et toxiques).
I realized that You don’t care, une réflexion par Thib sur le fait que la plupart des écrits n’intéressent pas les gens, ce qui pour moi apparaît comme plutôt libérateur : autant écrire sur ce qui me fait plaisir, avec ma voix, mon intonation, plutôt qu’essayer de me conformer aux attentes d’un groupe que je ne connais pas vraiment et qui, dans sa globalité, ne va pas lire ce que j’écris.
Signals, the push-pull based algorithm — Willy Brauner : une explication de comment les frameworks JS (et sûrement dans d’autres langages) modernes fonctionnent, avec un système qui (1) signale un changement d’état de la source vers les dépendences et (2) du cache des valeurs dépendentes recalculées de manière paresseuse depuis les sources. Visualisations très chouettes !
Programming as Spiritual Practice : bien que je n’adhère pas au vernis mystique et spirituel, toutes les valeurs et tous les principes mis en avant ici me semblent vertueux et raisonnables à suivre, notamment autour de la relecture de code et de la pratique du debugging. Merci à Zélia pour le partage !
Installing every* Firefox extension : une curiosité intellectuelle : que se passe-t-il si on installe toutes les extensions Firefox possibles sur une instance de Firefox ? Eh bien, alerte divulgâchis, il va vous falloir de la RAM. Beaucoup de RAM.
La Suite numérique de l’État : critique des critiques, où Framasoft revient sur l’histoire de la Suite Numérique, un très beau projet open-source financé et développé par l’État (en l’incarnation de la DINUM), et sur des critiques récentes qu’on a pu lui faire. J’apprécie, comme toujours, la nuance de la position portée par Framasoft.
(Je mets la section à part, pour les personnes qui en ont marre de lire sur le sujet.)
Des verbes où Agnès partage son désenchantement du métier de dev à cause de l’arrivée des LLMs / IAs pour coder, et ce que ça fait à notre métier de dev (en tous cas c’est ce que j’en ai retenu ; j’espère ne pas m’être trop fourvoyé !). C’est touchant et chouette d’avoir écrit ça, parce que cela me semble décrire l’expérience de beaucoup de gens. Mais j’ai été triste malgré tout en lisant son post ; non pas parce que je partage nécessairement les mêmes peines, mais parce que justement j’ai eu du mal à me retrouver dans les joies qu’elle dit trouver dans le développement, notamment autour de l’apprentissage et du partage avec ses pairs. Peut-être que plusieurs années de télé-travail (et des mauvaises pratiques organisationnelles autour du télé-travail) ont éteint petit à petit le feu de ces joies-là. Il m’est temps de nous retrouver dans le monde réel.
I used AI. It worked. I hated it. raconte l’histoire d’un dev qui apprécie l’artisanat du code et décrit son expérience d’un LLM pour coder, une expérience à la fois « réussie » (l’IA a réussi à coder ce qu’il voulait) mais très peu plaisante. Vous auriez pu deviner en lisant le titre, cela dit ; l’article vaut le coup, pour les détails de son expérience.
Generative AI vegetarianism, une position assez raisonnable et non-jugeante sur l’utilisation des LLMs pour coder.
The AI Great Leap Forward : un parallèle entre un épisode catastrophique de l’histoire de l’industrialisation de la Chine sous Mao, et l’invasion des LLMs à notre époque. Parfois un peu tiré par les cheveux, mais j’ai apprécié de découvrir cet épisode tragique de l’histoire chinoise.
Discourse is Not Going Closed Source : suite à l’annonce de Cal.com de passer d’open-source à closed-source de nouveau, pour des raisons de sécurité par l’obscurité (à cause de la capacité des LLMs de code à trouver des failles de sécurité), un des fondateurs de Discourse indique que cela ne va pas être la trajectoire pour Discourse, en explicitant les raisons.
Une méthode intéressante de résistance au remplacement par des IAs : si votre boss vous demande d’écrire une « skill » qui décrit votre travail, vous pouvez la rendre plausible mais inutile, grâce à cet outil, anti-distill.
Stop Sloppypasta, un ensemble de règles de politesse autour de l’usage de l’IA / des LLMs pour des interactions avec d’autres humain·es. Une nouvelle AItiquette ? (omg il a osé)
CloakBrowser, un navigateur automatisé basé sur Chrome qui passe plein de tests de détection de bots. Probablement codé par IA au vu de la gueule du README, mais signe l’arrêt de mort des tests de détection de bots, de facto inutiles désormais.
Korben, entre deux articles faisant un éloge peu nuancé des LLMs 🫢, a sorti un article avec plein de points d’entrées pour des listes d’alternatives européennes aux services Web et tech les plus courants. Chouette à partager, pour celleux qui ont la motivation !
Refreshing your neovim config for 0.12 donne des astuces pour mettre à jour sa configuration Neovim suite à la mise jour 0.12 qui a cassé un certain nombre d’extensions, notamment TreeSitter.
Et si on se retrouvait ? Dites-moi (en PV si vous préférez) si vous allez à certains de ces événements ; clairement, ce qui me motive encore plus que l’événement, ce serait de retrouver des copains et copines 😃
RustWeek, du 18 au 23 mai à Utretcht, où toutes les restar européennes du langage de crabe 🦀 blazingly 😎 fast 🚀 vont se retrouver. Y vais-je ? Y vais-je pas ?
JDLL, le 30 et 31 mai à Lyon. Je pense sûrement y aller, parce que pas mal de personnes de Faiseuses du Web y vont également, et ce serait l’occasion de revoir pas mal de têtes connues 👀
Pub non sponsorisée : si vous suivez aussi la lettre de @Signez lundi.dev, vous aurez reconnu quelques liens que j’ai découverts grâce à lui (merci 🤩). Et sinon, n’hésitez-pas à vous y inscrire pour recevoir des news plus régulières et un peu moins denses.
Merlin’s Wisdom project, un ensemble d’idées et de propositions éclairantes et inspirantes (j’aime pas ce terme, mais c’est vraiment ce qui décrit, sans caca de taureau). À retrouver sous forme d’un compte Mastodon automatisé qui publie régulièrement des extraits, et ça fait plaisir de tomber dessus de manière sporadique et sérendipitesque.
que mon téléphone souhaite absolument auto-corriger en Fraiseuses du Web, pour une version mécano-féministe qui éveille mon imaginaire solar-punk. ↩
The most commonly exercised right under the GDPR is the right of access to one’s personal data that is being processed by companies. After all, it’s often the prerequisite to know if there is inaccurate or unlawful personal data that needs to be corrected or deleted. However, a newanalysis of noyb cases shows: Only 16.5% of all access requests noyb has sent to companies in the past 8 years received a satisfactory reply, while 53.7% of replies were incomplete – and almost 30% were not answered at all. In other words: while companies are lobbying Brussels to limit people’s right of access because of an alleged “abuse”, the real problem is non-compliance by these exact companies.
No “abuse” by data subjects, but by companies. Following intense lobby pressure (especially by the German industry), the European Commission’s Digital Omnibus proposal argues that there’s a need to restrict data subject rights under the GDPR. Most notably, the proposed changes include a limitation of the right of access (in Articles 12(5) and 15 GDPR) to “data protection purposes”, which is justified with an allegedly wide-spread “abuse” of this right. This means, for example, that if an employee uses an access request in a labour dispute over unpaid hours – for example, to obtain a record of the hours they have worked – the employer could reject it as "abusive". In practice, this would massively limit the rights that Europeans have against companies.
Max Schrems: “The European Commission has fallen for a heavily abused lobbying narrative that the right to access is constantly being ‘abused’, when in reality it is largely companies that violate these laws.”
Real-life data: 83.5% of access requests not properly answered. In practice, however, the primary problem concerning the right of access is not “abusive” complaints, but the huge amount of requests that don’t receive a proper answer. This also explains why a significant number of complaints before authorities concern the lack of a full reply to access requests. To gain more insight into how companies deal with the right of access, noyb analysed 121 access requests that have been filed in relation to noyb cases since 2018*. The results are clear: only 16.5% of those requests received a satisfying reply, while 53.7% were incomplete – and almost 30% were not answered at all. Overall, 83.5% of requests were not answered in line with the law.
Big Tech takes your data, but doesn’t want to give you access. Noticeably, a lot of the analysed access requests were filed with big tech companies, which usually have automated tools to deal with requests. Nonetheless, most of them either received an incomplete reply or none at all. We observe this issue across all noyb cases – and the results would likely be worse for data subjects without legal representation or the resources to send multiple follow-up requests. Our cases against TikTok, AliExpress and WeChat provide a perfect example for this: Despite multiple follow-up requests to an incomplete response to an access request, the companies still failed to fulfil the initial request. This made it impossible for the complainants to check whether their data has been processed in line with the GDPR. Another good example is our case against the advertising broker Xandr (a Microsoft subsidiary), which reported an astonishing 0% response rate to access and erasure requests in 2022.
Access Requests not a relevant workload. At the same time, a recently published noyb survey made clear that the majority (over 70%) of Data Protection Officers (DPOs) working in companies think that data subject rights – and the Right of Access in particular – don’t create a significant workload, while being a useful tool for protecting people’s rights.
Nothing is final. Fortunately, the Commission’s proposals to change the GDPR are just that: proposals. The Digital Omnibus is currently still being discussed in the European Parliament and in the Council and has already received significant resistance. noyb continuously works to preserve and strengthen data subject rights. After all, this analysis clearly shows that the authorities’ enforcement of (and compliance with) the Right of Access is already lacking. A further restriction would hurt millions of people in Europe.
*Note on the methodology: we analysed all access requests that have been filed in relation to noyb cases since 2018. Then, we made sure to only include a maximum of two requests per company to not distort the picture. This left us with 121 access requests.
Je demande parfois « Tu fais quoi avec l’IA ? ». L’ingénierie logicielle c’est bien plus que taper du code mais je vais ici me concentrer sur la génération de code.
Le niveau 0 c’est celui qui ne cherche pas à utiliser l’IA mais qui ne fait pas la chasse non plus. Surprise, à ce niveau on l’utilise probablement à plusieurs endroits sans le savoir, mais ça reste anecdotique.
C’est celui qui ne veut pas en entendre parler et qui fait attention à exclure tout ce qui est lié à l’IA, c’est plutôt le niveau –11.
Note: Ne sautez pas les étapes. On a besoin de maitriser une étape avant de pouvoir passer à la suivante avec succès. Si vous allez trop vite, vous risquez de simplement faire n’importe quoi.
Pensez aussi à toute votre chaîne. Si votre versionnement, votre intégration continue, vos pratiques de revue, votre architecture ou vos tests ne sont pas au niveau, ou si globalement les bonnes pratiques de développement logiciel modernes ne sont là, vous risquez de démultiplier le bordel : Garbage in, garbage out.
1. L’usage de surface
L’usage de surface c’est si vous avez configuré copilot ou un système similaire dans votre IDE. Il y a de la complétion automatique un peu intelligente sur une ou plusieurs lignes.
Honnêtement, si vous n’avez pas une aversion forte à l’IA, foncez.
C’est l’étape qui va juste vous apporter un peu de confort gratuit sans rien changer à votre métier. Les modèles liés sont des tout petits modèles pour que ça tourne rapidement, donc il n’y a pas vraiment d’enjeu énergétique non plus.
La première marche est de commencer à utiliser l’interface de chat pour poser des questions sur un mécanisme que vous ne connaissez pas, ou pour comprendre le fonctionnement d’un code qui n’est pas le vôtre.
La seconde marche est l’utilisation des interfaces de chat pour faire de la génération. Au départ on se contente des squelettes génériques initiaux qu’on modifiera ensuite. Assez vite on tente des modifications contextuelles locales ou de la revue de code, pour voir.
Ne vous attendez à rien d’exceptionnel. C’est juste un outil de plus qui peut aider. Pensez à bien gérer votre versionnement, avec des commit avant et après le passage de l’IA, pour annuler tout facilement.
Si vous en êtes là, tentez les fonctions de debug de Cursor. Vous allez voir la machine faire des hypothèses, monter du monitoring, et itérer jusqu’à trouver et corriger la source du problème (avec votre aide). Ça ne fonctionne pas à tous les coups mais c’est une bonne aide en première intention.
2. Approche technique
Le premier palier intéressant c’est celui là. L’interface de chat sert à générer le cœur du code. L’idée c’est de commencer à plus générer de code qu’en écrire.
Les premières fois on reste sur une approche technique. C’est vous qui demandez explicitement quelle fonction, quel fichier, quelle architecture.
Cette étape peut être frustrante, parce qu’on a l’impression de prendre un bébé par la main et perdre du temps à tout expliquer ce qu’on pourrait taper aussi rapidement, et parfois mieux ou plus court. C’est là qu’on perd pas mal de monde qui « a essayé » sans oser vraiment plonger dedans.
Commencez à vous forcer à faire corriger au lieu de corriger vous-mêmes, pour apprendre comment faire le prompt. Ajoutez quelques règles par défaut pour que ça utilise vos styles et vos outils.
Le gain c’est quand, au lieu de faire corriger au fur et à mesure, on utilise le mode plan. Là on commence à guider l’architecture et à organiser ce qu’on veut. C’est aussi un gain direct pour les plus jeunes parce que ça permet de se concentrer sur l’important au lieu de se perdre dans l’implémentation.
3. Approche fonctionnelle
Pour moi le vrai palier de valeur ajoutée a été d’arrêter de faire du baby-sitting et de commencer à donner des intentions plutôt que des instructions. Le mode plan se charge de traduire ça et me permet d’intervenir avant la génération elle-même.
Spécifiez au fur et à mesure vos choix architecturaux, styles, contraintes et choix technologiques pour que ça vous demande le moins de re-travail possible. Au fur et à mesure, créez des règles cursor/claude pour ça et améliorez les chaque fois que vous avez besoin de préciser quelque chose de générique.
Vous en êtes là ? Le palier suivant c’est d’imposer des choses comme le TDD et le développement par contrat. Demandez de commencer par les tests et les interfaces, faites une revue sérieuse de cette étape. Le risque de surprise diminue énormément sur la suite. Ça vous permettra aussi de vous concentrer sur l’important.
4. Approche par spécification
Le mode plan est une évidence. Pourquoi ne pas pousser plus loin et concevoir les plans en mode plan ?
On commence par travailler sur des fichiers de spécifications fonctionnelles et technique, en mode plan. À partir de ces spécifications fonctionnelles et techniques, on demande de créer découpages des tâches et des plans d’implémentation détaillés pour chaque tâche.
On itère sur chaque étape, en se concentrant d’abord sur le haut niveau, puis en descendant avec plus de détail à chaque fois, concentré sur une tâche précise. On pourra ensuite demander l’exécution des tâches, une à une (en mode plan si ça vous amuse, mais c’est probablement moins nécessaire à ce niveau là), potentiellement avec un modèle moins coûteux.
C’est un vrai changement de travail mais on ne se détache ni de la technique ni du fonctionnel : on travaille sur l’important. Taper des formulaires, des tests et des fonctions utilitaires n’est clairement pas ce qui me semble le plus stimulant. Réfléchir à quoi faire et comment : si.
Vous en êtes là ? Le palier suivant c’est toujours de penser plan plutôt que de fournir des instructions et de corrections éphémères pour modifier le résultat. Si un code ne correspond pas, améliorez le fichier de tâche correspondant et regénérez. Si une tâche ou un enchaînement de tâches n’est pas bon, améliorez les spécifications et regénérez.
L’avantage annexe c’est qu’on peut poser quand on veut, travailler à plusieurs, et modifier tout ce qu’on souhaite après coup. On a aussi une documentation durable de ce qu’on fait.
5. Automatisation
Ce que je vois venir ensuite c’est l’automatisation de tout ça. On complète les règles et on crée des agents. On lie nos spécifications et nos tâches à la documentation, leur statut à l’outil de gestion de projet.
Les tâches peuvent récupérer les retours de la chaîne d’intégration continue et planifier des corrections immédiatement avant que vous ne passiez pour la revue manuelle. Même chose pour des pré-revues de code automatiques.
Ces revues de code automatiques peuvent tenter de qualifier les risques et proposer de valider automatiquement les changements non risqués (après une période où on aura confirmé que l’humain n’a en effet jamais eu à redire sur les changements qualifiés comme non-risqués).
On ajoute des agents qui vont surveiller la qualité de code, la maintenabilité, la sécurité, la cohérence, et qui vont tenter des refactoring automatiquement quand il commence à y avoir trop de duplication ou de complexité. On peut aussi ajouter des agents qui vont s’occuper des montées en version qui ont un impact sur le code. Il y a tant de tâches qui peuvent être automatisées une fois qu’on a un peu de temps libéré…
Bref, si le harnais de test est suffisant, ce qui ne tient qu’à nous au niveau des spécifications et plans d’implémentation vu que désormais mettre à jour les tests ne coûte pas forcément cher, on peut commencer à penser l’industrialisation de toute la chaîne.
Pas de jugement de valeur. On parle de –1 en terme d’utilisation de l’IA. ↩︎
For years I have seen people, teams, products, organizations, and projects promoting APCA contrast as the WCAG3 color contrast algorithm. In many of those cases, those same actors have suggested dismissing the contrast algorithm in WCAG2.
This kind of problematic advice happened so often that I started filing issues with tool makers to remove APCA, as with this May 2024 Chromium issue.
In January 2025 I saw a post promoting that advice, which would create legal risk for anyone following it. You can see my original 2025 response on Mastodon and the same post on Bluesky, where the creator of APCA also weighed in. Read those to ensure you aren’t just taking my word for it.
Current Situation
Here is the most current (as of this writing) contrast ratio algorithm in WCAG3 with the salient bit highlighted:
contrast ratio test Exploratory
meeting a sufficient level of contrast between two colors using the relationship of hue, saturation, and lightness values
Editor’s note
The contrast algorithm used in WCAG 3 is yet to be determined.
APCA was marked for removal in early 2023:
Exploratory content that does not gain WG support to proceed to the next stage within 6 months is automatically removed in the WCAG 3 development process. We still hope the promising contrast work will continue to mature for potential later inclusion.
As with other WCAG3 ideas that did not get working group support, the working group pulled it from the July 2023 WCAG3 working draft. APCA was only ever exploratory, and the W3C’s July 2023 update explained removal of exploratory items. The APCA creator’s response to Michael Cooper’s comment acknowledged that APCA versions in the draft were all early versions that were very obsolete (emphasis theirs).
I have no idea if APCA, whatever version, will come back to WCAG3.
What to Do?
You can still use APCA (whatever version). If you do, limit your risk by taking one of these approaches:
Choose colors that also conform to WCAG2 contrast requirements; or
If you pick colors that fail WCAG2 contrast requirements, document it and have a ready response should you receive a drive-by lawsuit from a bad actor using an automated checker to find a contrast violation (assuming your attorney lets you do this).
I am still not a (bird) lawyer.
In the meantime, WCAG3 is years away from being done, perhaps 2030 at the soonest. Any contrast algorithm it picks won’t be final until at least then. But if you like whatever is proposed and want to use it before 2030, then probably refer to my two approaches above.

 Connexion





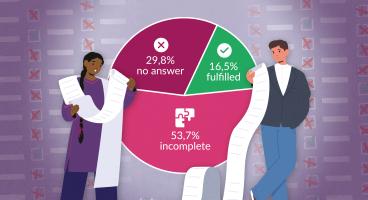


 You can still use APCA (whatever version). If you do, limit your risk by taking one of these approaches:
