❌

Vue normale

Émojis accessibles

25 avril 2026 à 22:38

Je savais déjà que l'utilisation d'émojis dans le texte n'était pas accessible. C'est leur texte alternatif qui est lu au lecteur d'écran. Comme "mains rassemblées" ou folded hands pour l'émoji utilisées pour symboliser un "merci" .

La lecture de l'article making emojis and icons screen reader accessible m'a fait agir dessus sur ce blog avec l'extension markdown-it-emoji.


J'ai suivi la documentation pour rendre l'affichage accessible.

Ainsi, le raccourci textuel :pray: est converti en :

<span class="emoji emoji--pray" aria-hidden="true">🙏</span>

Il a fallu plonger dans les entrailles du fonctionnement de markdown-it pour que chaque émoji existante soit elle aussi, convertie dans un code similaire.

J'ai créé une règle qui est insérée avant l'extension émojis pour convertir chaque émoji (unicode) en raccourci textuel d'émoji :

  1. on parcourt chaque jeton markdown ;\
{
  type: 'inline',
  content: 'Coucou 👋🏻'
}
  1. on vérifie la présence d'une émoji (via leur classe Unicode d'expression régulière) ;
  2. on remplace chaque occurence par son raccourci textuel.\
{
  type: 'inline',
  content: 'Coucou :wave:'
}
  1. qui a son tour rentre dans la moulinette expliquée précédemment\
  <p>Coucou <span class="emoji emoji--wave" aria-hidden="true">👋🏻</span></p>

Le code complet est disponible sur GitHub.


Tout autre émoji décoratif (comme dans cette entrée de journal par exemple) est masquée aux lecteurs d'écran avec aria-hidden="true" :

<h1 id="post-title">
  <span aria-hidden="true">☕️</span>
  Journal : Émojis accessibles
</h1>

Je n'ai pas eu à reprendre les vingt années de contenus pour y arriver. La lecture d'une issue GitHub, d'une proposition de code et le code d'autres extensions markdown m'ont aidé à mettre en place les mécanismes ci-dessus.

Good designers, bad websites: a proposal

Par : by
23 avril 2026 à 14:57

I want to discuss accessibility because it is the most important thing for making websites. Other A List Apart articles give you innovation and insight. This article will give you homework. These are just my personal views, but they’re pretty good.

I want to start off with a couple of statements, and you will agree:

  1. Designers are good people. I have never heard a designer say, “I don’t care if somebody can’t read this text”, “Not my fault if somebody can’t use this device”, or “Who cares if this is confusing?”
  2. Some designs exclude people. You have seen people unable to read the text on a website or app that somebody designed. You’ve seen people unable to use a physical device that somebody has designed. You’ve seen people utterly bamboozled while trying to use a service that somebody designed.

So what?

The first question is, “Is this life-or-death stuff?” The answer is, “Yes.” In my favorite essay, This Is All There Is, Aral Balkan makes the point that pretty much everything that we design can affect life events and death events. Aral gives the example of how even a straightforward bus timetable app can affect life and death events, if we design it badly:

  • somebody might miss a life event, such as their daughter’s fifth birthday party; or
  • somebody might miss a death event, such as the chance to say goodbye to a dying grandmother.

The next—and frustrating—question is, “Why do some designs still exclude people?” After all, we know that:

  • not everybody can see perfectly;
  • not everybody can hear perfectly;
  • not everybody thinks the same way; and
  • not everybody moves the same way.

I think the answer is that there’s too much to recall. Consider, if you will, the wide variety of topics that A List Apart articles cover. Designers are expected to remember all of that guidance, plus all of the accessibility guidance, plus so much more. It is too much.

Recognizing accessibility issues while designing

I’d like to point toward one possible solution, starting from Jakob Nielsen’s 10 Usability Heuristics for User Interface Design. These are from the mid-1990s, and—although there’s a good chance that you, gentle reader, are a lot younger than that—please bear with me. 

Seeing as the problem is that there’s too much to recall, I want to look at heuristic № 6, “Recognition rather than Recall.” Jakob Nielsen said that for users, information required to use the design should be visible or easily retrievable when needed. I suggest we tweak that to make life easier for designers. Let’s say that the information required to produce the design should be visible or easily retrievable when needed. In other words, let’s make it easier to recognise accessibility issues while we’re designing.

How are we going to do that? I really like the book A Web for Everyone—Designing Accessible User Experiences by Sarah Horton and Whitney Quesenbery. I really like this book not only because it includes a quote from me—actually two quotes, but I don’t like to boast—but because it includes personas that are perfect for helping us to recognise accessibility issues. That’s the good news. The even better news is that these personas are available now for free on the companion website to the book What Every Engineer Should Know About Digital Accessibility, again by Sarah Horton, with David Sloan this time.

Meet your users

I’m going to introduce you to these personas now:

I want to throw one more persona at you now, because, well, A List Apart readers are overachievers. One of my favorite authors, Cennydd Bowles—who literally wrote the book on Future Ethics—says to create Personas Non Grata. In other words, every time we design something, we have to think about what a bad guy could do with that thing, and whom that might affect.

To actually use these personas while designing, I like what Eric Meyer and Sara Wachter-Boettcher in Design for Real Life call the Designated Dissenter: for each project that you work on, one of your teams should be responsible for asking, “Will this work for Vishnu?”, “How’s Trevor going to get on with this?”, and so on. 

Then, once you’ve used the personas to recognise the accessibility issues, you can look up the guidelines for whichever platforms you’re designing for: 

Your mission, should you choose to accept it

I told you in the introduction of this article that I would give you homework. You thought I was joking. So, here’s your homework: I want you to grab the personas from the Know About Accessibility website, and use them throughout every design project to help you recognise accessibility issues while you work—and reclaim design for everyone.


NOTE: This article is based on “Recognise,” my five-minute presentation from Interaction Design Association (IxDA) Dublin’s Defuse (Design for Use) event in 2025.

Notes hebdomadaires #71

20 avril 2026 à 02:00

Des Faiseuses de Web, l’histoire de la fille Basse-Fidélité et ses battements pour relaxer / étudier à, la marque de voiture des lesbiennes, installer toutes les extensions Firefox, Des Verbes, et la sagesse de Merlin.

Cette semaine, j’attends une nouvelle importante dont je vous parlerai peut-être la semaine prochaine 👀

🔗Extra : Faiseuses du Web ✨

Ce weekend je suis allé à l’événement Faiseuses du Web [1] à Dinan, un forum ouvert humaniste, féministe, intersectionnel et communautaire très chouette, avec que des gens trop super : J aux échanges réciproques passionnants et qui m’a inspiré d’utiliser l’expression « trop super » à l’instant ; Ma avec qui nous avons parlé d’amours ; Mé qui a la force d’organiser cet événement tous les ans, et de mieux en mieux (encore merci !) ; Mo et L et leur finesse intellectuelle ; Be, sa gentillesse et le plaisir avec lequel elle partage ses goûts musicaux (« que des Bra, autant Brassens que Brahms » 😀) ; les silences de D qui reflètent la teneur de son écoute et ne sont rompus que pour des interventions pertinentes ; la joie extatique et contagieuse de F de se retrouver ; les idiosyncraties d’élocution et de gestuelle tendrement partagées par F et D (mais aussi par Mé, en y réfléchissant bien) ; le discours pertinent et dénué de jugement de Z ; les interventions douces et la profondeur technique de G ; les trolls politiques au soleil et les trous-du-lapins techniques sous la lune avec A ; les bonnes recos randonnées et la fraîcheur de S ; les observations naturalistes et le partage d’astuces papa-plantes avec Bt ; et j’en oublie sûrement et je suis désolé auprès d’elleux. Nonobstant. Que des gens trop chouettes, des allié·es, des adelphes, qui brillent par leur capacité à résister et à affirmer franchement qui ielles sont, en toutes circonstances. Merci à vous 🥰

🔗⚒️ Des projets

  • cargo-machete : petite release d’une nouvelle version, avec principalement des mises à jour de dépendences et des petites améliorations de performance qui nous viennent de la communauté 🤩

🔗📺 Regardé

  • Êtes-vous borderline ? dans laquelle le psychologue critique Za effectue un test en ligne pour savoir s’iel est borderline ; plutôt rigolo qu’informatif, pour une fois.
  • Par Za encore une fois, Vous ne savez pas ce que fait la dopamine qui parle de l’hyper mise en avant de la dopamine comme le neurotransmetteur qu’il faudrait réguler à titre personnel, alors que… ce serait assez politique d’exiger cela ! Beaucoup de très bonnes choses, comme d’habitude. Personnellement, ça me pose question cette posture « tout le monde vous ment et moi je sais », parce que ça donne un petit relent complotiste qui pourrait limiter la portée du propos, à mon sens. Et pour avoir écouté beaucoup de podcasts de Huberman, je ne suis pas d’accord avec la critique de Za très généralisée du rôle de la dopamine ; c’est très très bien expliqué dans les podcasts d’Huberman, et notamment les rôles des autres neurotransmetteurs (dont celui mentionné par Za, sans divulgâcher quoi que ce soit).
  • Something very weird is happening on Tinder, où Christophe a enquêté sur un phénomène très étrange sur Tinder : une photo de chaque profil qui n’a absolument rien à voir avec toutes les autres, sur des profils de personnes qui semblent par ailleurs trop belles ou trop parfaites (trop générées par IA ?). Assez intéressant !
  • L’histoire par SEB de la Lofi Girl et ses beats to relax/study to. Chouette explication d’un phénomène du Web de ces dernières années, avec interview des personnes derrière, et c’est agréable de découvrir que les productions musicales liées ne sont pas générées par de l’IA a priori (pour un style qui s’y prêterait malheureusement trop bien par ailleurs).
  • Et la vidéo la plus surprenante et fascinante : comment Subaru est devenu une marque de lesbiennes. Alors il y a une petite partie qui parle de la marque Subaru (et on y apprend des choses éclairantes, comme l’origine du nom et du logo de Subaru), mais aussi qu’une grosse partie des campagnes publicitaires aux États-Unis contenaient du marketing queer-codé pour les lesbiennes à une période 🤯 #XENALVR

🔗📕 Lu

  • J’ai lentement continué Multiamory, commencé il y a quelques semaines, un livre qui parle, comme son nom ne l’indique pas, principalement de communication dans les relations (j’en suis au chapitre 4, peut-être que ça change ensuite). Je trouve toujours ça très nuancé et hyper intéressant. Dernier chapitre : la notion de limites (boundaries en anglais), à voir non pas comme quelque chose qu’on impose aux autres, mais quelque chose qu’on applique à soi, uniquement, pour se protéger et rester aligné avec ses valeurs et principes. J’adore 💝
  • J’ai aussi commencé La maison au milieu de la mer céruléenne, de TJ Klune, sur recommendation d’un ami. C’est pas mal de lire de la fiction aussi, en fait, ça détend ???!!!!

🔗🕸️ Articles et blog posts

  • Actually, people love to work hard - Anil Dash nous parle du fait que les gens aiment bien travailler, quand c’est dans de bonnes conditions, avec de l’autonomie, de la confiance, de la responsabilité, au sein d’une équipe. Qui aurait pu prédire. J’ai l’impression de retrouver ça dans certains cadres ; récemment nous avons fait un hackathon interne chez Element où j’ai ressenti ça (même si les hackathons ne sont pas une pratique à trop généraliser et à laquelle s’habituer, parce qu’ils portent parfois des valeurs productivistes et toxiques).
  • I realized that You don’t care, une réflexion par Thib sur le fait que la plupart des écrits n’intéressent pas les gens, ce qui pour moi apparaît comme plutôt libérateur : autant écrire sur ce qui me fait plaisir, avec ma voix, mon intonation, plutôt qu’essayer de me conformer aux attentes d’un groupe que je ne connais pas vraiment et qui, dans sa globalité, ne va pas lire ce que j’écris.
  • If you thought the speed of writing code was your problem - you have bigger problems | Debugging Leadership, un article brillant sur la gestion des projets informatiques, à mon sens. Que le goulôt d’étranglement n’est pas nécessairement du côté de la production de code, mais plutôt sur les autres étapes autour, et notamment avant (design/recherche UX/produit) et après (relecture/validation UX/produit).
  • Signals, the push-pull based algorithm — Willy Brauner : une explication de comment les frameworks JS (et sûrement dans d’autres langages) modernes fonctionnent, avec un système qui (1) signale un changement d’état de la source vers les dépendences et (2) du cache des valeurs dépendentes recalculées de manière paresseuse depuis les sources. Visualisations très chouettes !
  • Programming as Spiritual Practice : bien que je n’adhère pas au vernis mystique et spirituel, toutes les valeurs et tous les principes mis en avant ici me semblent vertueux et raisonnables à suivre, notamment autour de la relecture de code et de la pratique du debugging. Merci à Zélia pour le partage !
  • Installing every* Firefox extension : une curiosité intellectuelle : que se passe-t-il si on installe toutes les extensions Firefox possibles sur une instance de Firefox ? Eh bien, alerte divulgâchis, il va vous falloir de la RAM. Beaucoup de RAM.
  • La Suite numérique de l’État : critique des critiques, où Framasoft revient sur l’histoire de la Suite Numérique, un très beau projet open-source financé et développé par l’État (en l’incarnation de la DINUM), et sur des critiques récentes qu’on a pu lui faire. J’apprécie, comme toujours, la nuance de la position portée par Framasoft.

🔗LLMs / IA pour coder

(Je mets la section à part, pour les personnes qui en ont marre de lire sur le sujet.)

  • Des verbes où Agnès partage son désenchantement du métier de dev à cause de l’arrivée des LLMs / IAs pour coder, et ce que ça fait à notre métier de dev (en tous cas c’est ce que j’en ai retenu ; j’espère ne pas m’être trop fourvoyé !). C’est touchant et chouette d’avoir écrit ça, parce que cela me semble décrire l’expérience de beaucoup de gens. Mais j’ai été triste malgré tout en lisant son post ; non pas parce que je partage nécessairement les mêmes peines, mais parce que justement j’ai eu du mal à me retrouver dans les joies qu’elle dit trouver dans le développement, notamment autour de l’apprentissage et du partage avec ses pairs. Peut-être que plusieurs années de télé-travail (et des mauvaises pratiques organisationnelles autour du télé-travail) ont éteint petit à petit le feu de ces joies-là. Il m’est temps de nous retrouver dans le monde réel.
  • I used AI. It worked. I hated it. raconte l’histoire d’un dev qui apprécie l’artisanat du code et décrit son expérience d’un LLM pour coder, une expérience à la fois « réussie » (l’IA a réussi à coder ce qu’il voulait) mais très peu plaisante. Vous auriez pu deviner en lisant le titre, cela dit ; l’article vaut le coup, pour les détails de son expérience.
  • Generative AI vegetarianism, une position assez raisonnable et non-jugeante sur l’utilisation des LLMs pour coder.
  • The AI Great Leap Forward : un parallèle entre un épisode catastrophique de l’histoire de l’industrialisation de la Chine sous Mao, et l’invasion des LLMs à notre époque. Parfois un peu tiré par les cheveux, mais j’ai apprécié de découvrir cet épisode tragique de l’histoire chinoise.
  • Discourse is Not Going Closed Source : suite à l’annonce de Cal.com de passer d’open-source à closed-source de nouveau, pour des raisons de sécurité par l’obscurité (à cause de la capacité des LLMs de code à trouver des failles de sécurité), un des fondateurs de Discourse indique que cela ne va pas être la trajectoire pour Discourse, en explicitant les raisons.
  • Une méthode intéressante de résistance au remplacement par des IAs : si votre boss vous demande d’écrire une « skill » qui décrit votre travail, vous pouvez la rendre plausible mais inutile, grâce à cet outil, anti-distill.
  • Stop Sloppypasta, un ensemble de règles de politesse autour de l’usage de l’IA / des LLMs pour des interactions avec d’autres humain·es. Une nouvelle AItiquette ? (omg il a osé)

🔗🎮 Joué

  • BROFORCE GHHHHHHHHH AAAAAAAAAAAAAAAA GHHHHHHHH AAAAAAAAAAA GHHHHHHH.

🔗🤓 Veille tech

  • CloakBrowser, un navigateur automatisé basé sur Chrome qui passe plein de tests de détection de bots. Probablement codé par IA au vu de la gueule du README, mais signe l’arrêt de mort des tests de détection de bots, de facto inutiles désormais.
  • Les progrès de Servo, le moteur de rendu Web écrit en Rust, en février ; ça fait plaisir de voir que le projet continue 😊
  • Korben, entre deux articles faisant un éloge peu nuancé des LLMs 🫢, a sorti un article avec plein de points d’entrées pour des listes d’alternatives européennes aux services Web et tech les plus courants. Chouette à partager, pour celleux qui ont la motivation !
  • Refreshing your neovim config for 0.12 donne des astuces pour mettre à jour sa configuration Neovim suite à la mise jour 0.12 qui a cassé un certain nombre d’extensions, notamment TreeSitter.

🔗📅 Des événements

Et si on se retrouvait ? Dites-moi (en PV si vous préférez) si vous allez à certains de ces événements ; clairement, ce qui me motive encore plus que l’événement, ce serait de retrouver des copains et copines 😃

  • RustWeek, du 18 au 23 mai à Utretcht, où toutes les restar européennes du langage de crabe 🦀 blazingly 😎 fast 🚀 vont se retrouver. Y vais-je ? Y vais-je pas ?
  • JDLL, le 30 et 31 mai à Lyon. Je pense sûrement y aller, parce que pas mal de personnes de Faiseuses du Web y vont également, et ce serait l’occasion de revoir pas mal de têtes connues 👀

🔗👀 Au passage

  • Pub non sponsorisée : si vous suivez aussi la lettre de @Signez lundi.dev, vous aurez reconnu quelques liens que j’ai découverts grâce à lui (merci 🤩). Et sinon, n’hésitez-pas à vous y inscrire pour recevoir des news plus régulières et un peu moins denses.
  • Merlin’s Wisdom project, un ensemble d’idées et de propositions éclairantes et inspirantes (j’aime pas ce terme, mais c’est vraiment ce qui décrit, sans caca de taureau). À retrouver sous forme d’un compte Mastodon automatisé qui publie régulièrement des extraits, et ça fait plaisir de tomber dessus de manière sporadique et sérendipitesque.
  1. que mon téléphone souhaite absolument auto-corriger en Fraiseuses du Web, pour une version mécano-féministe qui éveille mon imaginaire solar-punk. ↩

Digital Omnibus reality check: 83.5% of access requests not properly answered

Data Subject Rights

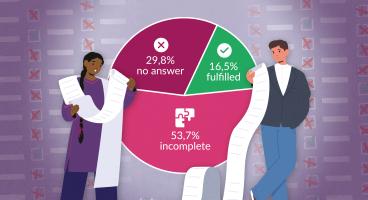
The most commonly exercised right under the GDPR is the right of access to one’s personal data that is being processed by companies. After all, it’s often the prerequisite to know if there is inaccurate or unlawful personal data that needs to be corrected or deleted. However, a new analysis of noyb cases shows: Only 16.5% of all access requests noyb has sent to companies in the past 8 years received a satisfactory reply, while 53.7% of replies were incomplete – and almost 30% were not answered at all. In other words: while companies are lobbying Brussels to limit people’s right of access because of an alleged “abuse”, the real problem is non-compliance by these exact companies.

Access Requests Statistics Header

No “abuse” by data subjects, but by companies. Following intense lobby pressure (especially by the German industry), the European Commission’s Digital Omnibus proposal argues that there’s a need to restrict data subject rights under the GDPR. Most notably, the proposed changes include a limitation of the right of access (in Articles 12(5) and 15 GDPR) to “data protection purposes”, which is justified with an allegedly wide-spread “abuse” of this right. This means, for example, that if an employee uses an access request in a labour dispute over unpaid hours – for example, to obtain a record of the hours they have worked – the employer could reject it as "abusive". In practice, this would massively limit the rights that Europeans have against companies.

Max Schrems: “The European Commission has fallen for a heavily abused lobbying narrative that the right to access is constantly being ‘abused’, when in reality it is largely companies that violate these laws.”

Real-life data: 83.5% of access requests not properly answered. In practice, however, the primary problem concerning the right of access is not “abusive” complaints, but the huge amount of requests that don’t receive a proper answer. This also explains why a significant number of complaints before authorities concern the lack of a full reply to access requests. To gain more insight into how companies deal with the right of access, noyb analysed 121 access requests that have been filed in relation to noyb cases since 2018*. The results are clear: only 16.5% of those requests received a satisfying reply, while 53.7% were incomplete – and almost 30% were not answered at all. Overall, 83.5% of requests were not answered in line with the law.

Only 16.5% of the analysed access requests were fulfilled

Big Tech takes your data, but doesn’t want to give you access. Noticeably, a lot of the analysed access requests were filed with big tech companies, which usually have automated tools to deal with requests. Nonetheless, most of them either received an incomplete reply or none at all. We observe this issue across all noyb cases – and the results would likely be worse for data subjects without legal representation or the resources to send multiple follow-up requests. Our cases against TikTok, AliExpress and WeChat provide a perfect example for this: Despite multiple follow-up requests to an incomplete response to an access request, the companies still failed to fulfil the initial request. This made it impossible for the complainants to check whether their data has been processed in line with the GDPR. Another good example is our case against the advertising broker Xandr (a Microsoft subsidiary), which reported an astonishing 0% response rate to access and erasure requests in 2022.

Access Requests not a relevant workload. At the same time, a recently published noyb survey  made clear that the majority (over 70%) of Data Protection Officers (DPOs) working in companies think that data subject rights – and the Right of Access in particular – don’t create a significant workload, while being a useful tool for protecting people’s rights.

Workload vs Level of Protection

Nothing is final. Fortunately, the Commission’s proposals to change the GDPR are just that: proposals. The Digital Omnibus is currently still being discussed in the European Parliament and in the Council and has already received significant resistance. noyb continuously works to preserve and strengthen data subject rights. After all, this analysis clearly shows that the authorities’ enforcement of (and compliance with) the Right of Access is already lacking. A further restriction would hurt millions of people in Europe.


*Note on the methodology: we analysed all access requests that have been filed in relation to noyb cases since 2018. Then, we made sure to only include a maximum of two requests per company to not distort the picture. This left us with 121 access requests.

Quelques étapes de matu­rité

Par : Éric
14 avril 2026 à 22:15

Je demande parfois « Tu fais quoi avec l’IA ? ». L’in­gé­nie­rie logi­cielle c’est bien plus que taper du code mais je vais ici me concen­trer sur la géné­ra­tion de code.

Le niveau 0 c’est celui qui ne cherche pas à utili­ser l’IA mais qui ne fait pas la chasse non plus. Surprise, à ce niveau on l’uti­lise proba­ble­ment à plusieurs endroits sans le savoir, mais ça reste anec­do­tique.

C’est celui qui ne veut pas en entendre parler et qui fait atten­tion à exclure tout ce qui est lié à l’IA, c’est plutôt le niveau –11.


Note: Ne sautez pas les étapes. On a besoin de maitri­ser une étape avant de pouvoir passer à la suivante avec succès. Si vous allez trop vite, vous risquez de simple­ment faire n’im­porte quoi.

Pensez aussi à toute votre chaîne. Si votre version­ne­ment, votre inté­gra­tion conti­nue, vos pratiques de revue, votre archi­tec­ture ou vos tests ne sont pas au niveau, ou si globa­le­ment les bonnes pratiques de déve­lop­pe­ment logi­ciel modernes ne sont là, vous risquez de démul­ti­plier le bordel : Garbage in, garbage out.

1. L’usage de surface

L’usage de surface c’est si vous avez confi­guré copi­lot ou un système simi­laire dans votre IDE. Il y a de la complé­tion auto­ma­tique un peu intel­li­gente sur une ou plusieurs lignes.

Honnê­te­ment, si vous n’avez pas une aver­sion forte à l’IA, foncez.

C’est l’étape qui va juste vous appor­ter un peu de confort gratuit sans rien chan­ger à votre métier. Les modèles liés sont des tout petits modèles pour que ça tourne rapi­de­ment, donc il n’y a pas vrai­ment d’enjeu éner­gé­tique non plus.

La première marche est de commen­cer à utili­ser l’in­ter­face de chat pour poser des ques­tions sur un méca­nisme que vous ne connais­sez pas, ou pour comprendre le fonc­tion­ne­ment d’un code qui n’est pas le vôtre.

La seconde marche est l’uti­li­sa­tion des inter­faces de chat pour faire de la géné­ra­tion. Au départ on se contente des sque­lettes géné­riques initiaux qu’on modi­fiera ensuite. Assez vite on tente des modi­fi­ca­tions contex­tuelles locales ou de la revue de code, pour voir.

Ne vous atten­dez à rien d’ex­cep­tion­nel. C’est juste un outil de plus qui peut aider. Pensez à bien gérer votre version­ne­ment, avec des commit avant et après le passage de l’IA, pour annu­ler tout faci­le­ment.

Si vous en êtes là, tentez les fonc­tions de debug de Cursor. Vous allez voir la machine faire des hypo­thèses, monter du moni­to­ring, et itérer jusqu’à trou­ver et corri­ger la source du problème (avec votre aide). Ça ne fonc­tionne pas à tous les coups mais c’est une bonne aide en première inten­tion.

2. Approche tech­nique

Le premier palier inté­res­sant c’est celui là. L’in­ter­face de chat sert à géné­rer le cœur du code. L’idée c’est de commen­cer à plus géné­rer de code qu’en écrire.

Les premières fois on reste sur une approche tech­nique. C’est vous qui deman­dez expli­ci­te­ment quelle fonc­tion, quel fichier, quelle archi­tec­ture.

Cette étape peut être frus­trante, parce qu’on a l’im­pres­sion de prendre un bébé par la main et perdre du temps à tout expliquer ce qu’on pour­rait taper aussi rapi­de­ment, et parfois mieux ou plus court. C’est là qu’on perd pas mal de monde qui « a essayé » sans oser vrai­ment plon­ger dedans.

Commen­cez à vous forcer à faire corri­ger au lieu de corri­ger vous-mêmes, pour apprendre comment faire le prompt. Ajou­tez quelques règles par défaut pour que ça utilise vos styles et vos outils.

Le gain c’est quand, au lieu de faire corri­ger au fur et à mesure, on utilise le mode plan. Là on commence à guider l’ar­chi­tec­ture et à orga­ni­ser ce qu’on veut. C’est aussi un gain direct pour les plus jeunes parce que ça permet de se concen­trer sur l’im­por­tant au lieu de se perdre dans l’im­plé­men­ta­tion.

3. Approche fonc­tion­nelle

Pour moi le vrai palier de valeur ajou­tée a été d’ar­rê­ter de faire du baby-sitting et de commen­cer à donner des inten­tions plutôt que des instruc­tions. Le mode plan se charge de traduire ça et me permet d’in­ter­ve­nir avant la géné­ra­tion elle-même.

Spéci­fiez au fur et à mesure vos choix archi­tec­tu­raux, styles, contraintes et choix tech­no­lo­giques pour que ça vous demande le moins de re-travail possible. Au fur et à mesure, créez des règles cursor/claude pour ça et amélio­rez les chaque fois que vous avez besoin de préci­ser quelque chose de géné­rique.

Vous en êtes là ? Le palier suivant c’est d’im­po­ser des choses comme le TDD et le déve­lop­pe­ment par contrat. Deman­dez de commen­cer par les tests et les inter­faces, faites une revue sérieuse de cette étape. Le risque de surprise dimi­nue énor­mé­ment sur la suite. Ça vous permet­tra aussi de vous concen­trer sur l’im­por­tant.

4. Approche par spéci­fi­ca­tion

Le mode plan est une évidence. Pourquoi ne pas pous­ser plus loin et conce­voir les plans en mode plan ?

On commence par travailler sur des fichiers de spéci­fi­ca­tions fonc­tion­nelles et tech­nique, en mode plan. À partir de ces spéci­fi­ca­tions fonc­tion­nelles et tech­niques, on demande de créer décou­pages des tâches et des plans d’im­plé­men­ta­tion détaillés pour chaque tâche.

On itère sur chaque étape, en se concen­trant d’abord sur le haut niveau, puis en descen­dant avec plus de détail à chaque fois, concen­tré sur une tâche précise. On pourra ensuite deman­der l’exé­cu­tion des tâches, une à une (en mode plan si ça vous amuse, mais c’est proba­ble­ment moins néces­saire à ce niveau là), poten­tiel­le­ment avec un modèle moins coûteux.

C’est un vrai chan­ge­ment de travail mais on ne se détache ni de la tech­nique ni du fonc­tion­nel : on travaille sur l’im­por­tant. Taper des formu­laires, des tests et des fonc­tions utili­taires n’est clai­re­ment pas ce qui me semble le plus stimu­lant. Réflé­chir à quoi faire et comment : si.

Vous en êtes là ? Le palier suivant c’est toujours de penser plan plutôt que de four­nir des instruc­tions et de correc­tions éphé­mères pour modi­fier le résul­tat. Si un code ne corres­pond pas, amélio­rez le fichier de tâche corres­pon­dant et regé­né­rez. Si une tâche ou un enchaî­ne­ment de tâches n’est pas bon, amélio­rez les spéci­fi­ca­tions et regé­né­rez.

L’avan­tage annexe c’est qu’on peut poser quand on veut, travailler à plusieurs, et modi­fier tout ce qu’on souhaite après coup. On a aussi une docu­men­ta­tion durable de ce qu’on fait.

5. Auto­ma­ti­sa­tion

Ce que je vois venir ensuite c’est l’au­to­ma­ti­sa­tion de tout ça. On complète les règles et on crée des agents. On lie nos spéci­fi­ca­tions et nos tâches à la docu­men­ta­tion, leur statut à l’ou­til de gestion de projet.

Les tâches peuvent récu­pé­rer les retours de la chaîne d’in­té­gra­tion conti­nue et plani­fier des correc­tions immé­dia­te­ment avant que vous ne passiez pour la revue manuelle. Même chose pour des pré-revues de code auto­ma­tiques.

Ces revues de code auto­ma­tiques peuvent tenter de quali­fier les risques et propo­ser de vali­der auto­ma­tique­ment les chan­ge­ments non risqués (après une période où on aura confirmé que l’hu­main n’a en effet jamais eu à redire sur les chan­ge­ments quali­fiés comme non-risqués).

On ajoute des agents qui vont surveiller la qualité de code, la main­te­na­bi­lité, la sécu­rité, la cohé­rence, et qui vont tenter des refac­to­ring auto­ma­tique­ment quand il commence à y avoir trop de dupli­ca­tion ou de complexité. On peut aussi ajou­ter des agents qui vont s’oc­cu­per des montées en version qui ont un impact sur le code. Il y a tant de tâches qui peuvent être auto­ma­ti­sées une fois qu’on a un peu de temps libé­ré…

Bref, si le harnais de test est suffi­sant, ce qui ne tient qu’à nous au niveau des spéci­fi­ca­tions et plans d’im­plé­men­ta­tion vu que désor­mais mettre à jour les tests ne coûte pas forcé­ment cher, on peut commen­cer à penser l’in­dus­tria­li­sa­tion de toute la chaîne.


  1. Pas de juge­ment de valeur. On parle de –1 en terme d’uti­li­sa­tion de l’IA. ↩︎

WCAG3 Contrast as of April 2026

10 avril 2026 à 23:47

For years I have seen people, teams, products, organizations, and projects promoting APCA contrast as the WCAG3 color contrast algorithm. In many of those cases, those same actors have suggested dismissing the contrast algorithm in WCAG2.

This kind of problematic advice happened so often that I started filing issues with tool makers to remove APCA, as with this May 2024 Chromium issue.

In January 2025 I saw a post promoting that advice, which would create legal risk for anyone following it. You can see my original 2025 response on Mastodon and the same post on Bluesky, where the creator of APCA also weighed in. Read those to ensure you aren’t just taking my word for it.

Current Situation

Here is the most current (as of this writing) contrast ratio algorithm in WCAG3 with the salient bit highlighted:

contrast ratio test Exploratory

meeting a sufficient level of contrast between two colors using the relationship of hue, saturation, and lightness values

Editor’s note

The contrast algorithm used in WCAG 3 is yet to be determined.

APCA was marked for removal in early 2023:

Exploratory content that does not gain WG support to proceed to the next stage within 6 months is automatically removed in the WCAG 3 development process. We still hope the promising contrast work will continue to mature for potential later inclusion.

As with other WCAG3 ideas that did not get working group support, the working group pulled it from the July 2023 WCAG3 working draft. APCA was only ever exploratory, and the W3C’s July 2023 update explained removal of exploratory items. The APCA creator’s response to Michael Cooper’s comment acknowledged that APCA versions in the draft were all early versions that were very obsolete (emphasis theirs).

I have no idea if APCA, whatever version, will come back to WCAG3.

What to Do?

The W3C logo with a frog-headed eyedropper over it. You can still use APCA (whatever version). If you do, limit your risk by taking one of these approaches:

  • Choose colors that also conform to WCAG2 contrast requirements; or
  • If you pick colors that fail WCAG2 contrast requirements, document it and have a ready response should you receive a drive-by lawsuit from a bad actor using an automated checker to find a contrast violation (assuming your attorney lets you do this).

I am still not a (bird) lawyer.

In the meantime, WCAG3 is years away from being done, perhaps 2030 at the soonest. Any contrast algorithm it picks won’t be final until at least then. But if you like whatever is proposed and want to use it before 2030, then probably refer to my two approaches above.

Accessibilité d'abord

10 avril 2026 à 14:00

Une des motivations à reprendre ce carnet, c'était de proposer une accessibilité exemplaire de tous les contenus.

Enlever les styles de présentation, c'est rendre visibles l'ordre de lecture, la structure de page, l'ordre de tabulation et les intitulés de liens.

Ça m'a aidé à corriger la hiérarchie des titres, éparses et inégales entre les textes produits en vingt ans (!). Mais aussi à sectionner et à étiqueter chacune des zones.

Eleventy / Build Awesome propose deux mécanismes pour se brancher sur le contenu :

De quoi ajouter automatiquement des attributs aux liens, images ou autre qui seraient fastidieux à faire à la main.

❌